
容器与云原生 / 系统课时
排查新版本反复重启
排查新版本反复重启
新版本 Pod 在滚动发布中反复重启时,先确认“谁在重启、为什么退出”,再区分应用崩溃、OOM、容器创建失败和健康探针误杀。定位顺序正确,才能避免盲目调大资源或探针阈值,并尽快恢复新副本 Ready 与 rollout 推进。
学习目标
- 根据 Pod 状态、上一次退出原因、日志和事件区分常见重启根因
- 判断
startupProbe、livenessProbe和readinessProbe对发布过程的不同影响 - 修复后验证重启计数稳定、新副本持续 Available 且 rollout 完成
先读取上一次退出原因
不要先改探针或资源限制。CrashLoopBackOff 只是 kubelet 对容器反复启动失败后的退避状态,不是根因。先读取 Pod 状态、上一次终止信息、事件和前一个容器实例的日志。
kubectl get pods -n app -l app=web
kubectl describe pod <ID> -n app
kubectl logs <ID> -n app --previous
预期结果会给出故障 Pod 的重启次数和上一次退出线索,例如:
Last State:     Terminated
Reason:         Error
Exit Code:      1
Restart Count:  <VALUE>
<ID> 替换为故障 Pod 名称,<VALUE> 会随重启次数变化。--previous 很关键:当前容器已经重新启动时,真正导致上一次退出的应用日志通常只能从前一个容器实例读取。多容器 Pod 还应通过 -c <CONTAINER> 明确目标容器。
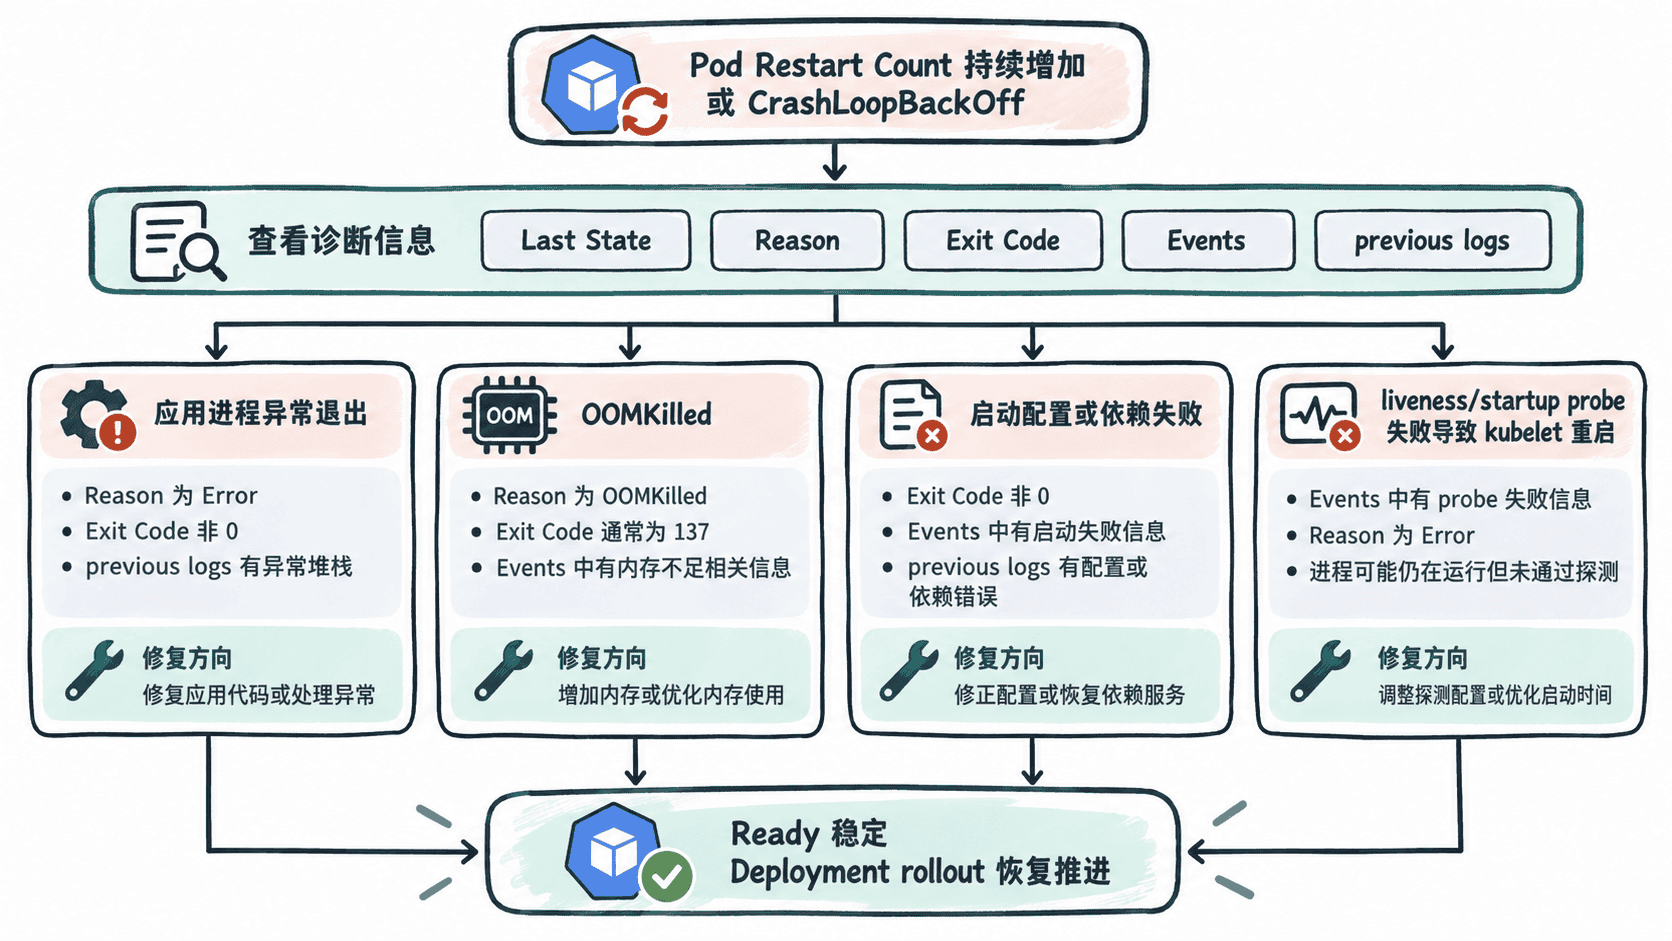
区分崩溃、OOM 与容器创建失败
如果 Last State 的 Reason 是 Error,结合退出码和 --previous 日志检查未捕获异常、配置解析失败或依赖初始化失败。此类问题通常需要修复应用或配置,连续执行 rollout restart 不会改变根因。
若看到 OOMKilled,说明容器进程因内存不足被终止。不要只看 137 退出码就下结论,应优先以终止原因、资源限制和节点内存压力交叉验证。下面的 JSONPath 会逐个容器读取上一次终止原因与内存 limit,避免固定使用 containerStatuses[0] 误判多容器 Pod。
kubectl get pod <ID> -n app -o jsonpath='{range .status.containerStatuses[*]}{.name}{"\t"}{.lastState.terminated.reason}{"\n"}{end}'
kubectl get pod <ID> -n app -o jsonpath='{range .spec.containers[*]}{.name}{"\t"}{.resources.limits.memory}{"\n"}{end}'
预期输出可能类似:
web    OOMKilled
web    <VALUE>
第二行的 <VALUE> 是当前内存限制,未配置 limit 时可能为空。若 limit 明显过低,应结合实际内存使用调整;若新版本内存持续增长,则应先修复泄漏或峰值问题,单纯大幅提高 limit 只会推迟再次 OOM。
如果 Pod 显示 CreateContainerConfigError、ImagePullBackOff 或挂载相关事件,而重启计数并未持续增长,就不是“进程启动后崩溃”这一类问题。此时重点检查镜像、启动命令、Secret、ConfigMap 和 Volume 事件。
判断是不是健康探针误杀
应用启动较慢时,如果 livenessProbe 太早开始检查,kubelet 可能在初始化完成前反复杀死容器。典型证据是应用每次都启动到相近阶段后终止,同时 Events 中持续出现 liveness 失败与 Killing。
kubectl describe pod <ID> -n app预期结果在误杀场景中可能包含:
Warning  Unhealthy  <TIME>  kubelet  Liveness probe failed: <VALUE>
Normal   Killing    <TIME>  kubelet  Container web failed liveness probe, will be restarted
<TIME> 和 <VALUE> 是动态内容。对于启动耗时长、但启动完成后健康状态稳定的应用,优先配置 startupProbe 覆盖启动窗口,而不是无限放大 liveness 的失败阈值。
三类探针职责要分开:readinessProbe 失败不会触发容器重启,正常情况下会让 Pod 暂停承接 Service 流量;livenessProbe 连续失败达到阈值会触发重启;配置 startupProbe 后,在它成功前,liveness 和 readiness 检查不会接管启动阶段。把 readiness 问题误当成崩溃,或让 liveness 过早介入,都会让发布判断走错方向。
判断重启如何影响 rollout
Deployment 只有在新 Pod 达到 Ready,并满足 minReadySeconds(若配置)后,才会把它计入 Available。新 Pod 反复重启或持续不 Ready,会让 rollout 停在新旧 ReplicaSet 并存状态;实际可用容量还受 maxUnavailable 与 maxSurge 约束。
kubectl rollout status deployment/web -n app
kubectl get deployment web -n app
kubectl get rs -n app -l app=web
预期结果可能类似:
Waiting for deployment "web" rollout to finish: 1 of 3 updated replicas are available...具体副本数会随 Deployment 配置变化。若新模板没有修复,连续执行 kubectl rollout restart 只会生成新一轮相同故障的 Pod,不应作为恢复手段。
修复后验证稳定性
修复应用、资源配置或探针后,不要只看一次 READY 1/1。应持续观察足以覆盖原故障触发时间的窗口,确认 RESTARTS 不再增长,再检查 rollout 是否完成。
kubectl get pods -n app -l app=web
kubectl rollout status deployment/web -n app --timeout=5m
预期结果是新 Pod 持续保持 Ready、重启计数稳定,最终得到:
deployment "web" successfully rolled out如果 Pod 只是短暂 Ready 后再次重启,仍不能视为恢复。最终验收应同时确认前一个容器实例不再出现新的异常退出、探针失败事件停止增长,并且 Deployment 的 Available 副本数恢复到期望值。