
容器与云原生 / 系统课时
排查容量不足与 Pending Pod
排查容量不足与 Pending Pod
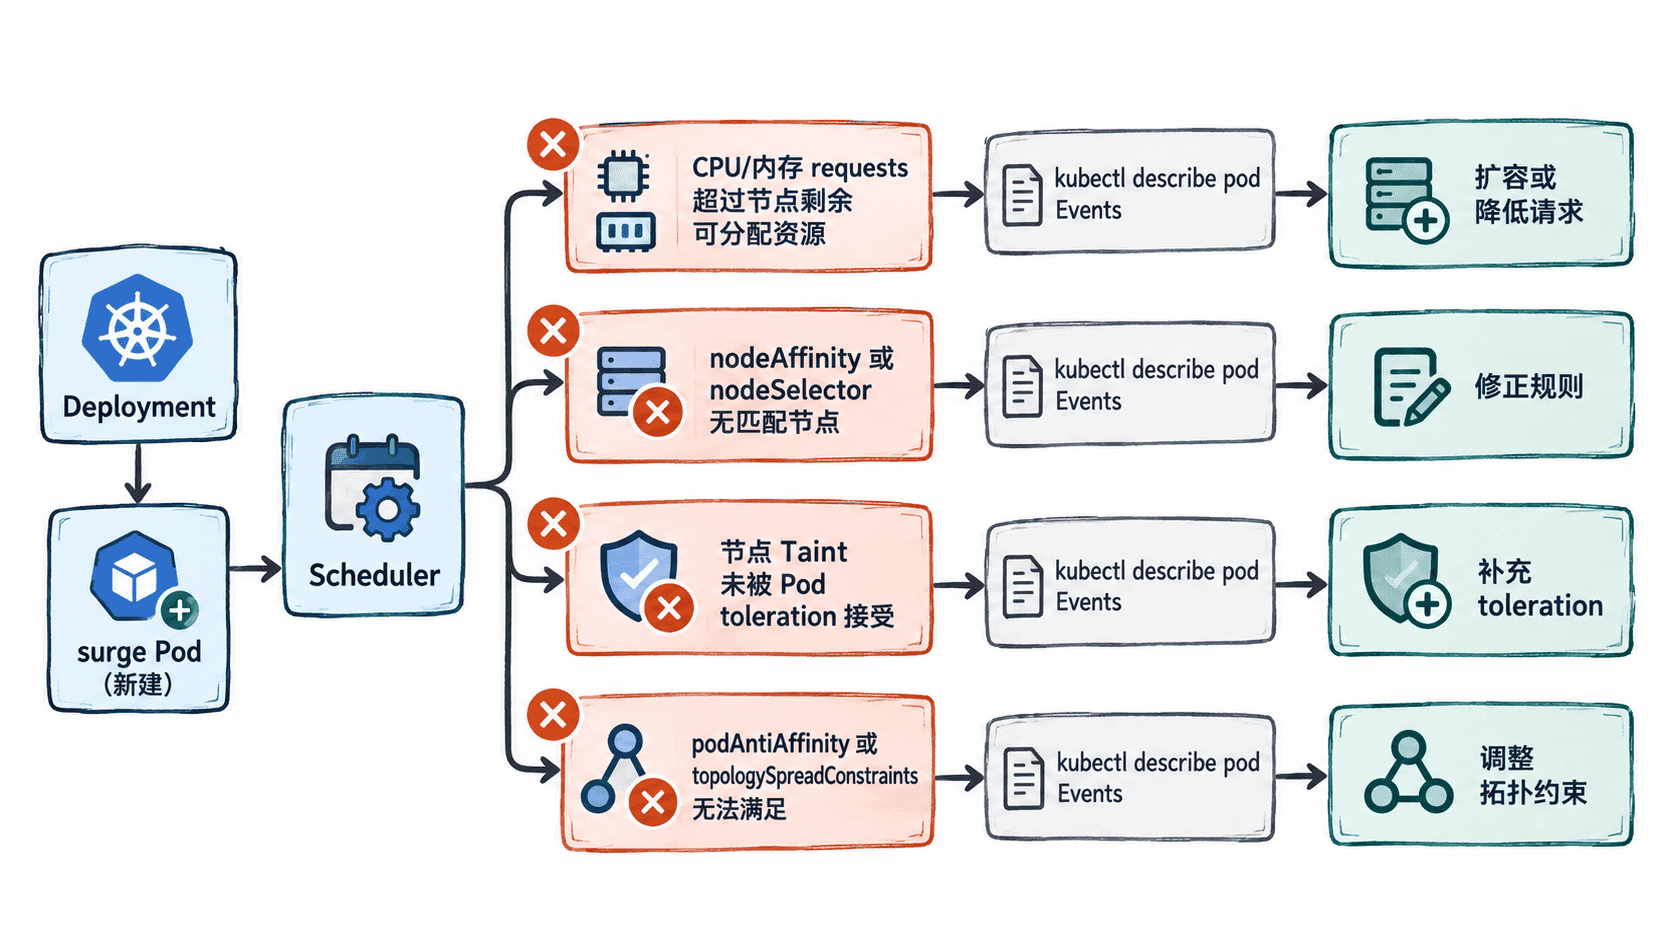
滚动发布时,新版本 Pod 长时间停在 Pending,通常不是 Deployment 控制器失效,而是 surge 副本创建后无法通过调度。排查的关键是先读取调度器给出的拒绝理由,再判断究竟是资源容量、节点约束还是拓扑规则阻止了新 Pod 落位。
学习目标
- 根据 Pod 事件快速识别调度失败的直接原因
- 区分资源不足、亲和性、污点和拓扑约束导致的 Pending
- 判断滚动发布参数与集群可调度容量是否匹配
从 Pending Pod 的调度事件开始
Deployment 使用 RollingUpdate 时,maxSurge 允许在期望副本数之外临时创建新 Pod。只要这些 Pod 已经被 API Server 创建但调度器找不到合适节点,它们就会保持 Pending,旧副本也可能因为新副本迟迟无法 Ready 而不能继续缩减。
先找出 Pending Pod,再查看其调度事件:
kubectl get pods -l app=web -o wide
kubectl describe pod <POD_NAME>
预期输出中应重点查看 Events,实际节点数量和原因会随集群变化:
Events:
  Type     Reason            Age     From               Message
  ----     ------            ----    ----               -------
  Warning  FailedScheduling  <TIME>  default-scheduler  0/<N> nodes are available: <REASONS>
FailedScheduling 后面的 <REASONS> 是第一手证据。不要先通过重启 Deployment 或修改副本数试错,因为这些操作可能掩盖真正的容量或约束问题。
判断是不是资源请求超过可调度容量
调度器依据 Pod 的 requests 判断节点是否有足够资源,而不是依据应用此刻真实用了多少 CPU 或内存。即使节点监控看起来还有空闲资源,只要剩余可分配额度无法容纳新 Pod 的 requests,调度仍会失败。
查看 Pod 请求值和节点可分配资源:
kubectl get pod <POD_NAME> -o jsonpath='{range .spec.containers[*]}{.name}{" cpu="}{.resources.requests.cpu}{" memory="}{.resources.requests.memory}{"\n"}{end}'
kubectl describe nodes
预期结果可能类似:
web cpu=500m memory=512Mi

Allocated resources:
  Resource           Requests
  --------           --------
  cpu                <VALUE>
  memory             <VALUE>
如果事件中出现 Insufficient cpu 或 Insufficient memory,应同时检查单个 Pod 请求值、节点剩余容量以及 maxSurge 带来的临时峰值。比如期望副本为 10、maxSurge: 30% 时,发布过程中最多可能需要同时容纳 13 个 Pod;集群只能刚好承载原来的 10 个副本时,新 Pod 就可能无处调度。
检查节点选择、亲和性和污点
资源足够并不代表节点可用。nodeSelector、required 类型的 nodeAffinity 会先缩小候选节点集合;节点上的 Taint 又可能继续排除没有匹配 toleration 的 Pod。
可以把 Pod 调度相关配置一次性取出:
kubectl get pod <POD_NAME> -o yaml
kubectl get nodes -o custom-columns='NAME:.metadata.name,TAINTS:.spec.taints'
预期结果中需要核对这些字段,具体值因工作负载而异:
spec:
  nodeSelector: ...
  affinity: ...
  tolerations: ...

NAME       TAINTS
<NODE>     <VALUE>
若事件提示 node(s) didn't match Pod's node affinity/selector,应确认目标标签是否真实存在于节点上。若提示 node(s) had untolerated taint,则检查该污点是否本就应该阻止此工作负载,而不是机械添加 toleration 绕过隔离策略。
检查 Pod 反亲和与拓扑分布约束
高可用工作负载常要求副本分散到不同节点或可用区。podAntiAffinity 和 topologySpreadConstraints 能避免副本集中,但当节点或故障域数量不足时,也会让 surge Pod 无法找到合法位置。
查看当前副本分布及其所在拓扑域:
kubectl get pods -l app=web -o wide
kubectl get nodes -L topology.kubernetes.io/zone,kubernetes.io/hostname
预期结果应能把每个 Pod 映射到节点,并看到节点对应的 zone 或 hostname:
NAME          READY   STATUS    NODE
<POD_NAME>    1/1     Running   <NODE>

NAME          ZONE       HOSTNAME
<NODE>        <ZONE>     <HOSTNAME>
如果使用 DoNotSchedule 的 topology spread 约束,调度器必须满足指定的 maxSkew;required 反亲和规则同样不能为了完成发布而被调度器自动放宽。此时应判断约束是否符合真正的故障域目标,或者集群是否缺少足够节点,而不是仅关注 Pod 本身。
验证修复后滚动发布继续推进
修复容量或调度约束后,观察 Pending Pod 是否成功调度,并确认 Deployment 的可用副本逐步恢复:
kubectl get pods -l app=web -w
kubectl rollout status deployment/web --timeout=5m
预期结果是在新 Pod 从 Pending 转为 Running、Ready 后,滚动发布继续完成:
<POD_NAME>   0/1   Pending   0   <TIME>
<POD_NAME>   0/1   Running   0   <TIME>
<POD_NAME>   1/1   Running   0   <TIME>
deployment "web" successfully rolled out
如果仍然 Pending,应重新读取最新 FailedScheduling 事件,因为解决一个限制后,调度器可能暴露下一层限制。可靠的排查顺序始终是先看调度事件,再沿资源、节点约束和拓扑约束逐层缩小范围。