
容器与云原生 / 系统课时
让应用正确处理 SIGTERM
让应用正确处理 SIGTERM
Pod 被删除、滚动更新替换或节点驱逐时,容器主进程通常会先收到 SIGTERM,而不是立刻被强制结束。本课用一个可运行的 Go HTTP 服务演示如何停止接收新连接、等待在途请求完成,并把退出预算与 Kubernetes 的终止宽限期对齐。
学习目标
- 理解 Pod 终止期间
SIGTERM、端点摘流与进程退出之间的关系 - 用 Go 实现有超时边界的 HTTP 优雅关闭
- 在 Kubernetes 中验证在途请求能在正常终止窗口内完成
收到 SIGTERM 后的正确顺序
收到 SIGTERM 后,应用不应立即调用 os.Exit。更安全的顺序是停止接受新连接或新任务,等待已经进入应用的工作完成,再关闭数据库连接、消息消费者等后台资源,最后让主进程正常退出。
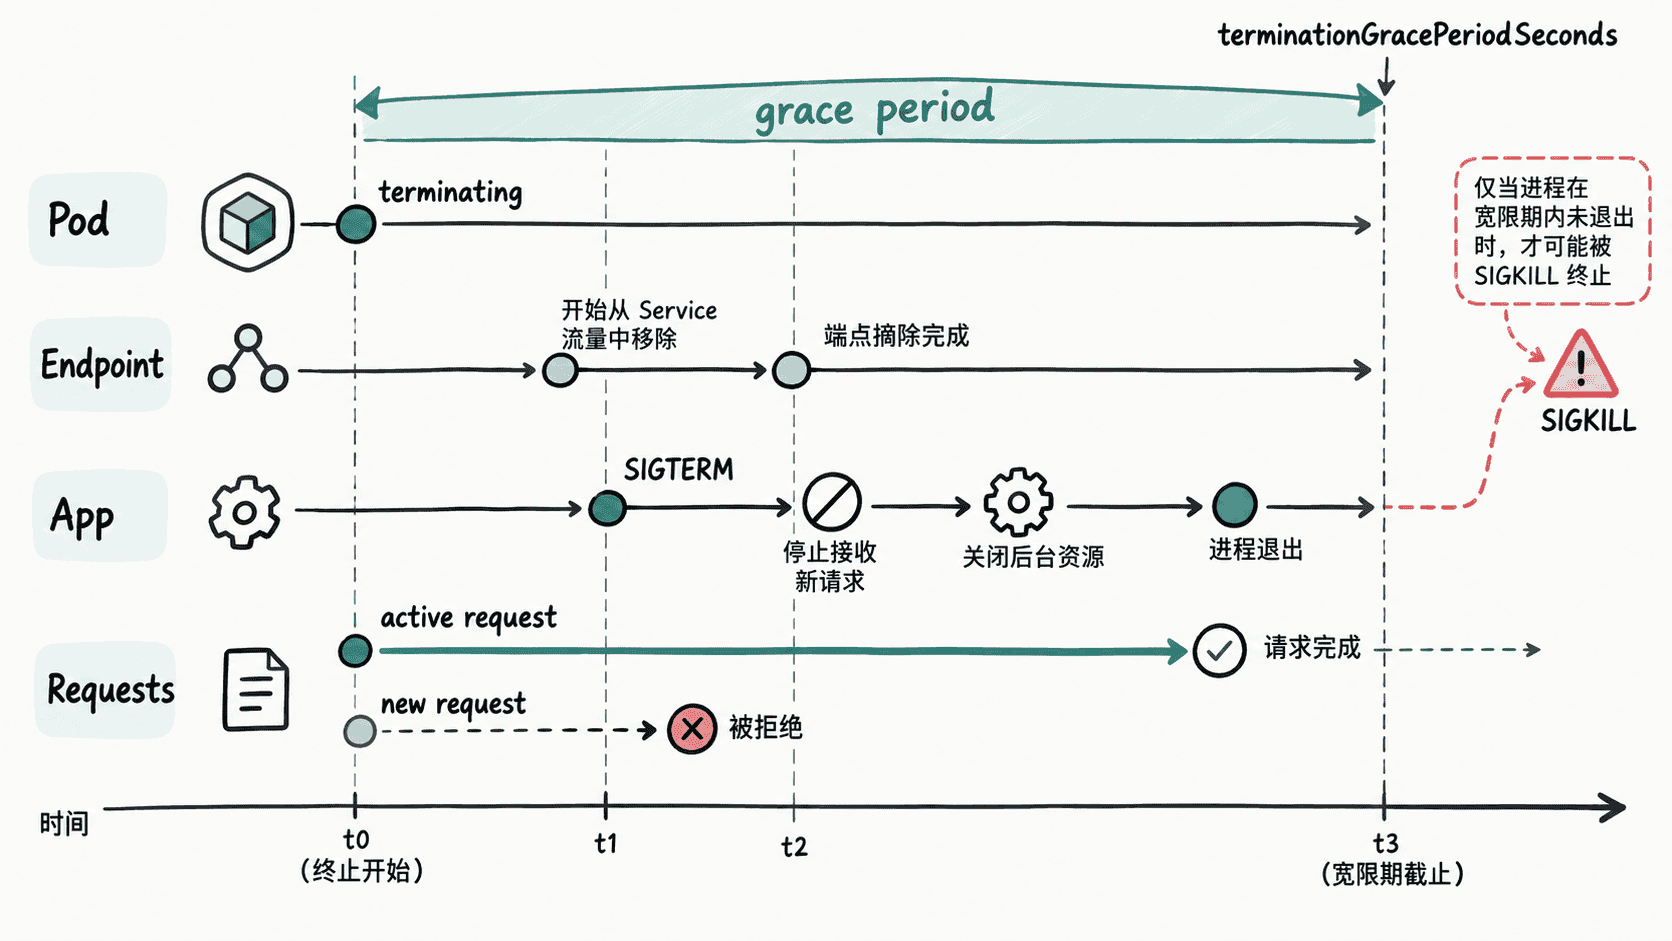
Pod 进入终止流程时,Kubernetes 会更新端点状态,使正常遵循这些状态的负载均衡链路逐步停止把新流量送往正在终止的 Pod;但控制面传播、代理更新和已有连接都需要时间。因此“开始摘流”不能替代应用自身的优雅关闭。
用 Go 实现 HTTP 优雅关闭
下面的主示例使用 signal.NotifyContext 监听 SIGTERM。信号到达后调用 http.Server.Shutdown,它会关闭监听器、处理空闲连接,并等待活跃处理器返回;若超过 10 秒仍未完成,则主动关闭剩余连接。
package main

import (
    "context"
    "errors"
    "fmt"
    "log"
    "net/http"
    "os"
    "os/signal"
    "syscall"
    "time"
)

func main() {
    mux := http.NewServeMux()
    mux.HandleFunc("/work", func(w http.ResponseWriter, r *http.Request) {
        time.Sleep(3 * time.Second)
        fmt.Fprintln(w, "done")
    })

    server := &http.Server{
        Addr:    ":8080",
        Handler: mux,
    }

    signalCtx, stop := signal.NotifyContext(
        context.Background(),
        syscall.SIGTERM,
        os.Interrupt,
    )
    defer stop()

    go func() {
        log.Println("listening on :8080")
        if err := server.ListenAndServe(); err != nil && !errors.Is(err, http.ErrServerClosed) {
            log.Fatalf("listen failed: %v", err)
        }
    }()

    <-signalCtx.Done()
    log.Println("shutdown signal received")

    // 退出预算必须小于容器剩余的 termination grace period。
    shutdownCtx, cancel := context.WithTimeout(context.Background(), 10*time.Second)
    defer cancel()

    if err := server.Shutdown(shutdownCtx); err != nil {
        log.Printf("graceful shutdown timed out: %v", err)
        _ = server.Close()
    }

    log.Println("server stopped")
}
在 Linux 或 macOS 上可用下面这组命令完成一次“请求执行中发送 SIGTERM”的验证。脚本先编译并启动服务,再发起一个持续约 3 秒的请求,1 秒后向服务进程发送终止信号。
go build -o ./graceful-server main.go
./graceful-server >./server.log 2>&1 &
SERVER_PID=$!

sleep 1
curl -sS http://127.0.0.1:8080/work >./work.out &
WORK_PID=$!

sleep 1
kill -TERM "$SERVER_PID"

wait "$WORK_PID"
wait "$SERVER_PID"

cat ./work.out
cat ./server.log
预期输出如下,日志时间会因运行环境不同而变化:
done
<TIME> listening on :8080
<TIME> shutdown signal received
<TIME> server stopped
关键验证点是 /work 已经进入处理后仍返回 done。如果应用收到信号后直接退出,客户端更可能看到连接中断,而不会得到完整响应。
把退出预算交给 Kubernetes 管理
容器中的应用最好直接作为主进程运行,避免再套一层不会正确转发信号的 shell。下面是片段示例,依赖镜像已经包含 /app/server;同时给 Pod 预留 15 秒终止宽限期,使应用内部 10 秒的关闭超时有余量。
spec:
  terminationGracePeriodSeconds: 15
  containers:
    - name: app
      image: example/app:1.0
      command: ["/app/server"]
该配置生效后,可以删除一个测试 Pod,并观察应用日志是否先记录收到终止信号,再记录服务停止。实际 Pod 名称会不同。
kubectl delete pod <POD_NAME>预期输出:
pod "<POD_NAME>" deleted如果日志中从未出现终止信号记录,应优先检查容器入口命令、PID 1 是否由应用进程承担,以及入口脚本是否正确使用 exec 转交信号。若配置了 preStop,还要注意它与应用关闭共享同一段终止宽限时间。
后台任务也要进入同一退出流程
http.Server.Shutdown 只负责 HTTP 服务本身。应用如果还有消息消费、定时任务或异步 worker,需要让这些组件也响应同一个终止上下文:停止领取新工作,等待当前工作结束,并在超时后执行明确的兜底关闭。
可靠的退出流程最终应满足三个条件:不再接收新的长期工作;已经开始的工作有明确等待上限;资源释放完成后主进程才退出。这样 terminationGracePeriodSeconds 才是可计算的优雅退出预算,而不是单纯等待 SIGKILL 的倒计时。