
容器与云原生 / 系统课时
识别集群容量对发布的限制
识别集群容量对发布的限制
滚动更新能否继续,不只取决于 Deployment 策略,还取决于新 Pod 是否能被调度。本课用“新副本长期 Pending”的场景,区分 maxSurge 的控制器上限、节点实际可调度容量与 Terminating Pod 的额外占用,并建立从事件到发布状态的定位顺序。
学习目标
- 判断
maxSurge带来的新 Pod 是否具备可调度条件 - 从
FailedScheduling事件区分资源不足、节点约束与污点问题 - 解释调度失败为何会让滚动更新停滞,并选择合适的处理方式
分清策略上限与实际容量
假设 Deployment 期望 4 个副本,配置 maxSurge: 1、maxUnavailable: 0。更新开始时,控制器可以先把新 ReplicaSet 扩到 1 个副本;在 4 个旧副本仍保持可用的阶段,这个新 Pod 要成功调度,候选节点必须能满足它的资源请求和调度约束。这里需要的是“能调度这一个新 Pod 的容量”,而不是 maxSurge 自动提供了第 5 份资源。
maxSurge 描述的是滚动更新时控制器允许额外创建多少 Pod,并不是节点资源承诺。还要注意,旧 Pod 被缩容后可能在 Terminating 状态继续存在并消耗 CPU、内存等资源,因此实际看到的 Pod 对象数或瞬时资源占用可能暂时超过 replicas + maxSurge。排查容量时不能只数 Pod,还要结合 Pod 阶段、终止状态与节点可分配资源判断。
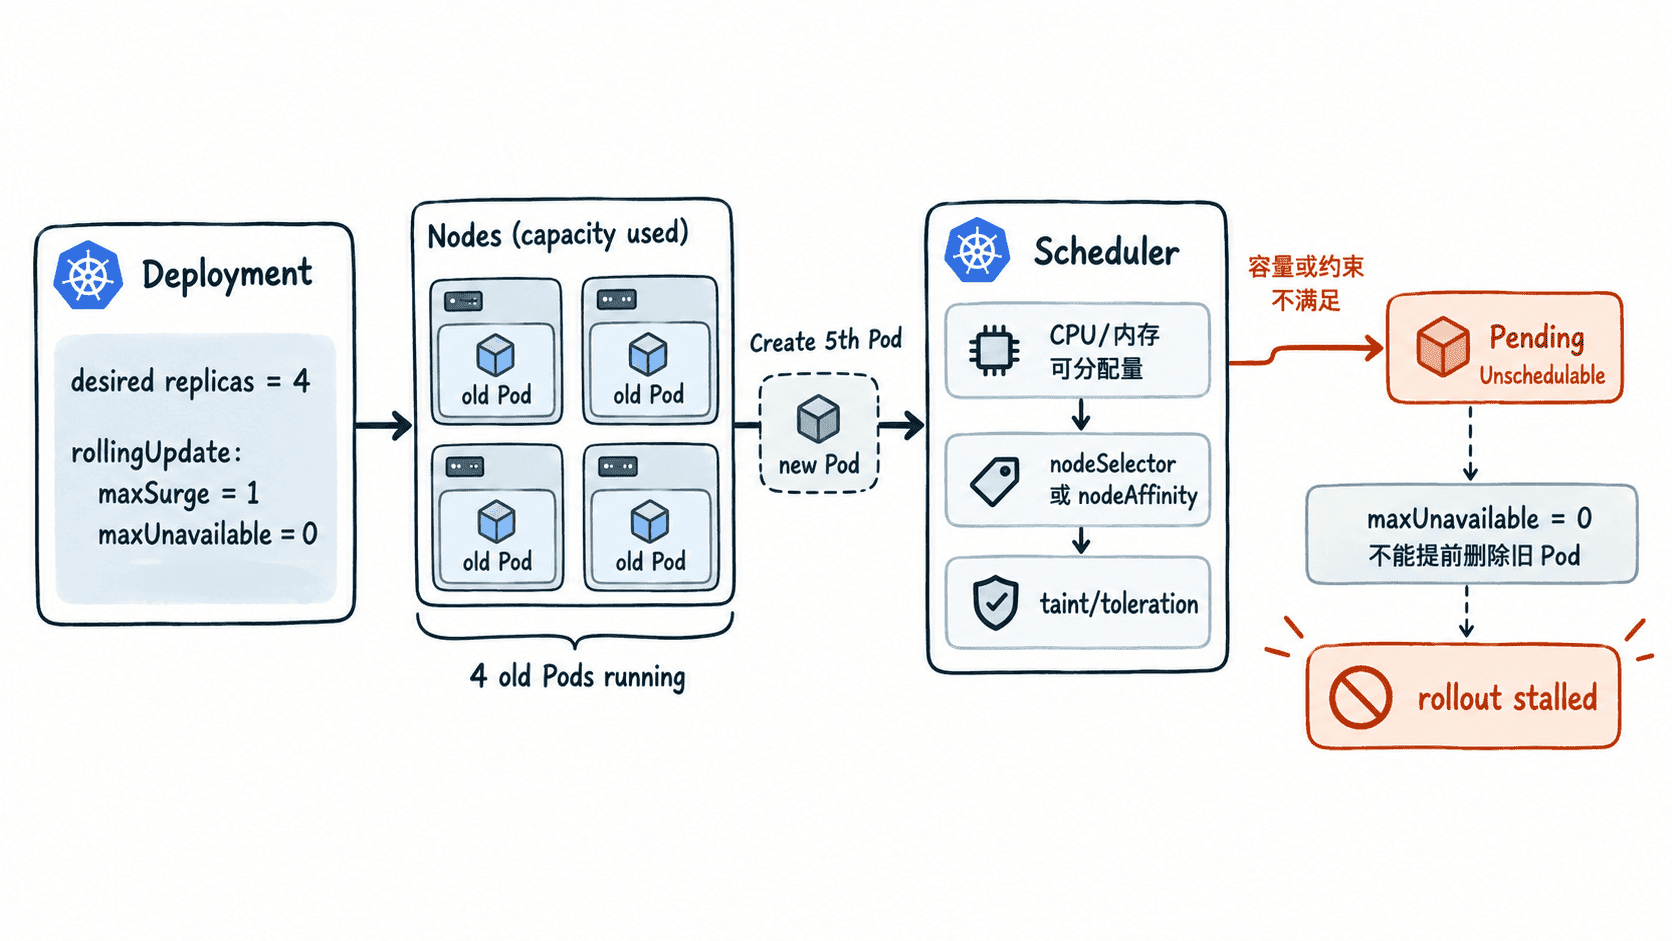
当新 Pod 因容量或约束无法调度时,maxUnavailable: 0 又要求更新期间不能主动降低可用副本下限。于是旧副本不能先被正常缩掉,新副本也无法进入 Ready,滚动更新就会停在等待状态。
从 Pending Pod 获取调度证据
先确认新 ReplicaSet 已经创建 Pod,并定位处于 Pending 的对象。下面假设 Deployment 与 Pod 标签都使用 app=web。
kubectl get deployment web
kubectl get pods -l app=web -o wide
PENDING_POD="$(kubectl get pods -l app=web --field-selector=status.phase=Pending -o jsonpath='{.items[0].metadata.name}')"
kubectl describe pod "$PENDING_POD"
预期输出
NAME   READY   UP-TO-DATE   AVAILABLE   AGE
web    4/4     1            4           <TIME>

NAME                    READY   STATUS    RESTARTS   AGE      IP       NODE
web-<ID>-<ID>            1/1     Running   0          <TIME>   <IP>     <ID>
web-<ID>-<ID>            1/1     Running   0          <TIME>   <IP>     <ID>
web-<ID>-<ID>            1/1     Running   0          <TIME>   <IP>     <ID>
web-<ID>-<ID>            1/1     Running   0          <TIME>   <IP>     <ID>
web-<ID>-<ID>            0/1     Pending   0          <TIME>   <none>   <none>

Events:
  Type     Reason            Age     From               Message
  Warning  FailedScheduling  <TIME>  default-scheduler  0/<VALUE> nodes are available: <VALUE> Insufficient cpu.
名称、时间、IP、节点数等会随环境变化。关键证据不是 Pending 本身,而是 FailedScheduling 的原因;如果没有这类事件,还应继续检查 PVC、调度门控等其他 Pending 原因,不能直接归因于“集群没资源”。
区分资源与调度约束
最常见的是资源请求不足。Scheduler 根据 Pod 的 requests 与节点可分配资源进行调度判断,而不是根据监控里此刻的 CPU、内存使用率。节点看起来“很空”,也可能因为已承诺的 requests 较高而无法再接纳新 Pod。
第二类是节点约束,例如 nodeSelector、required 类型的 node affinity 或强制拓扑约束。集群总体仍有空闲资源,但符合条件的节点已经没有足够容量时,对这个工作负载而言仍然不可调度。第三类是污点:节点存在 NoSchedule 污点而 Pod 没有匹配的 toleration 时,这些节点同样不会成为候选节点。
可以查看所有节点的资源、标签和污点,再和 Pod 的调度条件逐项对照。
kubectl get nodes --show-labels
kubectl describe nodes
预期结果
NAME   STATUS   ROLES    AGE      VERSION   LABELS
<ID>   Ready    <none>   <TIME>   <VALUE>   <VALUE>

Allocatable:
  cpu:                <VALUE>
  memory:             <VALUE>
Allocated resources:
  Resource           Requests      Limits
  cpu                <VALUE>       <VALUE>
  memory             <VALUE>       <VALUE>
Taints:              <VALUE>
实际输出会按节点重复这些字段。重点检查 Allocatable、Allocated resources、Taints 与标签;节点为 Ready 只说明节点健康,不代表它一定满足这个 Pod 的资源与调度条件。
把调度失败映射回发布状态
确认调度证据后,再观察 Deployment 的副本统计与条件。这样可以把“为什么 Pod 起不来”和“为什么 rollout 不继续”连接起来,而不是用 Deployment 状态反推根因。
kubectl get deployment web -o jsonpath='replicas={.status.replicas} updated={.status.updatedReplicas} available={.status.availableReplicas}{"\n"}'
kubectl get deployment web -o jsonpath='{range .status.conditions[*]}{.type}{"\t"}{.status}{"\t"}{.reason}{"\n"}{end}'
预期输出
replicas=5 updated=1 available=4
Available    True     MinimumReplicasAvailable
Progressing  <VALUE>  <VALUE>
在上述 4 副本场景中,状态收敛后通常能看到 1 个 updated 副本但可用副本仍为 4;若持续没有进展并超过 .spec.progressDeadlineSeconds,Progressing 可能变为 False,原因为 ProgressDeadlineExceeded。这个条件只说明发布超时,没有证明资源不足,根因仍以 Pod 调度事件为准。
选择不会隐藏问题的处理方式
确认容量限制后,优先增加该工作负载真正可使用的节点容量,确保集群自动扩容器具备扩容条件,或修正不必要的节点选择、亲和性与污点限制。只有在 requests 明显高于真实需求且有监控依据时才应调整它;盲目下调 requests 可能把“无法调度”变成运行期资源争抢。
如果集群确实无法承载 surge,而业务允许更新期间少一个可用副本,可以把策略改为先释放一个旧副本再创建新副本。
kubectl patch deployment web --type merge -p '{"spec":{"strategy":{"type":"RollingUpdate","rollingUpdate":{"maxSurge":0,"maxUnavailable":1}}}}'预期输出
deployment.apps/web patched这项调整用可用性下限换取调度空间,并不会增加集群资源。发布容量治理应同时核对三件事:控制器允许创建多少新副本、这些新 Pod 在候选节点上是否真的可调度,以及终止中的旧 Pod 是否仍占用资源;只有三者都满足,滚动更新策略才会按预期推进。