
容器与云原生 / 系统课时
排查滚动更新迟迟不完成
排查滚动更新迟迟不完成
Deployment 长时间停在滚动更新中时,不要直接删除 Pod 或重新发布。应先确认卡在哪个副本,再沿调度、镜像、探针和旧 Pod 终止链路收集证据,从最接近异常状态的位置定位真正阻塞点。
学习目标
- 根据 Deployment、ReplicaSet 和 Pod 状态判断滚动更新停在哪一层
- 按调度、镜像、探针和终止阻塞的顺序定位常见根因
- 修复问题后验证 Deployment 是否恢复并完成滚动更新
先确认更新到底卡在哪里
第一步不是进入容器看日志,而是确认 Deployment 是否仍在推进,以及期望副本、更新副本、可用副本之间差了多少。这样可以先判断问题属于“新 Pod 起不来”还是“旧 Pod 退不掉”。
kubectl get deployment web-api -n production
kubectl rollout status deployment/web-api -n production --timeout=30s
kubectl get rs -n production -l app=web-api
kubectl get pods -n production -l app=web-api -o wide
预期输出可能类似:
NAME      READY   UP-TO-DATE   AVAILABLE   AGE
web-api   3/4     2            3           <TIME>
error: timed out waiting for the condition
NAME                 DESIRED   CURRENT   READY   AGE
web-api-<ID>          2         2         1       <TIME>
web-api-<ID>          2         2         2       <TIME>
NAME                       READY   STATUS             RESTARTS   AGE
web-api-<ID>-<ID>           1/1     Running            0          <TIME>
web-api-<ID>-<ID>           0/1     ImagePullBackOff   0          <TIME>
web-api-<ID>-<ID>           1/1     Running            0          <TIME>
web-api-<ID>-<ID>           1/1     Running            0          <TIME>
Pod 名称、ReplicaSet 标识和时间属于动态值。这里最重要的证据是新 ReplicaSet 已创建两个 Pod,但只有一个 Ready,因此应继续追查异常的新 Pod,而不是先处理健康的旧 Pod。
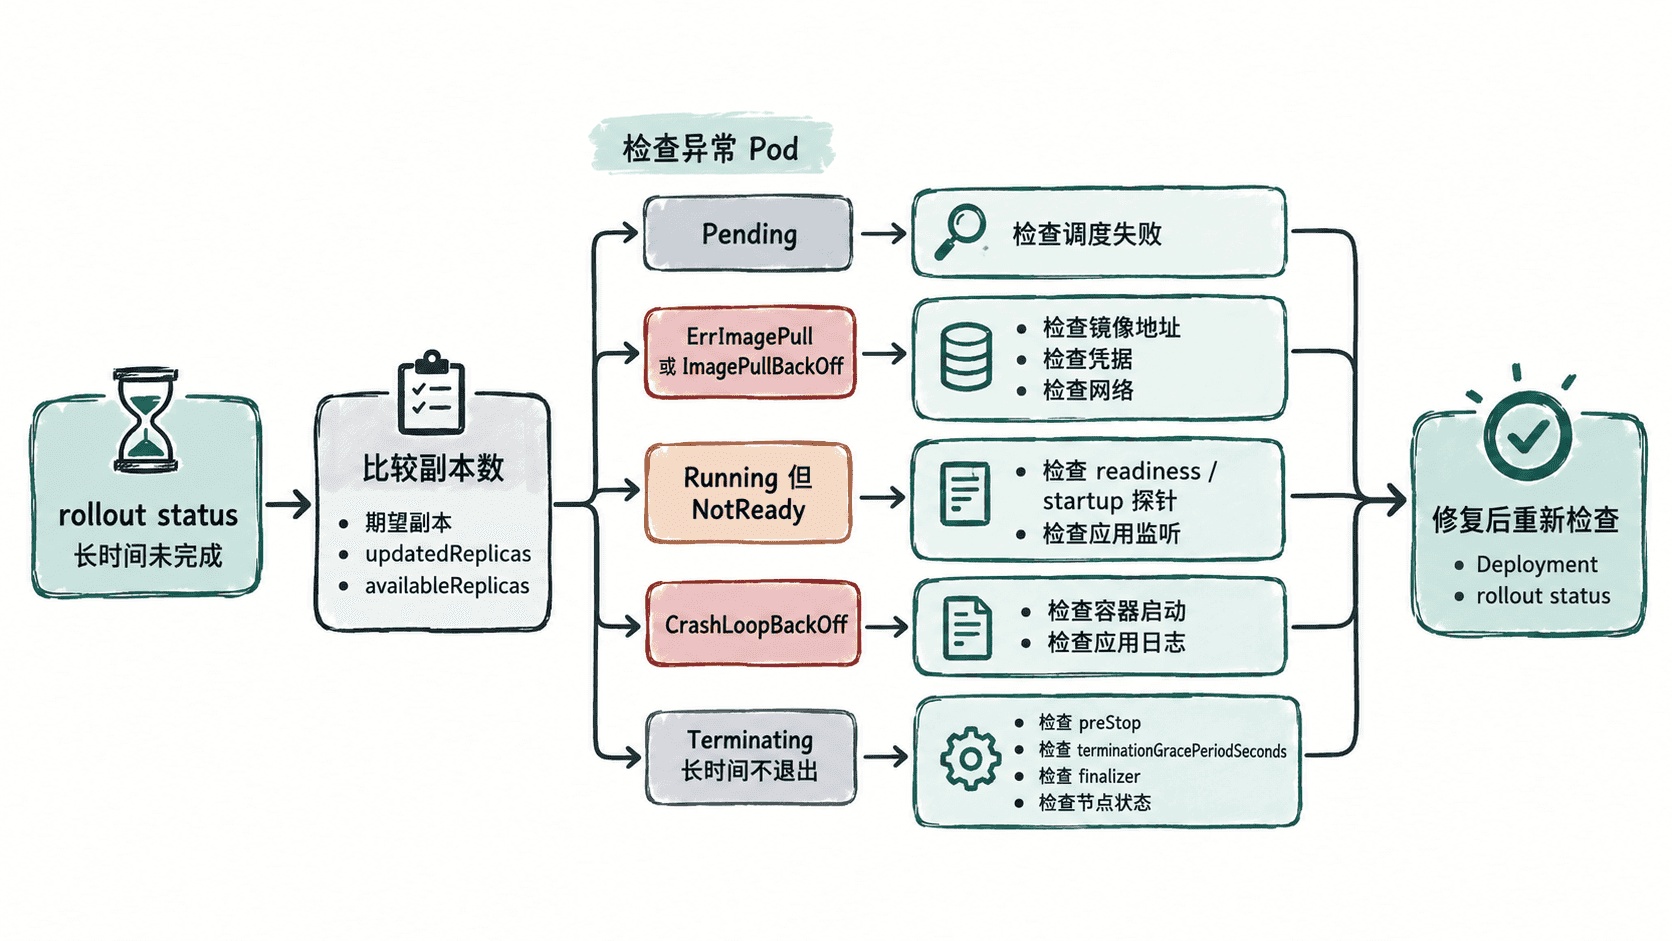
从 Pod 状态选择排查分支
如果异常 Pod 是 Pending,优先读取事件。常见原因包括资源不足、节点选择器不匹配、污点未容忍、PVC 无法绑定或拓扑约束无法满足。此时应用日志通常还不存在,因为容器根本没有启动。
kubectl describe pod <POD_NAME> -n production预期结果中应重点查看 Events:
Events:
  Type     Reason            Age     From               Message
  Warning  FailedScheduling <TIME>  default-scheduler  <MESSAGE>
<MESSAGE> 会随具体故障变化,例如资源不足或节点约束不满足。应根据事件修复调度条件,而不是反复删除 Pod,因为控制器只会创建一个同样无法调度的新 Pod。
如果状态是 ErrImagePull 或 ImagePullBackOff,同样从事件中确认镜像名、仓库访问和 imagePullSecrets。如果 Pod 已经 Running 但 READY 为 0/1,重点转向探针和应用本身。
检查探针是否阻止新副本成为可用状态
Deployment 是否能够继续推进,取决于新 Pod 能否满足 Ready 和 Available 条件。应用已经启动并不代表它通过了 readiness probe;探针路径、端口、启动时间或依赖服务异常,都可能让新 Pod 长时间不进入可用状态。
kubectl describe pod <POD_NAME> -n production
kubectl logs <POD_NAME> -n production --tail=100
典型预期结果可能出现:
Warning Unhealthy <TIME> kubelet Readiness probe failed: HTTP probe failed with statuscode: 503如果应用本身正在正常预热,应评估 startupProbe、initialDelaySeconds 或探针失败阈值是否与真实启动时间匹配;如果接口确实返回 503,则先修复应用或依赖问题,不能通过简单放宽 readiness probe 来掩盖不可用状态。
别忽略迟迟不退出的旧 Pod
有时所有新 Pod 都已经 Ready,但滚动更新仍未结束,此时应检查旧副本是否长期处于 Terminating。常见阻塞包括过长的 preStop、应用未响应终止信号、较大的 terminationGracePeriodSeconds、存储卸载问题或节点失联。
kubectl get pods -n production -l app=web-api
kubectl describe pod <TERMINATING_POD> -n production
预期结果可能看到旧 Pod 长时间停留:
NAME                 READY   STATUS        RESTARTS   AGE
web-api-<ID>-<ID>     1/1     Terminating   0          <TIME>
这时应结合 Pod 配置和节点状态判断是否仍在执行正常优雅退出。只有确认进程已经无法正常退出且业务能够承受强制终止风险时,才考虑进一步的强制删除操作;不能把强删作为常规排障第一步。
修复后验证滚动更新重新推进
完成调度、镜像、探针或终止问题修复后,应再次同时验证 Pod 和 Deployment,而不是只确认某个异常事件消失。
kubectl get pods -n production -l app=web-api
kubectl get deployment web-api -n production
kubectl rollout status deployment/web-api -n production --timeout=120s
预期输出
NAME                       READY   STATUS    RESTARTS   AGE
web-api-<ID>-<ID>           1/1     Running   0          <TIME>
web-api-<ID>-<ID>           1/1     Running   0          <TIME>
web-api-<ID>-<ID>           1/1     Running   0          <TIME>
web-api-<ID>-<ID>           1/1     Running   0          <TIME>
NAME      READY   UP-TO-DATE   AVAILABLE   AGE
web-api   4/4     4            4           <TIME>
deployment "web-api" successfully rolled out
最终应看到期望副本、更新副本和可用副本重新一致,并由 rollout status 确认 Deployment 完成推进。排查过程中始终从控制器状态定位异常副本,再依据 Pod 当前状态选择证据来源,可以避免在日志、节点和配置之间无目的地来回搜索。