
容器与云原生 / 系统课时
避免 livenessProbe 放大故障
避免 livenessProbe 放大故障
livenessProbe 的职责不是判断 Pod 能不能接流量,而是判断容器是否进入只能通过重启恢复的失活状态。把数据库、缓存或下游接口可用性塞进存活探针,会把短暂依赖故障放大成重启、冷启动和容量下降。本课把存活检查收敛到真正需要重启的故障。
学习目标
- 区分 liveness、readiness 与 startup 三类探针的职责边界
- 识别依赖故障触发 liveness 失败后的重启风暴链路
- 配置并验证一个只检测进程自身状态的
livenessProbe
为什么错误的 livenessProbe 会制造重启风暴
假设应用的 /health/live 每次都查询数据库。数据库抖动 30 秒后,多个副本几乎同时返回失败;当连续失败达到 failureThreshold,各节点上的 kubelet 会重启对应容器。数据库即使很快恢复,应用仍要重新加载配置、建立连接池并预热缓存,可用容量反而继续下降。
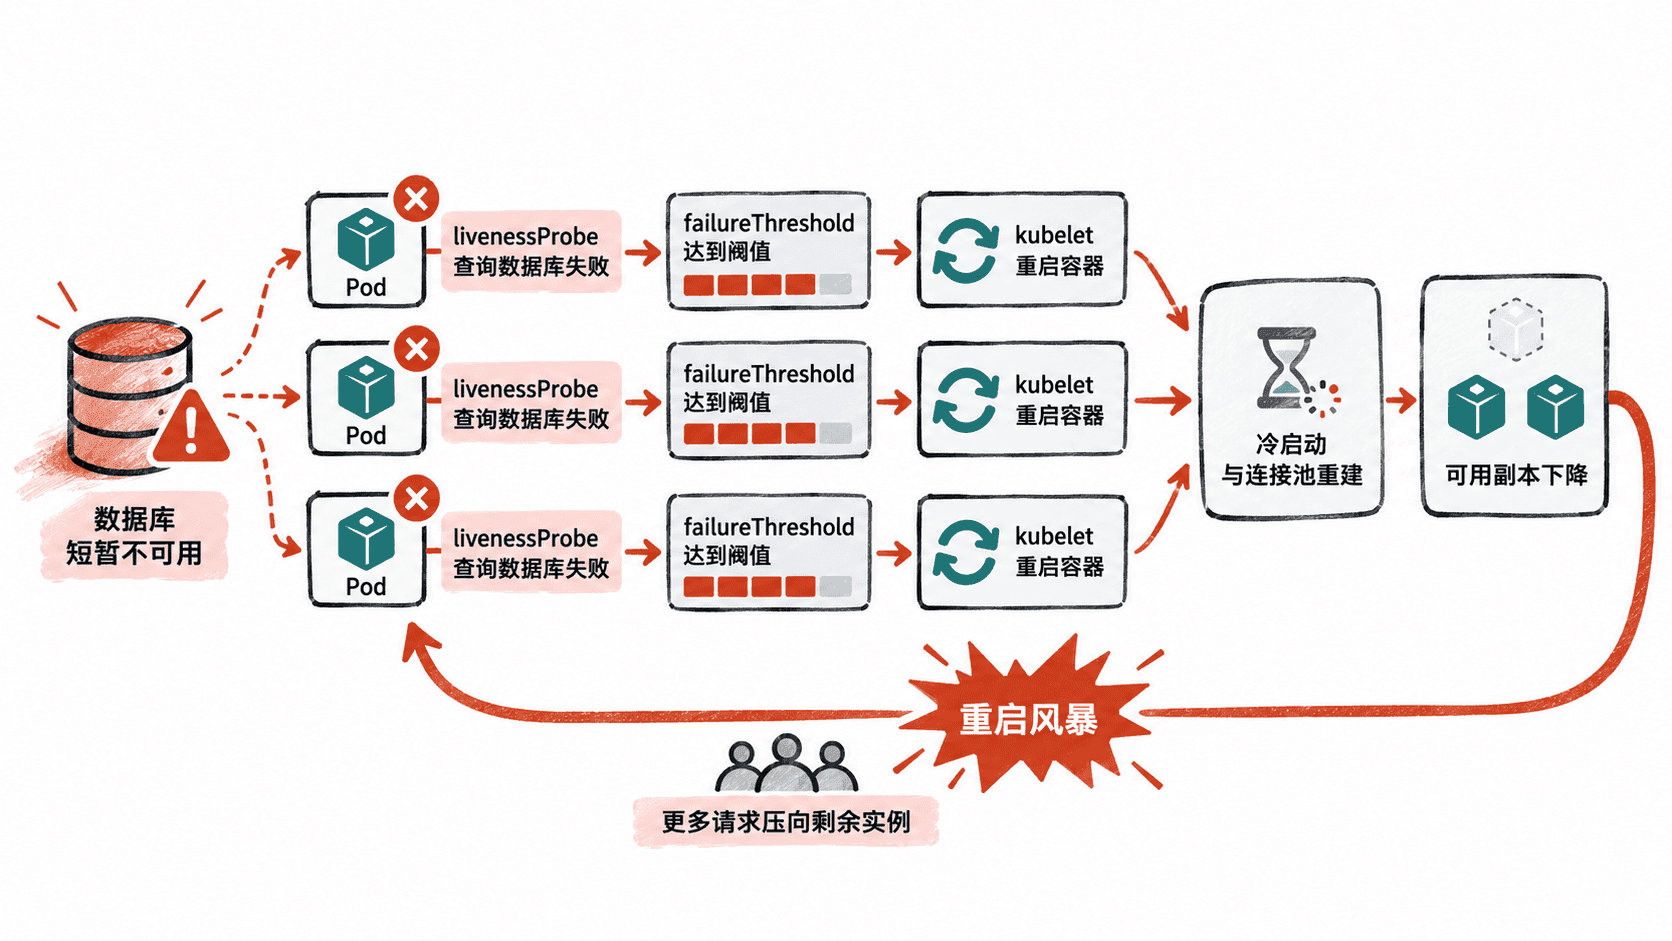
这类配置最危险的地方是:重启并不能修复外部依赖。Pod 重启后仍访问同一个数据库、缓存或第三方服务,于是系统只是反复支付重启成本,甚至让恢复中的依赖承受新的连接洪峰。
给三类探针分清职责
livenessProbe 应回答“这个进程是否已经失去自我恢复能力”。典型条件包括主事件循环永久卡死、内部死锁,或应用能够可靠识别的不可恢复内部状态。
readinessProbe 回答“这个 Pod 当前是否适合接收 Service 流量”。启动后的预热、临时过载或会直接导致请求失败的本地状态更适合影响 readiness。若把共享数据库等外部依赖也纳入 readiness,还要评估是否会让所有副本同时退出 EndpointSlice。
startupProbe 用于启动较慢的应用。在 startup probe 成功以前,liveness 和 readiness 不会开始执行,从而避免正常冷启动被过早判死。
配置只检查进程自身的存活探针
下面的 Deployment 假设应用提供两个内部健康接口:/health/startup 只在初始化完成后返回成功,/health/live 只检查进程自身状态且不访问外部依赖。这样 startup probe 负责保护冷启动窗口,liveness probe 只处理“重启有机会修复”的内部失活。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: api
  template:
    metadata:
      labels:
        app: api
    spec:
      containers:
        - name: api
          image: example/api:1.0.0
          ports:
            - containerPort: 8080
          # 冷启动期间先由 startupProbe 门控其他探针。
          startupProbe:
            httpGet:
              path: /health/startup
              port: 8080
            periodSeconds: 5
            timeoutSeconds: 2
            failureThreshold: 24
          # 存活接口必须快速、稳定,并且不查询外部依赖。
          livenessProbe:
            httpGet:
              path: /health/live
              port: 8080
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 3
这段配置最多给启动阶段约 120 秒的探测窗口;startup probe 成功后,liveness probe 才开始工作。随后若连续 3 次存活检查失败,kubelet 才会按 Pod 的重启策略重启容器。配置文件本身不能保证接口语义正确,仍需确认 /health/live 的实现没有访问共享依赖。
应用配置并观察 Pod:
kubectl apply -f deployment.yaml
kubectl get pods -l app=api
预期结果
deployment.apps/api <VALUE>
NAME       READY   STATUS    RESTARTS   AGE
api-<ID>   1/1     Running   0          <TIME>
api-<ID>   1/1     Running   0          <TIME>
api-<ID>   1/1     Running   0          <TIME>
其中 <VALUE> 可能是 created、configured 或 unchanged,Pod 名称和时间也会因环境而异。正常运行时,即使数据库出现短暂故障,只要 /health/live 不检查数据库,RESTARTS 就不应因此增长。
验证故障有没有被错误放大
排查线上异常时,应把“业务请求失败”和“容器被重启”分开观察。先读取一个 Pod 的重启次数,把它与业务故障时间线对齐:
POD="$(kubectl get pod -l app=api -o jsonpath='{.items[0].metadata.name}')"
kubectl get pod "$POD" -o jsonpath='restartCount={.status.containerStatuses[0].restartCount}{"\n"}'
预期输出
restartCount=<VALUE><VALUE> 为实际重启次数。若该值在数据库故障期间增长,再查看这个 Pod 的 describe 事件,确认是否出现 liveness 探针失败和容器重启记录;事件文本会随 Kubernetes 版本、运行时及保留情况变化。如果多个 Pod 的重启次数同步增长,应优先检查 liveness 接口是否包含依赖探测,而不是只继续放宽阈值。提高 failureThreshold 只能延迟错误动作,不能修正职责错误。
哪些失败才应该让容器重启
判断标准可以归结为一个问题:重启当前容器是否很可能解决这个状态? 如果答案是否定的,就不适合作为 liveness 失败条件。数据库不可达、Redis 超时、第三方 API 返回 503、DNS 临时异常通常属于外部故障;进程死锁、主循环永久卡死等才更接近真正的存活问题。
正确的 livenessProbe 应保持简单、快速,并尽量只依赖容器自身。这样在外部系统抖动时,Kubernetes 不会主动销毁仍然健康的计算容量。