
容器与云原生 / 系统课时
建立发布过程观测指标
建立发布过程观测指标
滚动发布不能只看 kubectl rollout status 是否成功。可靠的发布门禁需要同时观察副本推进、Pod 生命周期与事件、业务错误率和延迟、资源压力,才能发现“控制器已经完成,但用户请求已经异常”的情况。
学习目标
- 建立覆盖 Kubernetes 状态、Pod 事件、业务流量和资源负载的发布观测信号
- 用 Kubernetes 命令判断滚动更新是否稳定推进并定位受阻位置
- 根据多类信号区分继续发布、暂停调查和立即回退
用四层信号判断发布健康度
发布观测可以分为四层:Deployment 与 ReplicaSet 描述副本是否按策略推进;Pod 状态和事件暴露启动、探针、调度等异常;业务指标反映用户是否受到影响;资源指标则帮助解释错误率或延迟为什么发生变化。
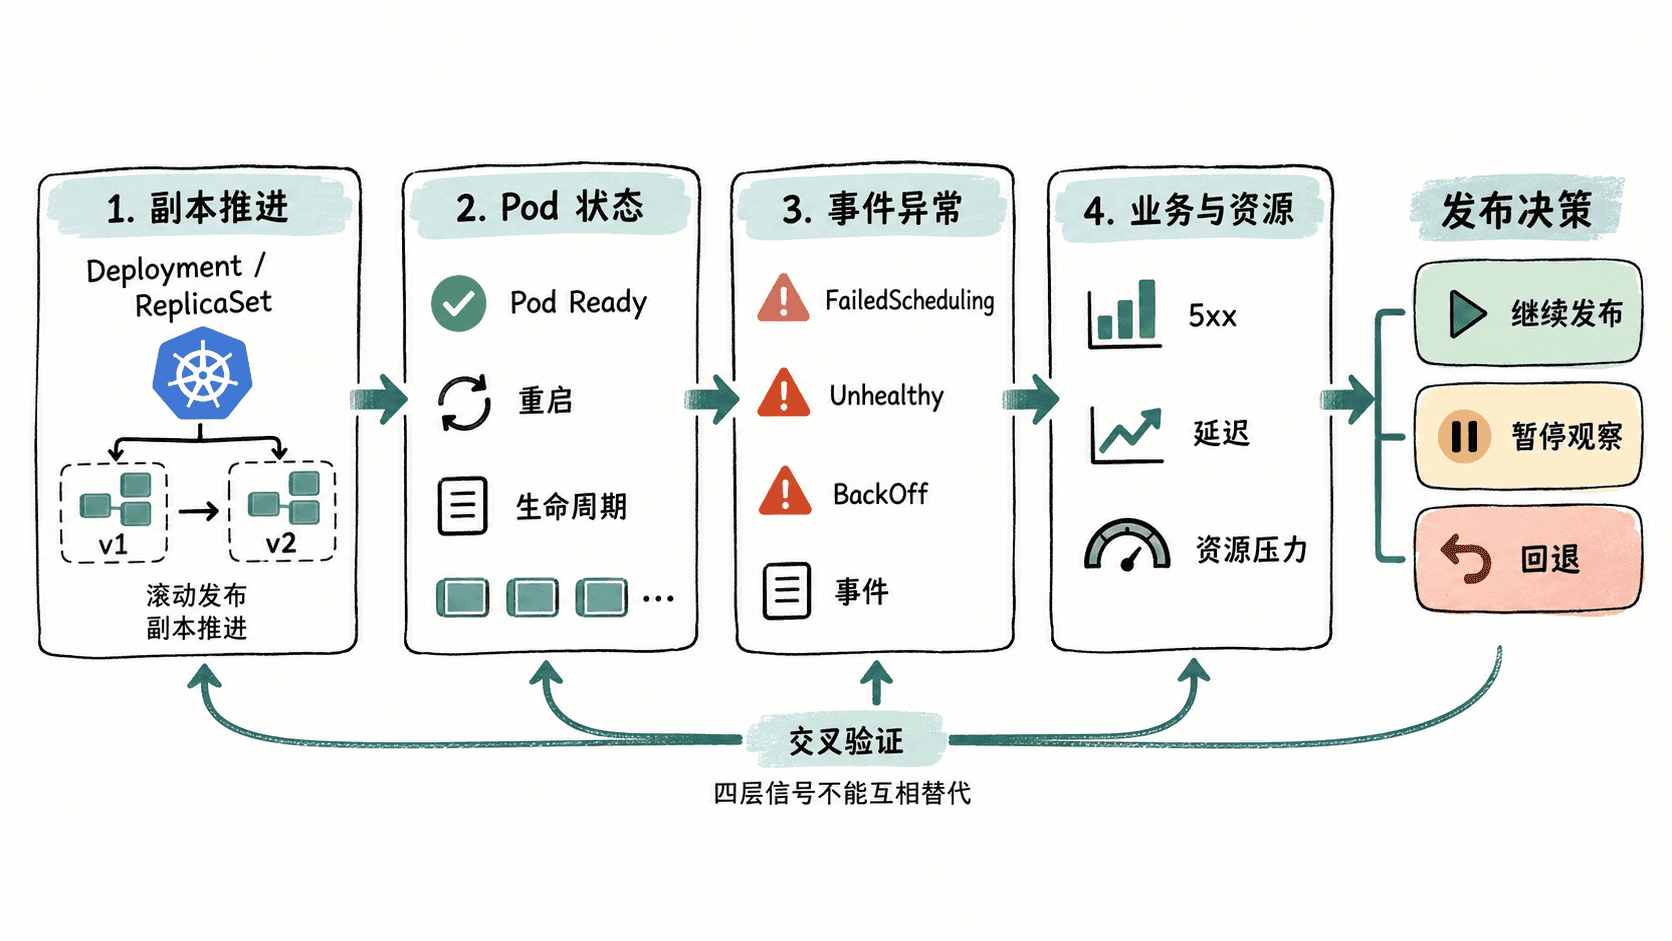
四层信号不能互相替代。例如 availableReplicas 达到期望值,并不代表新版本没有提高 HTTP 500;反过来,错误率上升也不能直接断定代码回归,因为 OOM、节点压力、探针抖动同样可能造成请求失败。
持续观察副本、Pod 与事件
发布窗口内先确认 Deployment 是否持续产生新副本,再检查新 ReplicaSet 的 Ready 数量、Pod 重启和调度事件。下面这一组命令覆盖控制器、副本、Pod 和近期事件,可作为一次完整的发布现场检查。
kubectl rollout status deployment/web -n production --timeout=60s
kubectl get deployment web -n production
kubectl get rs -n production -l app=web
kubectl get pods -n production -l app=web -o wide
kubectl get events -n production --sort-by=.lastTimestamp
预期输出
deployment "web" successfully rolled out
NAME   READY     UP-TO-DATE   AVAILABLE   AGE
web    <N>/<N>   <N>          <N>         <AGE>
NAME       DESIRED   CURRENT   READY   AGE
web-<ID>   <N>       <N>       <N>     <AGE>
NAME       READY   STATUS    RESTARTS   AGE    IP     NODE
web-<ID>   1/1     Running   <N>        <AGE>  <IP>   <NODE>
LAST SEEN   TYPE     REASON     OBJECT         MESSAGE
<TIME> <TYPE> <REASON> pod/web-<ID> <MESSAGE>这是健康发布完成时的示意输出,实际副本数、时间、ID、IP、节点和事件内容会不同。如果发布尚未完成,rollout status 可能持续等待新副本可用,直到成功或达到超时时间。此时重点看 UP-TO-DATE 是否继续增长、AVAILABLE 是否维持在允许范围,以及新 ReplicaSet 的 Ready 副本能否稳定增加。
重启次数持续增长通常需要检查容器退出、存活探针失败或 OOM;Pod 长时间处于 Pending,则应关注 FailedScheduling、资源不足、亲和性约束或卷挂载问题。事件适合提供短期诊断证据,但不适合作为长期趋势监控的数据源。
把业务与资源指标放进同一时间窗口
Kubernetes 对象全部 Ready 后,还要验证请求结果。在线服务至少应观察请求量、错误率和延迟,并尽可能按版本、Pod、ReplicaSet 或发布批次切分。若整体 5xx 上升,而异常主要集中在新 ReplicaSet 对应实例,就能比集群平均值更快定位版本回归。
延迟应重点关注高分位数而不是只看平均值,因为少量严重慢请求很容易被平均值掩盖。资源指标则用于解释业务异常:CPU 长时间接近上限可能造成排队和超时,内存接近限制可能进一步触发 OOMKill,节点资源压力还可能同时影响多个 Pod。
观测时要把这些曲线放在同一发布时间窗口内关联,而不是分别看几个孤立数字。发布前基线、新版本开始进入流量的时间点以及异常首次出现的时间点,通常是判断相关性的关键证据。
设置继续、暂停和回退条件
生产发布应在开始前定义可执行的判定条件,而不是依赖操作人员临场判断。继续发布通常要求新 Pod Ready 稳定、副本持续推进、没有新增的持续重启或调度异常,同时错误率、延迟和资源压力没有明显偏离基线。
如果新 Pod 长时间无法 Ready、重启持续增加,或者业务指标出现异常但影响范围尚未确认,应暂停扩大变更范围并调查原因。暂停的目的不是等待控制器自行恢复,而是避免把尚未定位的问题扩散到更多实例。
当证据已经表明新版本导致关键请求错误率显著上升、核心接口不可用或产生不可接受的数据风险时,应执行预先定义的回退流程。回退完成后仍需持续观察,直到副本状态、事件和业务指标都重新回到稳定区间。
一次滚动发布只有在多类证据相互印证时才能判定健康:Kubernetes 状态说明发布如何推进,Pod 与事件说明哪里受阻,业务指标说明用户是否受影响,资源指标帮助解释异常原因。