
容器与云原生 / 系统课时
设置 terminationGracePeriodSeconds
设置 terminationGracePeriodSeconds
terminationGracePeriodSeconds 决定 kubelet 在正常终止 Pod 时愿意给应用多少退出时间。设置过短会让仍在处理请求的进程被强制终止,设置过长又会拖慢发布和故障收敛。本课把宽限期拆成可测量的时间预算,并给出配置与验证方法。
学习目标
- 根据在途请求、
preStop、后台任务和资源释放时间估算宽限期 - 正确配置并验证
terminationGracePeriodSeconds - 识别宽限期过短或虚高带来的发布风险
把宽限期当成退出预算
Pod 进入终止流程后,终止宽限期开始计时。若配置了 preStop,这个 Hook 的执行时间也会消耗同一份预算;随后容器进程收到终止信号,应用需要在剩余时间内完成优雅关闭。到期后仍未退出的进程会面临强制终止。
可以用下面的估算式建立初始值:
其中 T_inflight 应取真实业务中允许等待的最长在途请求或任务时间,T_cleanup 包括连接池关闭、消费者提交位点等退出动作,T_margin 用于吸收调度和网络抖动。不要直接拿接口平均耗时作为宽限期依据。
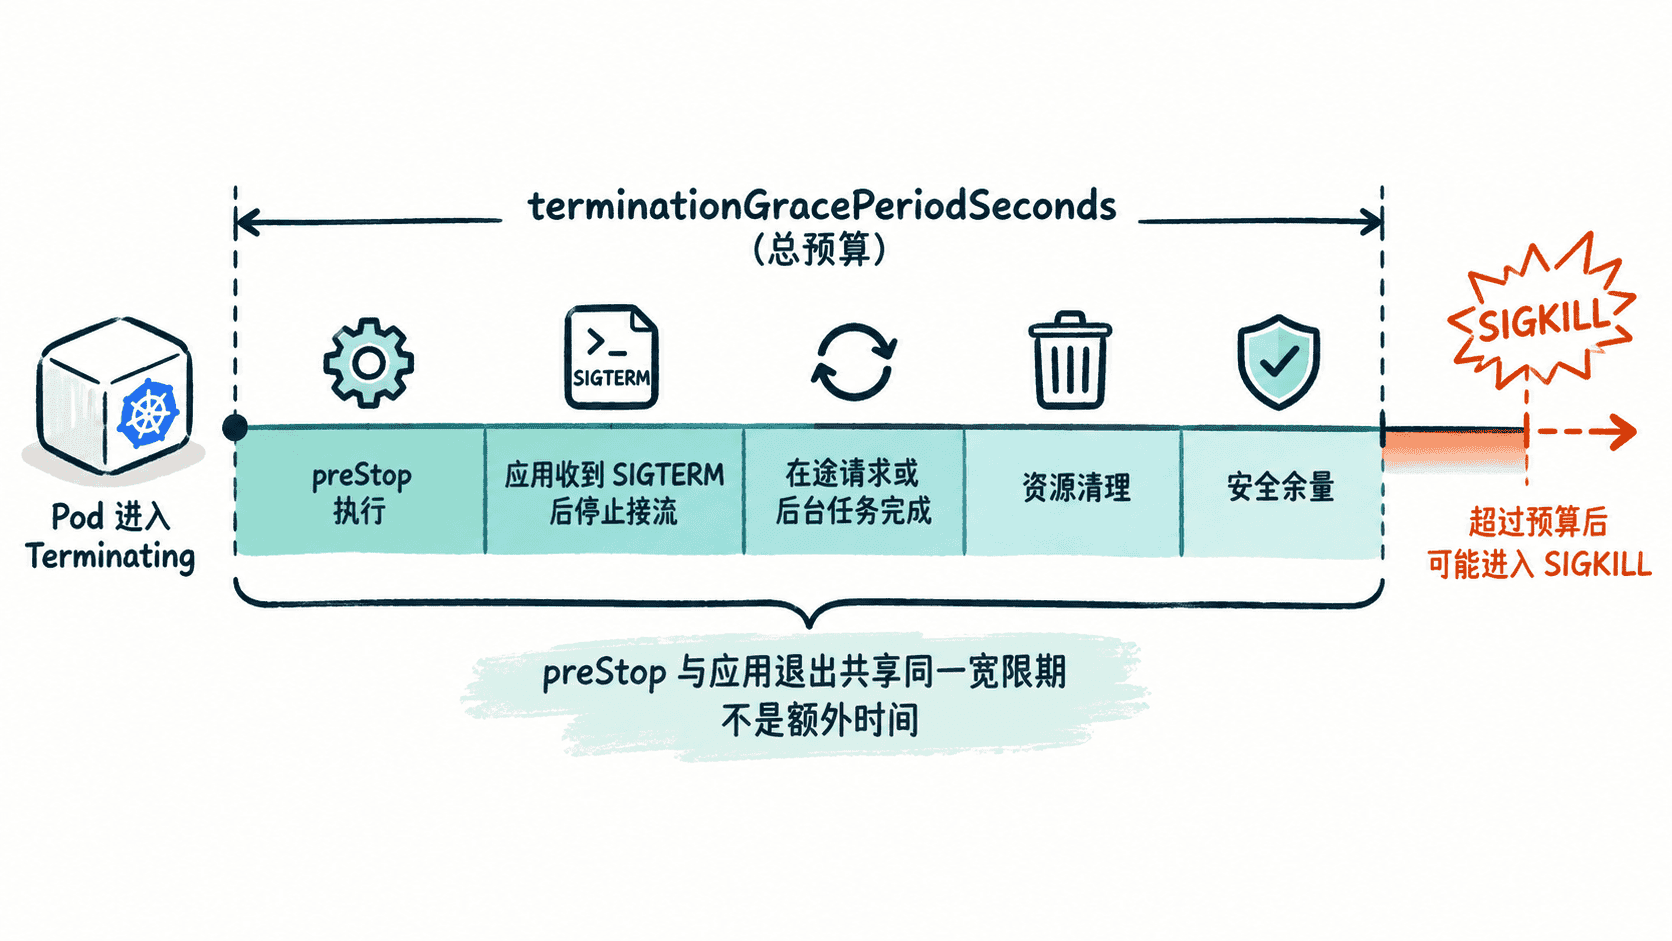
例如,preStop 最坏需要 5 秒,最长请求允许执行 20 秒,资源清理 5 秒,再留 10 秒余量,那么初始宽限期可设为 40 秒。上线后仍应依据真实终止耗时分布调整,而不是长期保留拍脑袋的数值。
在 Pod 模板中配置宽限期
terminationGracePeriodSeconds 位于 Pod spec,不是容器字段。下面的 Deployment 片段把宽限期设为 40 秒,并用 preStop 暂停 5 秒,给外部流量摘除留出缓冲。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: api
  template:
    metadata:
      labels:
        app: api
    spec:
      terminationGracePeriodSeconds: 40
      containers:
        - name: api
          image: example/api:1.0
          ports:
            - containerPort: 8080
          lifecycle:
            preStop:
              exec:
                command: ["/bin/sh", "-c", "sleep 5"]
这个配置不会保证应用一定优雅退出;它只是给终止流程最多约 40 秒的正常退出窗口。应用仍必须正确处理 SIGTERM,否则 40 秒可能只是无效等待。
验证配置是否进入 Pod 模板:
kubectl get deployment api -o jsonpath='{.spec.template.spec.terminationGracePeriodSeconds}{"\n"}'预期输出:
40用删除 Pod 验证真实退出耗时
不要只检查 YAML。更可靠的方式是主动删除一个副本,并同时观察应用日志、请求错误率和 Pod 消失时间。
先找到一个 Pod:
kubectl get pods -l app=api预期输出类似:
NAME                   READY   STATUS    RESTARTS   AGE
api-<ID>               1/1     Running   0          <TIME>
然后记录时间并删除该 Pod:
date +%s
kubectl delete pod api-<ID>
date +%s
预期输出的具体时间戳会变化:
<TIME>
pod "api-<ID>" deleted
<TIME>
kubectl delete 默认会等待对象删除完成,因此前后时间差可以作为一次粗略观测,但它还包含 API、调度和客户端等待开销。更精确的治理应从应用日志或指标记录“收到 SIGTERM”到“进程退出”的持续时间,并统计高分位值。
什么时候需要调大或调小
如果终止期间出现连接重置、请求被截断、任务只执行一半,且日志显示应用在完成退出前被杀死,应先确认优雅关闭逻辑正常,再适当增加宽限期。单纯把数值从 30 秒改到 300 秒,无法修复不处理 SIGTERM 的应用。
如果大量 Pod 实际 3 秒就能退出,却统一配置数分钟宽限期,滚动发布、缩容和节点维护可能被无谓拖慢。合理做法是让配置覆盖真实高分位退出耗时并留出余量,同时为异常退出设置可观测指标。
最终要把两个数对齐:应用内部允许等待的 shutdown 超时必须小于 Pod 的终止宽限期,并给 preStop 与清理动作留出空间。只有应用退出策略和 Kubernetes 时间预算共同设计,旧 Pod 才能既安全退出,又不会成为发布速度的瓶颈。