
容器与云原生 / 系统课时
建立发布可用性判断模型
建立发布可用性判断模型
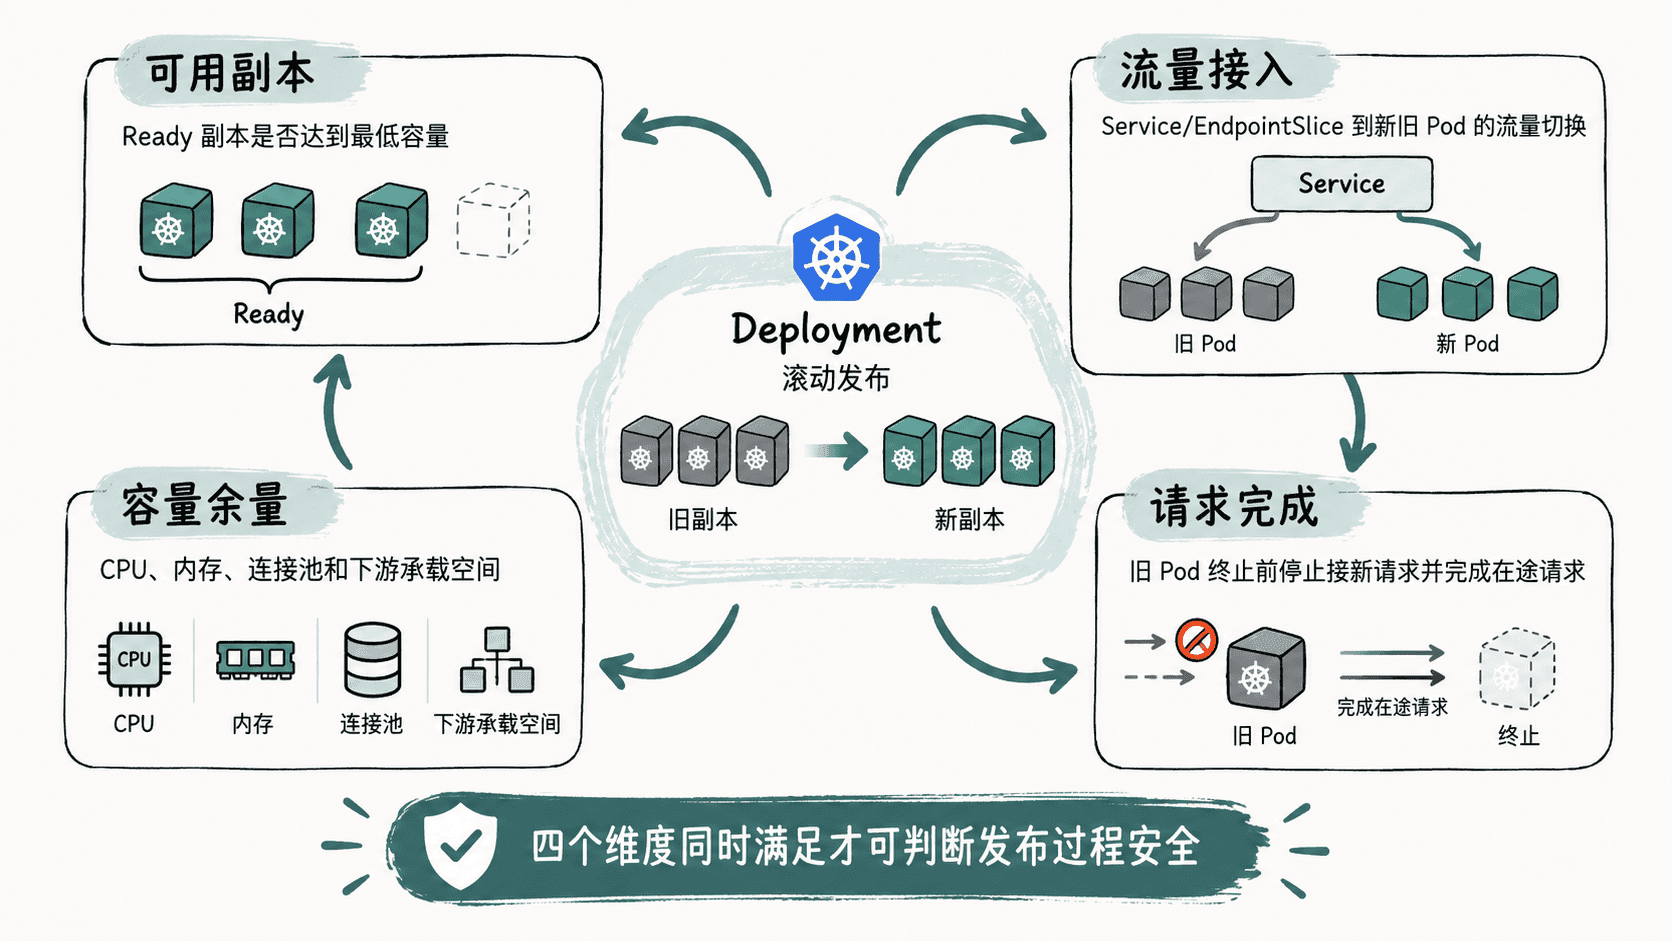
一次滚动发布是否安全,不能只看 Deployment 最终有没有变成 Ready。本课建立四维判断模型:可用副本、流量接入、容量余量和请求完成,用它判断发布过程中是否始终保留足够服务能力。
学习目标
- 从四个维度判断滚动发布是否真正保持可用
- 区分“副本数量正常”和“用户请求没有受损”之间的差异
- 识别发布中最常见的容量与流量切换风险
可用副本只是第一层
滚动发布首先要看真正可用的副本,而不是仅看已经创建多少 Pod。一个 Pod 即使已经进入 Running,只要 readiness 尚未通过,就不能把它当成能够承担生产流量的容量。
因此,第一个问题是:在任意发布时刻,Ready 且能够稳定处理请求的副本数,是否仍满足业务所需的最低容量。如果旧副本退出得太快,而新副本启动、预热或就绪较慢,就可能形成短暂的容量缺口。
假设平时需要至少 6 个健康副本才能安全承担峰值流量。发布过程中虽然始终存在 8 个 Pod,但其中 3 个新 Pod 尚未 Ready,那么真正的可用副本只有 5 个。此时“Pod 总数足够”并不能证明发布安全。
流量必须真正进入正确实例
第二个维度是流量接入。Ready 状态解决的是“这个 Pod 是否有资格进入服务端点”,但实际请求是否已经正确路由过去,还受 Service、EndpointSlice、Ingress、Gateway、服务网格以及外部负载均衡器等链路影响。
发布时需要同时关注两个方向:新 Pod Ready 后,流量是否能够逐步进入;旧 Pod 即将退出时,流量是否已经停止进入。任何一个方向处理不当,都可能造成新容量空转,或者已经准备终止的旧实例继续收到请求。
容量余量决定能否承受过渡期
第三个维度是容量余量。滚动发布不是静态状态切换,而是一段新旧副本并存、部分实例初始化、部分实例退出的过渡期。这个阶段通常比稳定运行状态更容易出现瞬时资源压力。
需要关注的不只是 Pod 数量,还包括节点 CPU 和内存、应用线程池、连接池、缓存预热成本,以及数据库、消息队列等下游系统能否承受新旧实例短时间并存。如果一个集群平时就长期运行在极限容量附近,即使滚动策略从副本数量上看没有下降,也可能因为新 Pod 调度、镜像解压或启动预热导致资源争抢。
一个实用的问题是:如果现在突然失去一个旧副本,同时一个新副本仍未 Ready,剩余实例是否还能承载当前流量。如果答案是否定的,那么当前发布策略对故障和启动抖动几乎没有缓冲空间。
已接收的请求还要能够完成
第四个维度是请求完成。一个旧 Pod 从 Ready 变为 NotReady,只能减少新的流量进入,并不代表此前已经建立的请求、长连接或后台任务已经自然结束。终止流程如果过快,就可能在滚动发布过程中产生连接重置、5xx 或未完成事务。
因此,安全退出通常需要形成明确顺序:实例先停止接收新流量,负载均衡链路完成端点收敛,然后给在途请求留出完成时间,最后再终止进程。HTTP 短请求、WebSocket、gRPC 长连接和批处理任务所需的退出窗口可能完全不同,不能统一假设“Pod 一删除请求就已经结束”。
这也是为什么只观察 availableReplicas 仍然不够。它能说明 Kubernetes 认为有多少副本满足可用条件,却不能直接证明正在结束的旧实例没有请求损失。
把四个维度合成发布门槛
一次发布可以用四个连续问题进行判断:可用副本是否始终高于业务最低需求;新旧实例之间的流量是否按预期切换;过渡期是否还有足够资源和下游容量余量;退出中的实例是否能完成已经接收的请求。
这四个维度必须同时成立。比如副本数一直充足,但旧 Pod 被强制终止导致长请求中断,发布仍然不可用;流量切换完全正确,但节点资源已经耗尽,新 Pod 反复 Pending 或启动超时,同样不安全;请求都能优雅结束,但新版本 Ready 判断过早,把尚未预热完成的实例投入高流量,也会造成延迟和错误率上升。
因此,判断滚动发布不应停留在“Deployment 最后成功了没有”,而应观察整个时间窗口内的最差状态。真正安全的发布,是在旧容量退出、新容量加入和请求迁移的全过程中,用户侧服务能力始终没有跌破可接受边界。