
容器与云原生 / 系统课时
排查发布期间请求中断
排查发布期间请求中断
滚动发布时出现短暂 5xx、超时或连接重置,不能只看 Deployment 最终是否成功。本课把异常与 rollout 时间线对齐,再检查 EndpointSlice、新 Pod 接流和旧 Pod 退出,定位流量交接窗口中的真实断点。
学习目标
- 按请求链定位滚动发布期间的短暂中断发生在哪一层
- 用 EndpointSlice 条件判断发布期间是否持续存在正常可接流后端
- 判断新 Pod 是否过早接流、旧 Pod 是否过早退出,并完成连续请求验收
先把故障与 rollout 时间线对齐
Deployment 显示成功,只能说明期望副本最终达到可用状态,不能证明整个发布窗口没有请求失败。先把 rollout 开始、结束时间与业务 5xx、超时或连接重置的时间点对齐,再检查对应时刻的 Pod Ready、EndpointSlice 和终止状态。
kubectl rollout status deployment/web -n app预期输出
deployment "web" successfully rolled out最终成功但发布窗口仍有异常时,排查重点应转向流量接入和退出交接,而不是简单归因于 Deployment 控制器失败。实际 Pod 名称、切换顺序和持续时间会因环境而异。
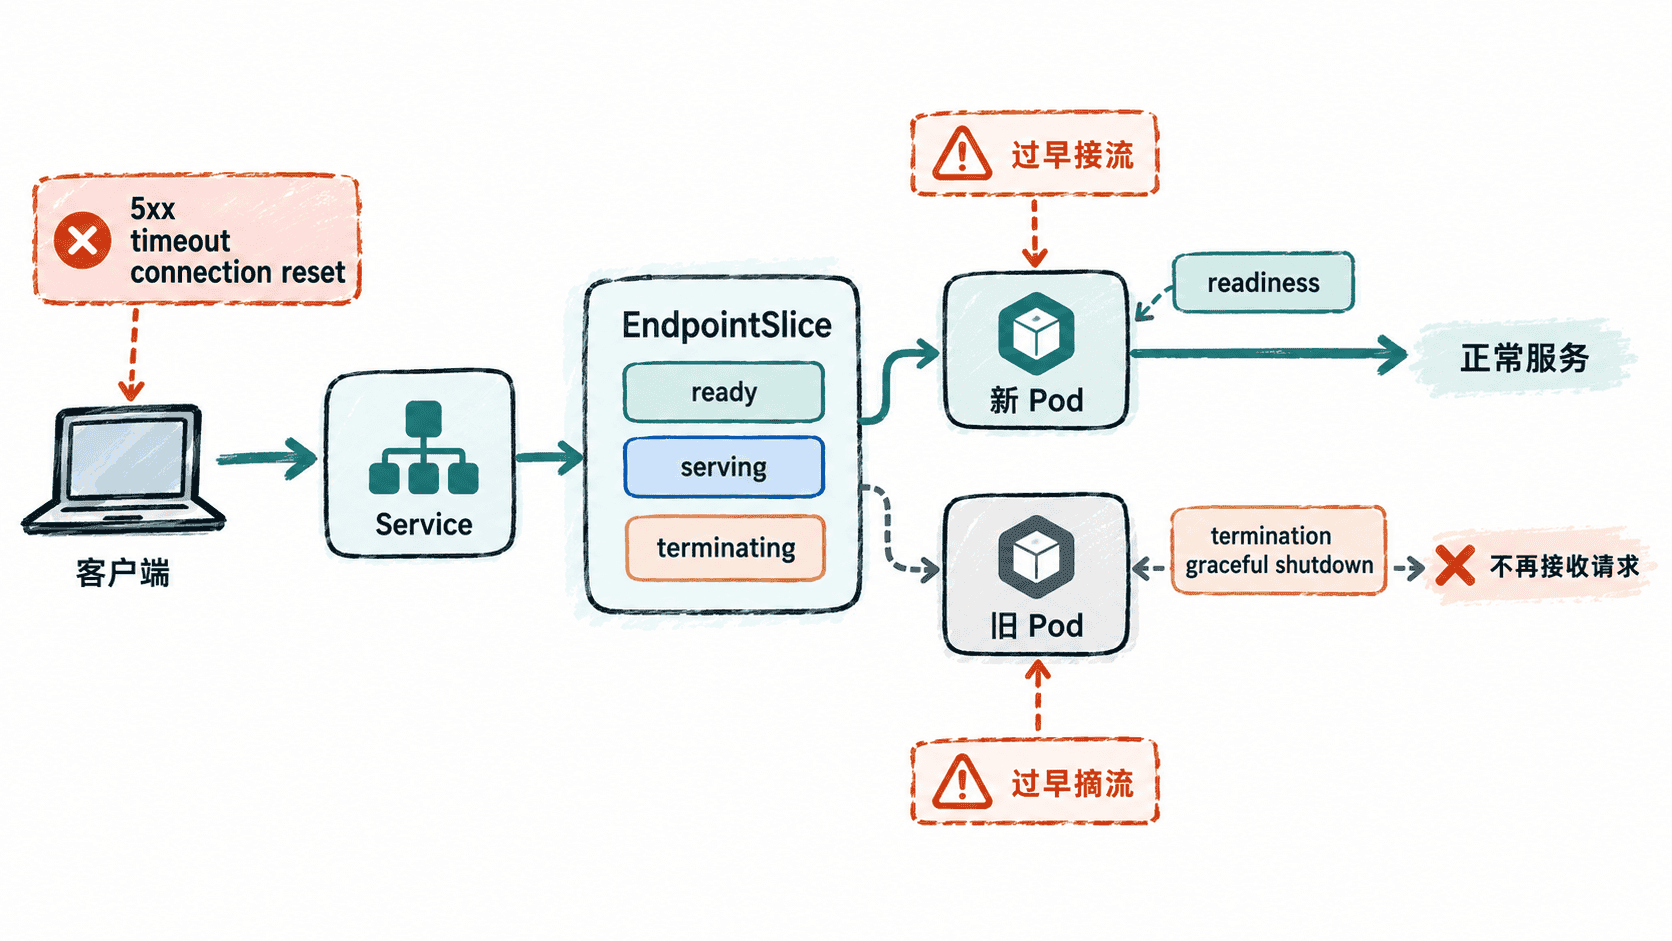
检查 EndpointSlice 的真实接流状态
Service 的后端信息由 EndpointSlice 表达。kubectl get endpointslice -o wide 可以快速看到地址,但不能证明每个 endpoint 当前是否可用于常规接流;需要读取 conditions.ready、conditions.serving 和 conditions.terminating,并把条件与具体 Pod 对上。
kubectl get endpointslice -n app -l kubernetes.io/service-name=web -o jsonpath='{range .items[*].endpoints[*]}{.addresses[0]}{" ready="}{.conditions.ready}{" serving="}{.conditions.serving}{" terminating="}{.conditions.terminating}{" pod="}{.targetRef.name}{"\n"}{end}'预期结果
10.42.0.11 ready=true serving=true terminating=false pod=web-<ID>
10.42.0.12 ready=false serving=true terminating=true pod=web-<ID>
实际 IP、Pod 名称和 endpoint 数量会不同。对未开启 publishNotReadyAddresses 的普通 Service,排查“是否持续存在正常可接流后端”时,重点确认发布全过程至少有一个非终止 endpoint 保持 ready=true;serving 用来补充判断 endpoint 是否仍具备服务能力,terminating=true 则说明它已进入退出阶段。不能只凭 -o wide 中地址仍存在,就认定流量交接安全。
若正常 ready endpoint 在发布窗口短暂降为 0,应继续检查 Deployment 的 maxUnavailable、maxSurge、readinessProbe 与新旧 Pod 的交接时机。单纯增加副本可能缓解症状,但不会修复过早接流或过早退出。
判断新 Pod 是否过早接流
常见根因是 readinessProbe 只证明“端口已打开”,却没有覆盖应用真正接流所需的条件,例如配置加载、依赖连接或缓存预热。此时 Pod 很快 Ready,并开始进入常规 Service 流量路径,但真实请求仍可能失败。
kubectl get pod <ID> -n app -o jsonpath='pod={.metadata.name} ready={.status.conditions[?(@.type=="Ready")].status}{"\n"}'预期输出
pod=web-<ID> ready=True将 <ID> 替换为新版本 Pod 名称。若 Ready 已变为 True,但应用日志仍显示关键初始化未完成,应调整 readinessProbe,让成功条件与“能够稳定处理真实请求”一致,而不是只检测进程或端口存活。
检查旧 Pod 的退出窗口
旧 Pod 被删除后会进入终止流程。此时 EndpointSlice 会暴露终止状态,而应用仍需正确处理 SIGTERM、停止接收新工作并完成在途请求。若进程过早退出,客户端或上游代理仍持有连接时就可能看到 connection reset、502 或 503。
kubectl get deployment web -n app -o jsonpath='{.spec.template.spec.terminationGracePeriodSeconds}{"\n"}'预期输出
30实际值可能不同。terminationGracePeriodSeconds 应覆盖应用停止接收新请求、完成在途请求以及退出所需的最长合理时间。若应用根本不处理 SIGTERM,单纯延长宽限期通常不能解决中断。
需要额外退出动作时可以使用 preStop,但它也消耗终止宽限期。应把它用于明确的摘流或清理动作,而不是用固定睡眠时间掩盖 readiness 或连接排空设计问题。
用连续请求验收交接过程
修复后必须在下一次 rollout 期间持续发请求,并同步观察 EndpointSlice 条件和 Pod 状态。下面从集群内直接访问 Service,可先排除外部 Ingress、Gateway 或负载均衡器带来的额外变量。
kubectl run rollout-check -n app --rm -i --restart=Never --image=curlimages/curl --command -- sh -c 'for i in $(seq 1 30); do curl -sS -o /dev/null -w "%{http_code}\n" --max-time 2 http://web; sleep 1; done'预期输出
200
200
200
...
若出现 000、5xx、超时或连接错误,就把异常秒点与 EndpointSlice 的 ready/serving/terminating、新 Pod Ready 时间和旧 Pod 终止日志对齐。若集群内 Service 始终正常、只有外部入口失败,再向 Ingress、Gateway、负载均衡器或连接排空配置继续定位。
最终验收标准不是“新版本全部 Running”,而是整个 rollout 窗口持续存在可接流后端,新 Pod 在真正就绪后才接流,旧 Pod 在完成摘流和在途请求后退出,客户端成功率与延迟都保持在可接受范围内。