
容器与云原生 / 系统课时
配置健康检查
配置健康检查
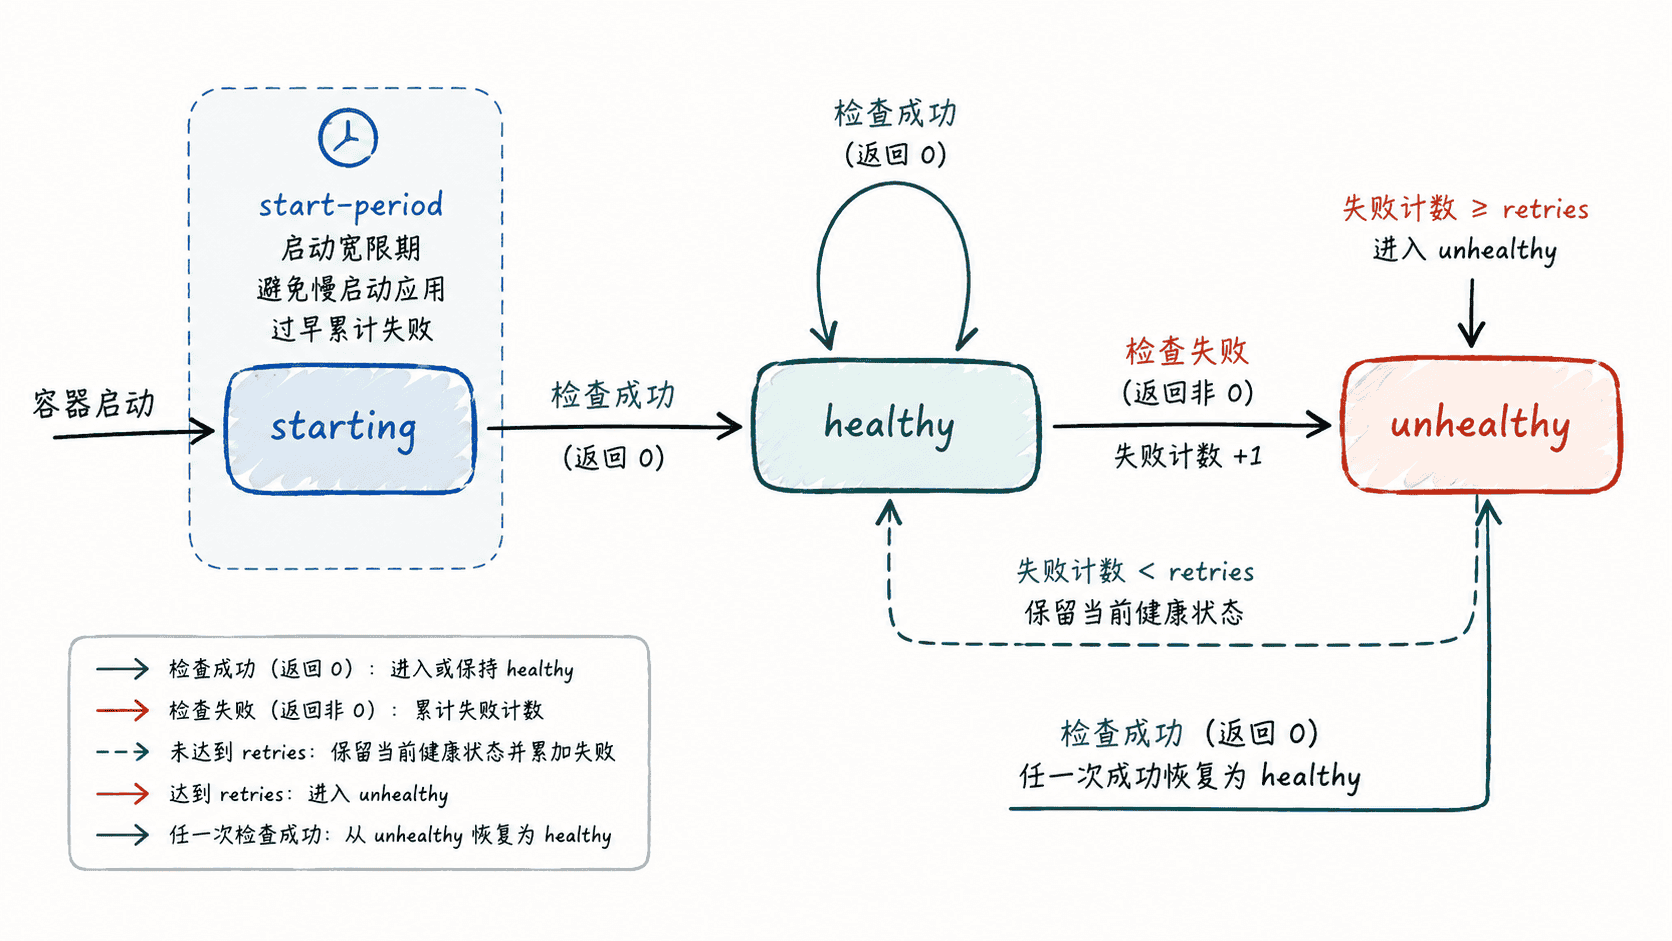
健康检查让 Docker 不只知道容器“进程还活着”,还能够判断应用是否真正可用。通过命令、间隔、超时、启动宽限期和失败次数,可以把容器状态从 starting 转为 healthy 或 unhealthy,为监控和编排提供可靠信号。
学习目标
- 配置
--health-cmd、检查间隔、超时和重试次数 - 理解
starting、healthy、unhealthy三种健康状态 - 使用
docker inspect验证健康检查是否生效
健康检查判断的是什么
Docker 默认只根据主进程是否存在判断容器是否运行。应用即使死锁、依赖不可达或 HTTP 接口已经失效,只要 PID 1 没退出,容器仍可能显示为 Up。健康检查会在容器内部周期执行一条命令,用退出码表达结果:0 表示成功,非 0 表示失败。
健康状态与运行状态是两套信息。容器可以同时是“运行中但不健康”,因此看到 Up 不能替代健康检查。
配置检查命令和时间参数
下面以 nginx:alpine 为例,使用容器内的 wget 请求首页。命令成功返回 0,失败时显式返回 1:
docker run -d --name health-demo --health-cmd='wget -q -O /dev/null http://127.0.0.1/ || exit 1' --health-interval=10s --health-timeout=3s --health-retries=3 --health-start-period=5s nginx:alpine预期输出:
<ID>容器 ID 的实际值会不同。--health-interval 决定两次检查的间隔,--health-timeout 限制单次命令最长执行时间,--health-retries 指定连续失败多少次后判定不健康,--health-start-period 则给慢启动应用预留宽限时间。
验证 healthy 状态
容器刚启动时通常先显示 starting。等待至少一个检查周期后,读取健康状态:
sleep 12
docker inspect --format '{{.State.Health.Status}}' health-demo
预期输出:
healthy如果第一次检查因机器负载等原因稍晚执行,实际等待时间可能略有不同。还可以使用 docker ps 查看状态列,其中健康容器通常会附带 (healthy)。
验证失败重试与 unhealthy
为了确认失败阈值确实生效,可以让 Nginx 主进程保持运行,同时让健康检查访问一个不存在的路径:
docker run -d --name health-fail --health-cmd='wget -q -O /dev/null http://127.0.0.1/not-found || exit 1' --health-interval=2s --health-timeout=1s --health-retries=2 nginx:alpine
sleep 6
docker inspect --format '{{.State.Status}} {{.State.Health.Status}}' health-fail
预期输出:
<ID>
running unhealthy
这里的关键是 running unhealthy:Nginx 主进程仍在,所以运行状态没有变;健康命令连续失败达到两次后,健康状态才变为 unhealthy。健康检查本身不会自动重启普通 Docker 容器,是否重启仍由重启策略或外部编排系统决定。
设置合理的检查边界
间隔太短会增加 CPU、网络和下游依赖压力;超时时间太短会把偶发抖动误判成故障;重试次数太大又会延迟告警。常见做法是让单次检查足够轻量,并根据应用正常响应时间设置超时,再用 2~5 次连续失败过滤瞬时抖动。
start-period 对数据库、JVM 服务和需要初始化的应用尤其重要。在宽限期内,失败检查不会正常累计到失败阈值;一旦检查成功,容器会提前结束启动阶段并进入正常健康判定。最终配置应通过故意制造一次可恢复故障来验证,而不是只确认命令语法能够被 Docker 接受。