
音频开发 / 系统课时
用 PortAudio 跑通实时回调
用 PortAudio 跑通实时回调
这一节用 Python 的 sounddevice 调用底层 PortAudio,建立最小的全双工实时链路:麦克风数据进入回调,执行一次原地增益后立即送往输出设备,同时统计回调耗时和状态标志,用可测量的数据判断处理是否赶得上音频设备的节奏。
学习目标
- 跑通 PortAudio 输入、回调处理和输出组成的最小实时音频链路
- 理解回调帧数、块时间预算和设备缓冲之间的关系
- 记录回调平均耗时、最大耗时和异常状态,为定位欠载或溢出建立基础指标
实时回调在链路中的位置
PortAudio 持续从输入设备取得采样,并要求应用在有限时间内完成当前块处理。以 48 kHz、256 帧为例,一块音频只覆盖约 5.33 ms,因此回调必须在下一批数据需要被消费之前返回。
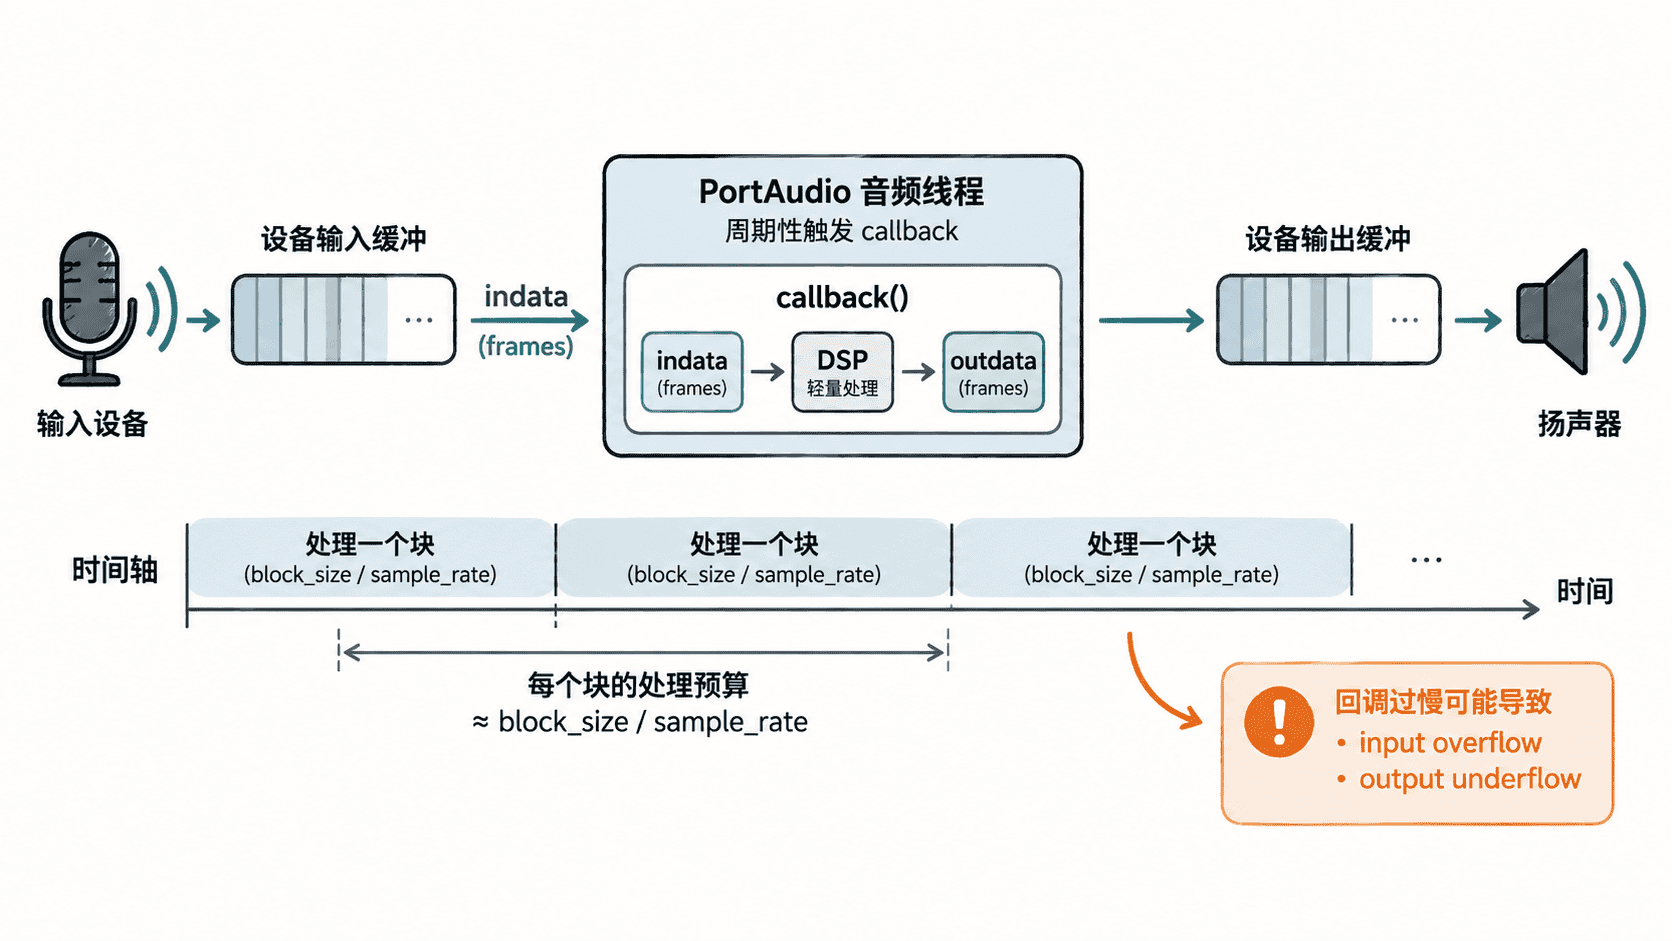
回调块时间可以直接计算:block_size / sample_rate。但它不是完整的端到端延迟,因为真实延迟还包含驱动、硬件和 PortAudio 缓冲。块越小,理论响应越快,但 CPU 被唤醒得更频繁,对调度抖动也更敏感。
检查运行依赖
示例需要 NumPy 和 sounddevice。sounddevice 是 PortAudio 的 Python 绑定,能够直接创建输入、输出或全双工流。先确认当前 Python 环境能够导入这两个包。
python -c "import numpy, sounddevice; print('numpy', numpy.__version__); print('sounddevice', sounddevice.__version__)"预期输出中的版本号取决于本机环境:
numpy <VERSION>
sounddevice <VERSION>
如果这里直接出现模块不存在,应先在当前 Python 环境安装相应依赖;如果包可以导入但稍后无法打开流,则问题通常转向设备权限、默认输入输出设备或 PortAudio 后端,而不是 DSP 代码本身。
建立最小全双工回调
下面的程序打开单声道输入和输出,固定每次请求 256 帧。回调中使用 np.multiply(..., out=outdata) 直接写入 PortAudio 提供的输出缓冲,避免为了一个简单增益额外创建完整输出数组。
import time
import numpy as np
import sounddevice as sd

SAMPLE_RATE = 48_000
BLOCK_SIZE = 256
CHANNELS = 1
GAIN = 0.8
RUN_SECONDS = 5

stats = {
    "callbacks": 0,
    "total_ms": 0.0,
    "max_ms": 0.0,
    "status_count": 0,
    "frame_mismatch": 0,
}


def callback(indata, outdata, frames, time_info, status):
    started = time.perf_counter()

    # PortAudio 的状态标志应在回调内只做轻量记录,避免直接打印或写文件。
    if status:
        stats["status_count"] += 1
    if frames != BLOCK_SIZE:
        stats["frame_mismatch"] += 1

    # 原地写入输出缓冲,后续实时 DSP 可以替换这一行。
    np.multiply(indata, GAIN, out=outdata)

    elapsed_ms = (time.perf_counter() - started) * 1000.0
    stats["callbacks"] += 1
    stats["total_ms"] += elapsed_ms
    stats["max_ms"] = max(stats["max_ms"], elapsed_ms)


with sd.Stream(
    samplerate=SAMPLE_RATE,
    blocksize=BLOCK_SIZE,
    channels=CHANNELS,
    dtype="float32",
    callback=callback,
):
    print("stream started")
    sd.sleep(RUN_SECONDS * 1000)

budget_ms = BLOCK_SIZE / SAMPLE_RATE * 1000.0
avg_ms = stats["total_ms"] / max(stats["callbacks"], 1)

print(f"block budget: {budget_ms:.3f} ms")
print(f"callbacks: {stats['callbacks']}")
print(f"avg callback: {avg_ms:.3f} ms")
print(f"max callback: {stats['max_ms']:.3f} ms")
print(f"status flags: {stats['status_count']}")
print(f"frame mismatch: {stats['frame_mismatch']}")
在默认输入、输出设备均可用时,预期输出形态如下。回调次数和耗时属于运行时动态值,实际数字会随操作系统、驱动和机器负载变化。
stream started
block budget: 5.333 ms
callbacks: <CALLBACK_COUNT>
avg callback: <AVG_MS> ms
max callback: <MAX_MS> ms
status flags: <STATUS_COUNT>
frame mismatch: 0
运行时佩戴耳机或把输入、输出物理隔离,可以降低麦克风到扬声器形成声学反馈的风险。听到的声音应该是输入信号经过 0.8 增益后的实时回放,而不是程序读取完整音频后再统一播放。
用时间预算判断是否安全
5.333 ms 是当前 256 帧块的理论处理周期。平均回调只有 0.1 ms 并不代表绝对安全,因为实时音频更怕偶发尖峰;如果某次回调突然超过一个块周期,输出缓冲可能来不及得到新数据。
因此需要同时观察平均值、最大值和 status flags。理想实验中状态标志长期为 0,最大回调耗时明显低于 5.333 ms。若状态计数持续增加,即使耳朵暂时没有听到爆音,也说明实时链路已经出现调度或缓冲压力。
出现欠载时按顺序定位
先把 DSP 处理临时替换成当前的一次乘法。如果简单增益仍持续产生状态标志,优先检查设备和系统层,而不是继续优化算法。确认默认输入输出设备存在、应用拥有麦克风权限,并关闭可能独占音频设备的软件。
如果简单增益稳定,而换回算法后才出现异常,应比较 max callback 与块时间预算。此时可以先增大 BLOCK_SIZE 验证是否确实属于处理时间不足;块长增大后异常明显减少,通常说明算法复杂度、内存分配或调度抖动需要继续处理。
不要把增大缓冲当成最终优化方案。它能换取更宽松的处理时间,却会提高交互延迟。真正进入实时 DSP 实现时,应把回调保持为短、确定、无阻塞的数据路径,并把界面更新、文件写入和复杂统计移出音频线程。