
音频开发 / 系统课时
用 SIMD 加速样本级运算
用 SIMD 加速样本级运算
实时音频里的增益、混音和逐样本滤波往往要重复执行数百万次相同算术。本节把一个双路混音循环改造成 AVX2 向量处理,并处理未对齐内存、尾部不足一组的样本以及基准测试,最后说明自动向量化什么时候会失效。
学习目标
- 理解 SIMD 为什么适合连续、无分支的样本级运算。
- 能正确处理向量宽度、内存对齐与尾部样本。
- 能用可复现基准测试判断手写 SIMD 是否真的带来收益。
从标量循环找到可向量化部分
以双路混音为例,每个输出样本都执行同一公式:。不同下标之间没有数据依赖,因此可以把多个 float 一次装入向量寄存器并并行计算。
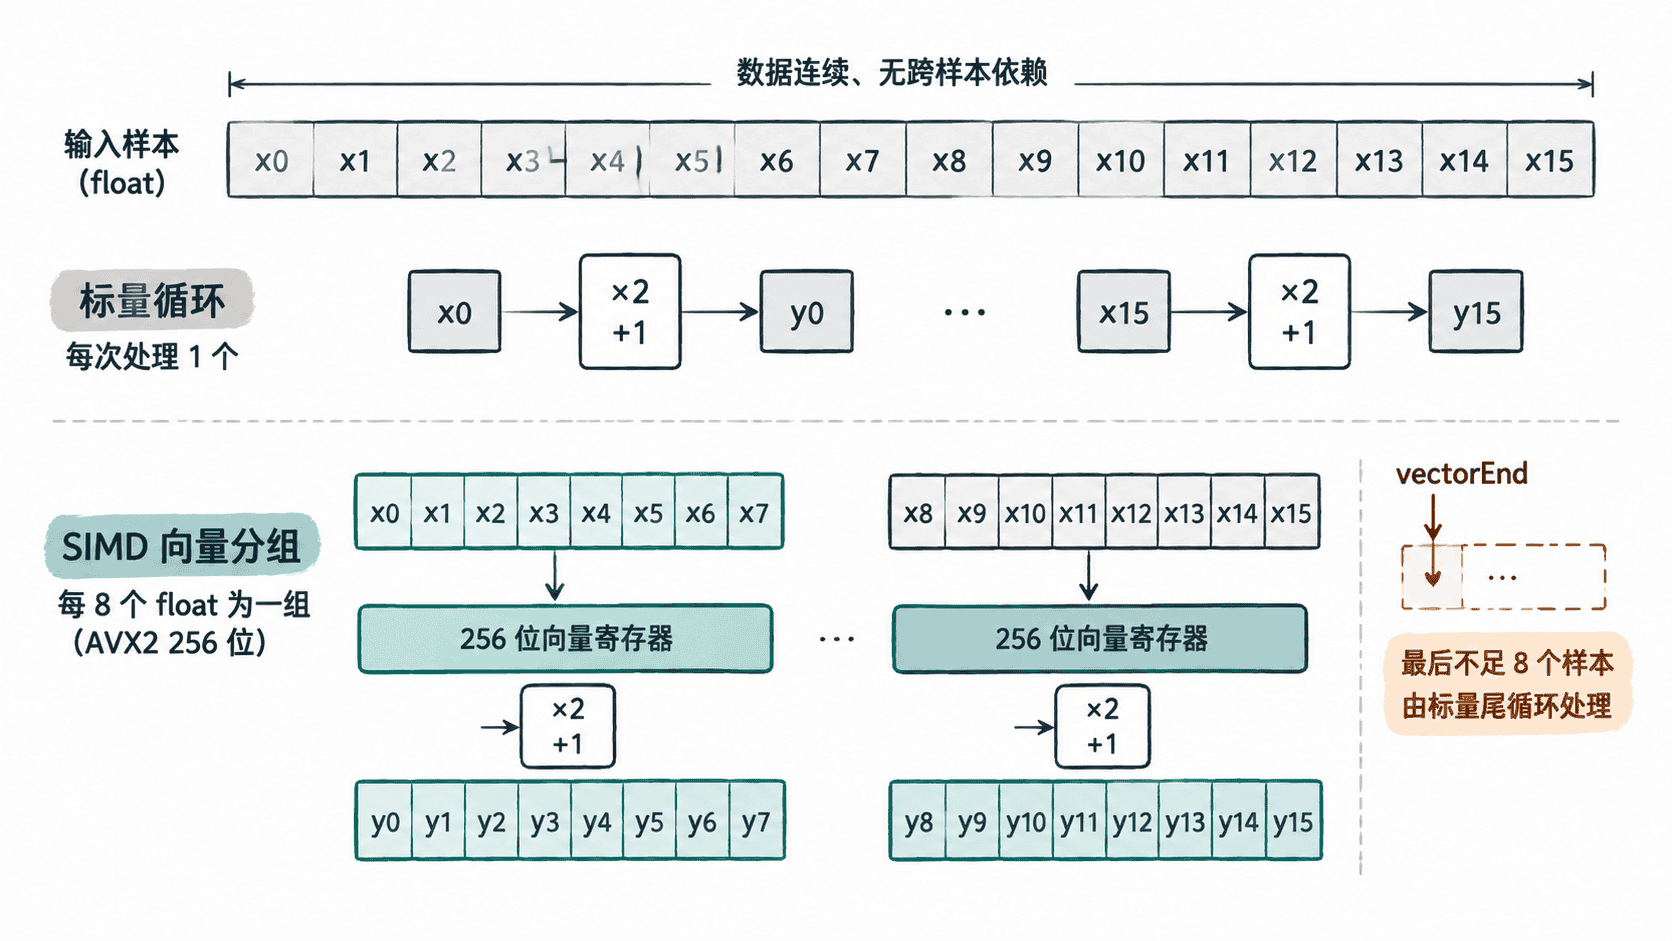
AVX2 的 256 位寄存器可以同时容纳 8 个单精度浮点数。若缓冲区起始地址未保证 32 字节对齐,使用 _mm256_loadu_ps 与 _mm256_storeu_ps 最稳妥;只有在分配器明确保证 32 字节对齐时,才应改用对齐加载版本。
完成一个可验证的 AVX2 混音器
下面程序面向支持 AVX2 的 x86-64 CPU,同时实现标量版与 AVX2 版。simdMix 先处理完整的 8 样本块,再用普通循环处理尾部,因此样本数不必是 8 的整数倍;ARM 平台可用 NEON 按同样结构实现。
#include <immintrin.h>
#include <algorithm>
#include <chrono>
#include <cmath>
#include <cstddef>
#include <iostream>
#include <vector>

void scalarMix(const float* a, const float* b, float* out,
               std::size_t n, float ga, float gb) {
    for (std::size_t i = 0; i < n; ++i) {
        out[i] = a[i] * ga + b[i] * gb;
    }
}

void simdMix(const float* a, const float* b, float* out,
             std::size_t n, float ga, float gb) {
    const __m256 vga = _mm256_set1_ps(ga);
    const __m256 vgb = _mm256_set1_ps(gb);
    const std::size_t vectorEnd = n - (n % 8);

    for (std::size_t i = 0; i < vectorEnd; i += 8) {
        // loadu/storeu 不要求调用方提供 32 字节对齐地址。
        const __m256 va = _mm256_loadu_ps(a + i);
        const __m256 vb = _mm256_loadu_ps(b + i);
        const __m256 mixed = _mm256_add_ps(
            _mm256_mul_ps(va, vga),
            _mm256_mul_ps(vb, vgb)
        );
        _mm256_storeu_ps(out + i, mixed);
    }

    // 尾部不足 8 个样本时回退到标量,避免越界读写。
    for (std::size_t i = vectorEnd; i < n; ++i) {
        out[i] = a[i] * ga + b[i] * gb;
    }
}

volatile float gSink = 0.0f;

template <class F>
double benchMs(F fn, int rounds) {
    const auto begin = std::chrono::steady_clock::now();
    for (int r = 0; r < rounds; ++r) {
        fn(r);
    }
    const auto end = std::chrono::steady_clock::now();
    return std::chrono::duration<double, std::milli>(end - begin).count();
}

int main() {
    constexpr std::size_t n = 48000 * 4 + 3; // 故意留下 3 个尾部样本
    constexpr int rounds = 1000;
    std::vector<float> a(n, 0.25f);
    std::vector<float> b(n, -0.10f);
    std::vector<float> scalarOut(n);
    std::vector<float> simdOut(n);

    scalarMix(a.data(), b.data(), scalarOut.data(), n, 0.8f, 0.5f);
    simdMix(a.data(), b.data(), simdOut.data(), n, 0.8f, 0.5f);

    float maxError = 0.0f;
    for (std::size_t i = 0; i < n; ++i) {
        maxError = std::max(maxError, std::fabs(scalarOut[i] - simdOut[i]));
    }

    const double scalarMs = benchMs([&](int r) {
        scalarMix(a.data(), b.data(), scalarOut.data(), n, 0.8f, 0.5f);
        gSink = gSink + scalarOut[(static_cast<std::size_t>(r) * 131) % n];
    }, rounds);
    const double simdMs = benchMs([&](int r) {
        simdMix(a.data(), b.data(), simdOut.data(), n, 0.8f, 0.5f);
        gSink = gSink + simdOut[(static_cast<std::size_t>(r) * 131) % n];
    }, rounds);

    std::cout << "max error: " << maxError << '\n';
    std::cout << "scalar ms: " << scalarMs << '\n';
    std::cout << "simd ms: " << simdMs << '\n';
}
预期结果
max error: 0
scalar ms: <SCALAR_MS>
simd ms: <SIMD_MS>
其中耗时会随 CPU、编译器和电源状态变化。GCC 或 Clang 基准构建可使用 C++17、-O3 与 -mavx2;为了隔离手写 SIMD 的收益,可暂时加入 -fno-tree-vectorize,正式构建时再移除它,与编译器自动向量化后的标量代码重新比较。
自动向量化为什么会失效
编译器最喜欢连续内存、固定步长、无条件分支且不同迭代彼此独立的循环。循环里出现数据依赖、难以证明不重叠的指针别名、复杂函数调用或每个样本走不同分支时,自动向量化就可能停下来。
GCC 可在编译时增加 -fopt-info-vec-optimized -fopt-info-vec-missed 查看哪些循环被向量化或为何失败。Clang 可使用 -Rpass=loop-vectorize -Rpass-missed=loop-vectorize。不要只看源码“像不像 SIMD”,应以编译报告或反汇编确认。
基准测试要避开的误区
基准测试至少要做到三件事:先验证 SIMD 与标量结果一致;使用足够大的缓冲区和重复次数,降低计时噪声;让测试结果真正被读取,避免编译器把无用计算消掉。还要固定相同输入和编译优化级别,否则数字没有可比性。
在真实音频回调里,最终指标不是“某个循环快了几倍”,而是整个 block 的处理时间是否稳定低于音频设备给出的 deadline。若 SIMD 版本增加了分支、拷贝或跨平台维护成本,却没有降低端到端回调耗时,就没有必要保留它。