
音频开发 / 系统课时
把连续声音映射成离散样本
把连续声音映射成离散样本
这一节把“声音如何变成数字”落到可观察的样本序列:先把连续时间按固定间隔取点,再把每个取样值表示为有限精度的数字。你会用一个正弦信号直接看到采样不足如何产生混叠,并用离散频谱验证结果。
学习目标
- 区分时间离散化与幅值量化,理解一个数字样本实际记录了什么。
- 根据采样率判断可表示频率范围,并解释混叠为何无法靠后处理恢复。
- 用可运行代码生成离散样本,并从频谱中确认混叠频率。
从连续波形到样本序列
麦克风输出可以看成随时间连续变化的信号 。采样器每隔 秒读取一次幅值,得到离散序列 ,其中采样率 。时间因此从“任意时刻”变成了 这些离散位置。
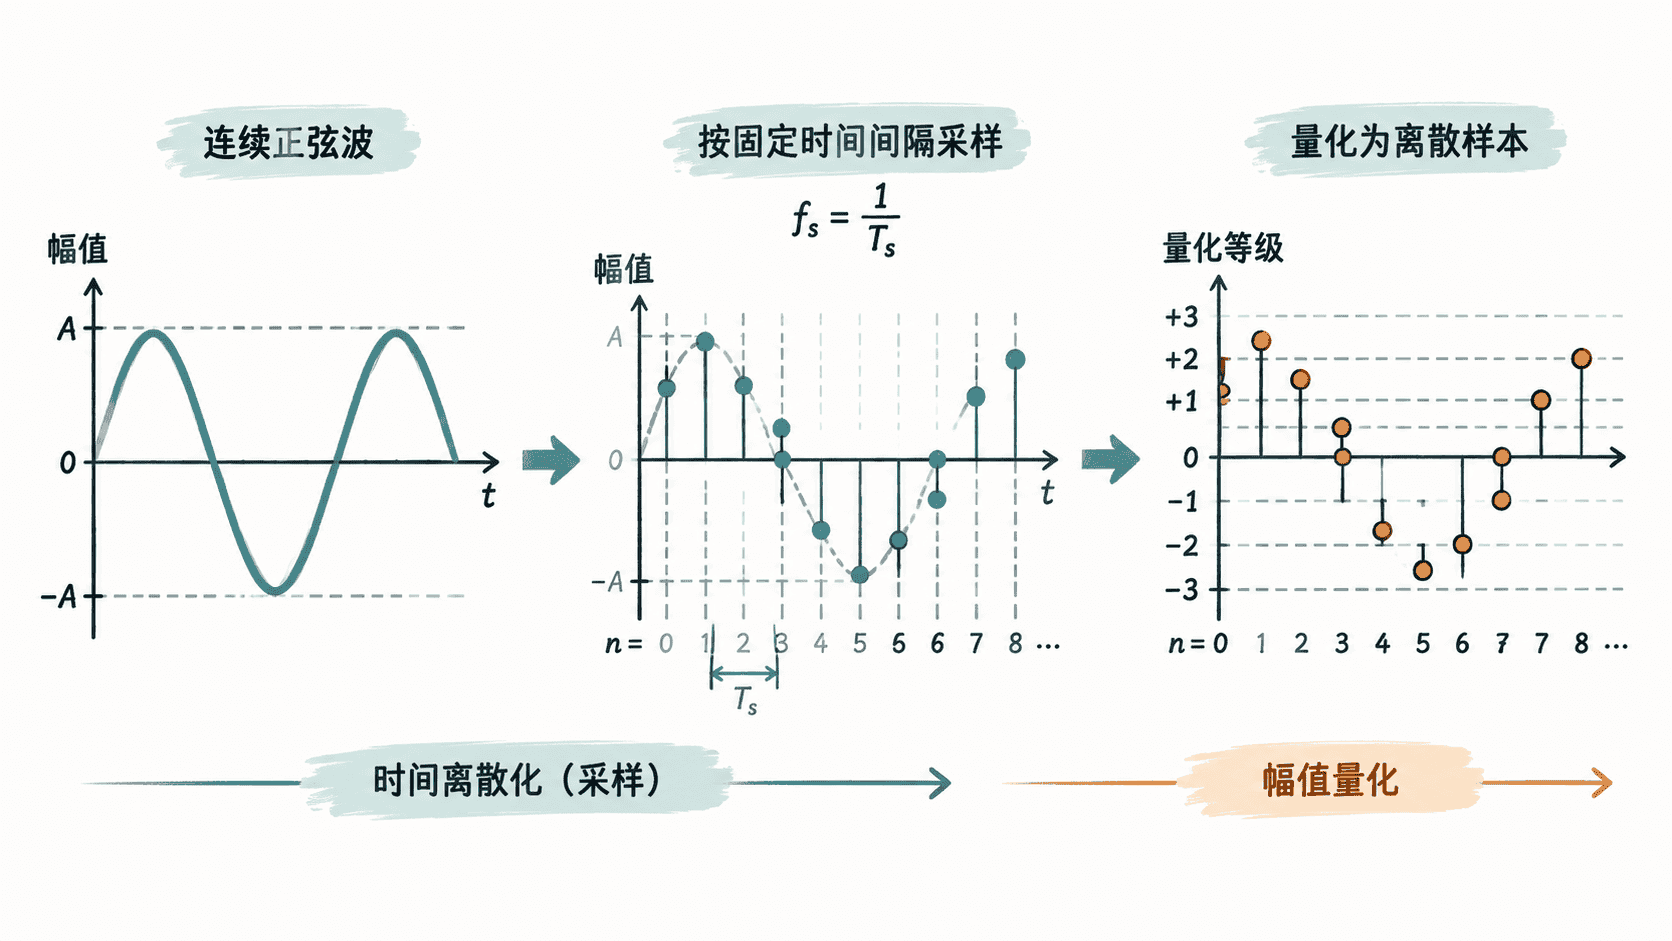
采样只决定“什么时候读一次”,量化决定“每次读到的幅值能表示多细”。例如 16 位有符号 PCM 常用整数范围约为 到 ;浮点 DSP 链路则常把满幅归一化到 附近。量化精度不足会带来量化误差,但它和采样率不足导致的混叠不是同一种问题。
采样不足为什么会变成另一个频率
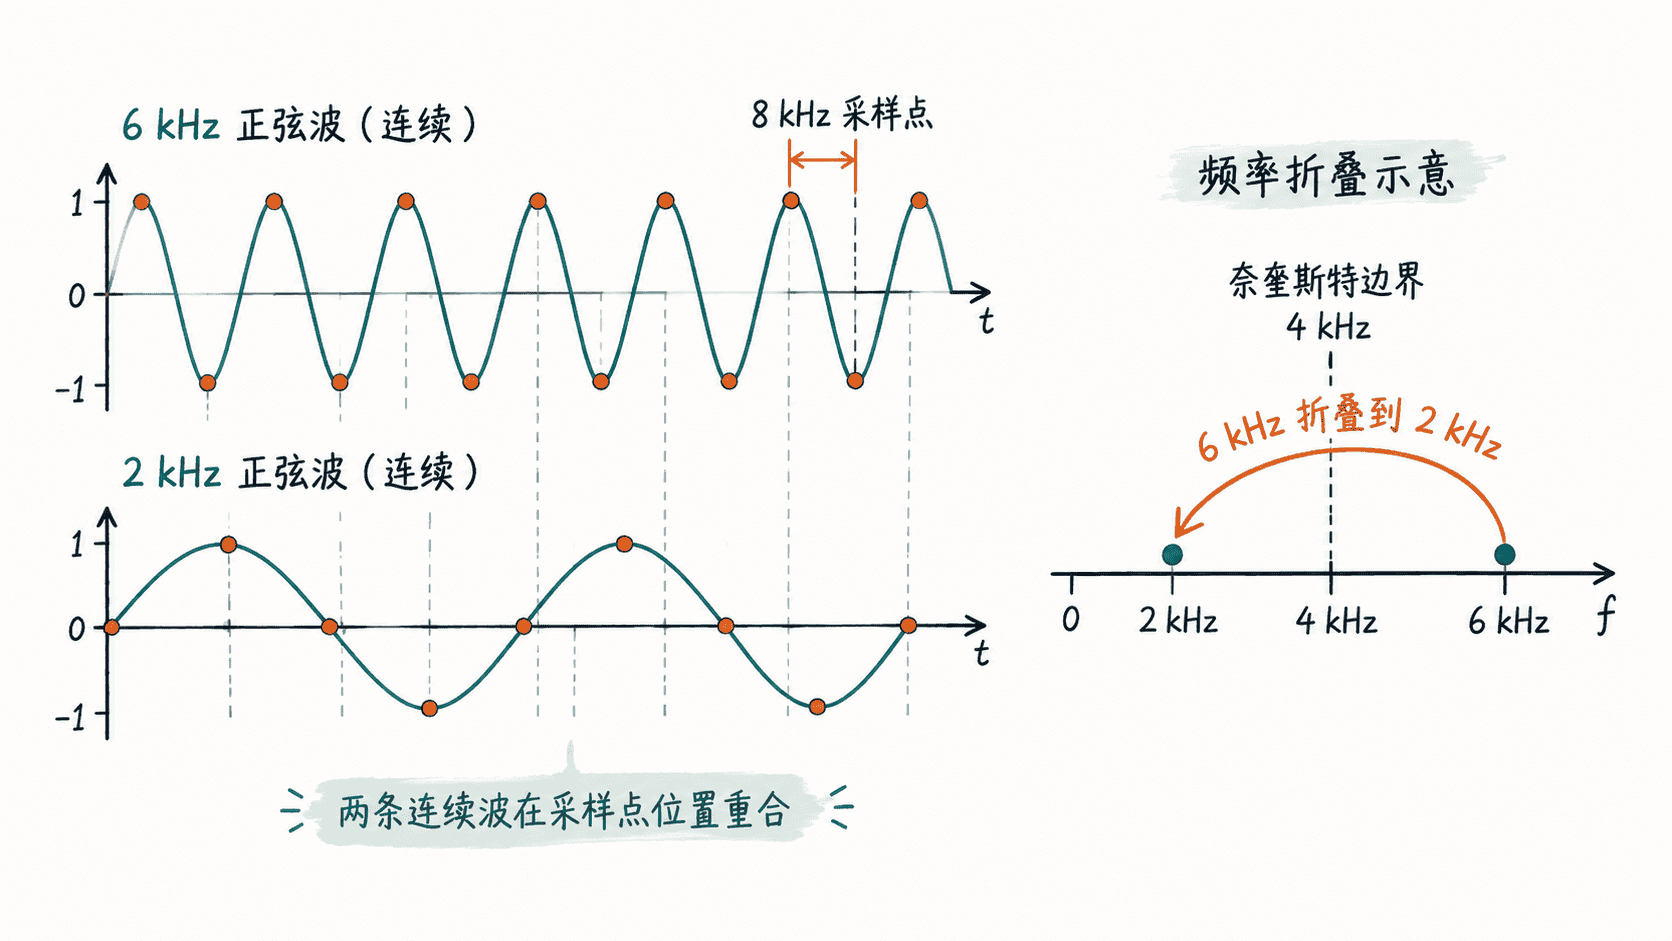
理想采样要求原信号在采样前已经限带,并满足最高频率低于奈奎斯特频率 。一旦信号频率超过这个边界,不同连续频率可能落到同一组离散采样点上,采样后就无法判断原来究竟是哪一个频率。
例如以 采样 正弦波,离散序列会表现成 的低频分量。这个现象就是混叠。
用代码观察混叠
下面只用 Python 标准库生成 32 个采样点,再计算离散傅里叶变换。输入信号是 6 kHz,采样率是 8 kHz,因此频谱峰值会落在 2 kHz。
python
import math
import cmath

fs = 8000
signal_hz = 6000
n_samples = 32

samples = [
    math.sin(2 * math.pi * signal_hz * n / fs)
    for n in range(n_samples)
]

# 只检查 0 到奈奎斯特频率之间的 DFT 频点。
magnitudes = []
for k in range(n_samples // 2):
    spectrum_bin = sum(
        samples[n] * cmath.exp(-2j * math.pi * k * n / n_samples)
        for n in range(n_samples)
    )
    magnitudes.append(abs(spectrum_bin))

peak_bin = max(range(len(magnitudes)), key=magnitudes.__getitem__)
peak_hz = peak_bin * fs / n_samples

print([round(x, 3) for x in samples[:8]])
print(f"peak_hz={peak_hz:.0f}")
预期输出:
text
[0.0, -1.0, 0.0, 1.0, -0.0, -1.0, 0.0, 1.0]
peak_hz=2000
由于浮点三角函数存在极小舍入误差,个别本应为零的值可能显示成 -0.0,但频谱峰值仍应位于 2000 Hz。
判断一条采样链路是否可靠
面对实际音频时,先确定目标信号的最高有效频率,再选择足够高的采样率,并确认输入端存在合适的抗混叠低通滤波。采样率负责时间分辨能力,量化精度负责幅值分辨能力;两者共同决定数字表示质量,但不能互相补偿。
如果你看到频谱里出现“本来不该存在”的低频分量,尤其是在降采样后出现,应优先检查降采样前是否正确限带,而不是先提高 FFT 分辨率或盲目做后级滤波。
按自己的节奏,确认真正理解。