
音频开发 / 系统课时
用 FFT 卷积处理长脉冲响应
用 FFT 卷积处理长脉冲响应
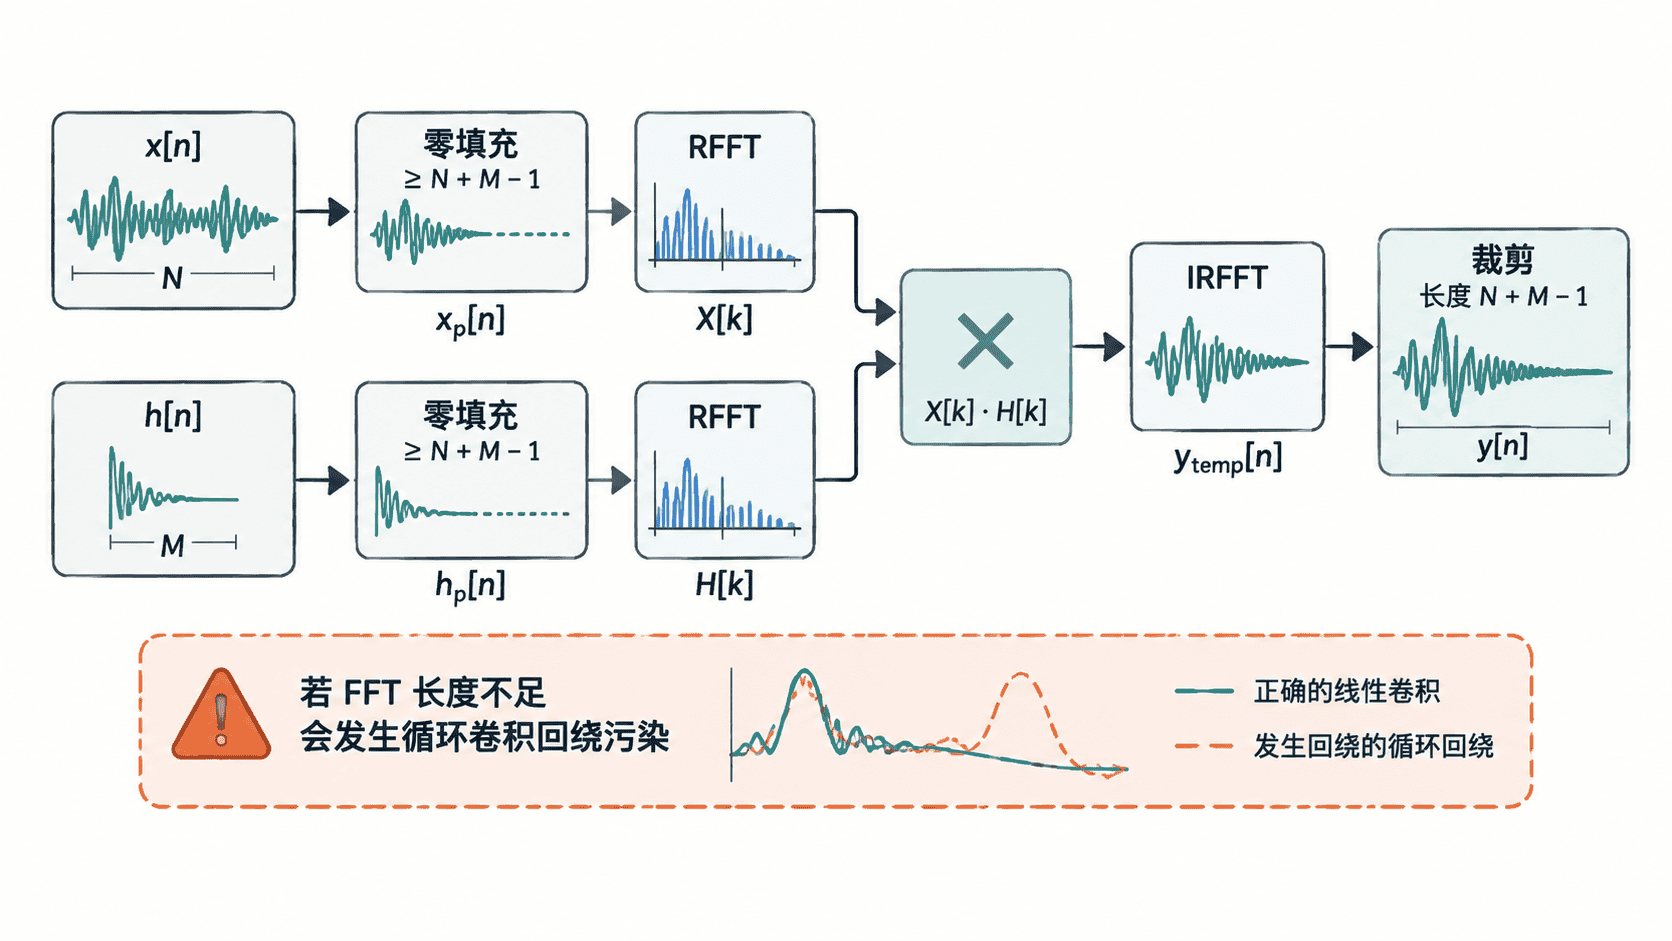
当 FIR 或房间脉冲响应长到几千、几万点时,逐样本时域卷积会迅速变慢。本课把线性卷积改写为“补零 → FFT → 频域相乘 → IFFT”,验证它与 numpy.convolve 的结果一致,并用分块测试观察 FFT 块长对吞吐和计算开销的影响。
学习目标
- 理解线性卷积为什么可以转成频域乘法,以及为什么必须补零
- 用 NumPy 实现可运行的 FFT 卷积并验证数值误差
- 通过不同块长的基准测试理解吞吐、延迟与 FFT 开销之间的权衡
从时域卷积切到频域
长度为 的输入 与长度为 的脉冲响应 做线性卷积,输出长度是 。直接卷积大约需要 次乘加;当 很长时,这个成本会成为实时音频链路的瓶颈。
卷积定理给出:
因此可以先把两个序列变换到频域,逐点相乘后再做逆变换。FFT 的复杂度近似为 ,其中 是 FFT 长度。关键是 不能小于 ,否则计算得到的是循环卷积,尾部会绕回到开头并污染结果。
实现并验证 FFT 卷积
下面的程序只依赖 NumPy。next_pow2 把 FFT 长度取到不小于目标长度的 2 的幂,通常能获得较好的 FFT 执行效率;irfft(..., n=n_fft) 则保证逆变换长度与频谱对应。
import numpy as np

def next_pow2(n: int) -> int:
    return 1 << (n - 1).bit_length()

def fft_convolve(x: np.ndarray, h: np.ndarray) -> np.ndarray:
    out_len = len(x) + len(h) - 1
    n_fft = next_pow2(out_len)

    x_spec = np.fft.rfft(x, n=n_fft)
    h_spec = np.fft.rfft(h, n=n_fft)
    y = np.fft.irfft(x_spec * h_spec, n=n_fft)

    # 逆变换包含补零区,只保留线性卷积的有效长度。
    return y[:out_len]

if __name__ == "__main__":
    rng = np.random.default_rng(7)
    x = rng.standard_normal(4096)
    h = rng.standard_normal(1024)

    y_time = np.convolve(x, h)
    y_fft = fft_convolve(x, h)

    max_error = np.max(np.abs(y_time - y_fft))
    print("output_length =", len(y_fft))
    print("max_abs_error =", f"{max_error:.3e}")
    print("allclose =", np.allclose(y_time, y_fft, rtol=1e-10, atol=1e-10))
预期输出如下。浮点误差的具体末位会因 NumPy、CPU 和 FFT 实现不同而略有变化。
output_length = 5119
max_abs_error = <FLOAT_AROUND_1E-13>
allclose = True
真正要检查的不是误差恰好等于某个常数,而是输出长度为 N + M - 1,并且 allclose 为 True。如果误差很大,优先检查 FFT 长度、逆变换长度和最终裁剪范围。
为什么补零不能省
假设输入长度为 8、滤波器长度为 5,那么线性卷积长度应为 12。若只使用长度 8 的 FFT,时域中索引 8~11 的尾部会按模 8 回卷到索引 0~3,这就是循环卷积。
对实数音频,优先使用 rfft/irfft。它只保存非负频率一侧的频谱,比通用 fft/ifft 少处理近一半冗余数据,而且输出仍能恢复为实数序列。
用块长观察性能差异
实时系统不会等整段音频结束后再做一次大 FFT,而是把输入切成块。下面用标准 Overlap-Add 作为测试外壳,只改变输入块长,记录总处理时间。它能直接展示“块太小,FFT 次数多;块太大,单次 FFT 更重且算法延迟更高”的权衡。
import time
import numpy as np

def next_pow2(n: int) -> int:
    return 1 << (n - 1).bit_length()

def ola_fft_convolve(x: np.ndarray, h: np.ndarray, block_size: int) -> np.ndarray:
    n_fft = next_pow2(block_size + len(h) - 1)
    h_spec = np.fft.rfft(h, n=n_fft)
    y = np.zeros(len(x) + len(h) - 1)

    for start in range(0, len(x), block_size):
        block = x[start:start + block_size]
        block_spec = np.fft.rfft(block, n=n_fft)
        block_y = np.fft.irfft(block_spec * h_spec, n=n_fft)
        valid_len = len(block) + len(h) - 1
        y[start:start + valid_len] += block_y[:valid_len]

    return y

if __name__ == "__main__":
    rng = np.random.default_rng(11)
    x = rng.standard_normal(48000 * 4)
    h = rng.standard_normal(4096)

    for block_size in (256, 512, 1024, 2048, 4096):
        t0 = time.perf_counter()
        y = ola_fft_convolve(x, h, block_size)
        elapsed_ms = (time.perf_counter() - t0) * 1000
        print(f"block={block_size:4d}, output={len(y)}, elapsed_ms={elapsed_ms:.2f}")
预期结果不是固定耗时,而是每一行的 output 都应为 196095,并能看到不同块长的耗时存在明显差异。
block= 256, output=196095, elapsed_ms=<MACHINE_DEPENDENT>
block= 512, output=196095, elapsed_ms=<MACHINE_DEPENDENT>
block=1024, output=196095, elapsed_ms=<MACHINE_DEPENDENT>
block=2048, output=196095, elapsed_ms=<MACHINE_DEPENDENT>
block=4096, output=196095, elapsed_ms=<MACHINE_DEPENDENT>
不要直接把“耗时最低的块长”当成实时系统的最佳值。块长增大通常能减少 FFT 次数,却也会增加缓冲等待和处理延迟;工程上要同时看 CPU 占用、音频回调周期和端到端延迟。
什么时候 FFT 卷积更合适
短 FIR 只有几十个 tap 时,直接时域卷积常常更简单,缓存局部性也更好;长房间脉冲响应、混响器、扬声器校正和长均衡器则更适合 FFT 卷积。判断标准不是“FFT 一定更快”,而是滤波器长度、块长、目标延迟和平台 FFT 实现共同决定的总成本。
完成验证后,应把“频域乘法得到线性卷积”的成立条件记成一个硬约束:FFT 长度必须覆盖线性卷积长度。在长 FIR 场景中,这个约束比具体 API 更重要。