
音频开发 / 系统课时
用频谱减法压低稳定噪声
用频谱减法压低稳定噪声
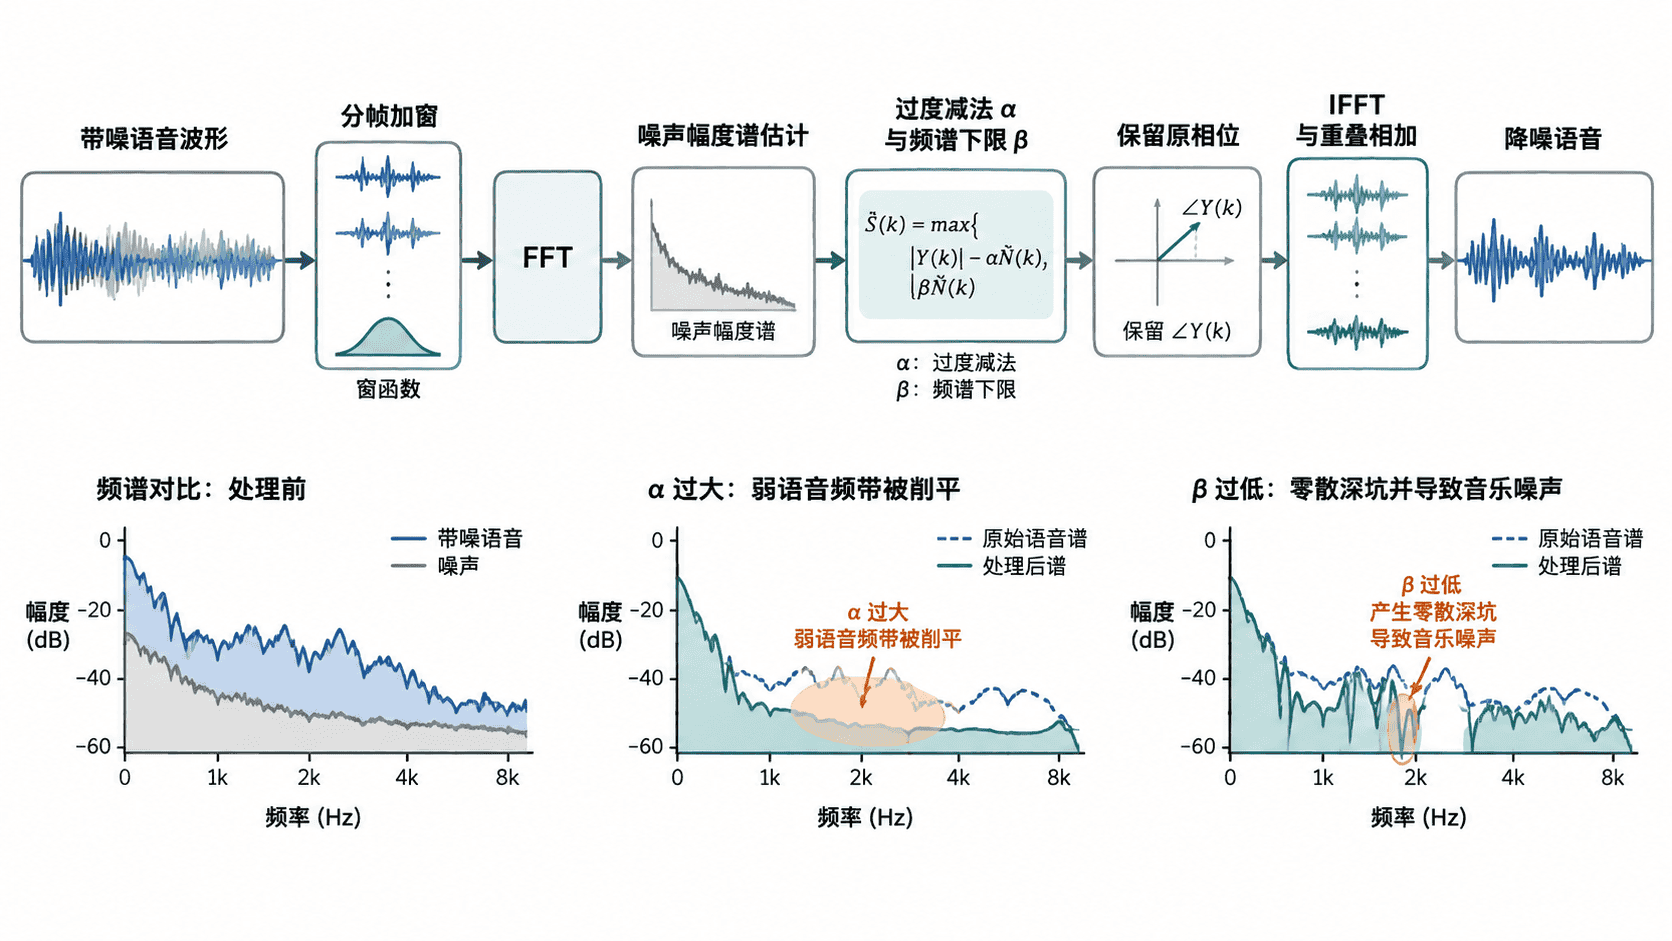
频谱减法适合处理风扇声、空调底噪这类相对稳定的加性噪声:先估计噪声频谱,再从每帧语音的频谱中扣除对应能量。真正决定听感的不是“减得越多越好”,而是过度减法系数、频谱下限和噪声估计何时更新。
学习目标
- 能说明频谱减法从分帧、噪声估计到重建语音的完整链路
- 能调节过度减法系数与频谱下限,在降噪量和自然度之间取舍
- 能识别音乐噪声及“弱语音被当成噪声”这两类典型失真
频谱减法到底减什么
设一帧带噪语音的频谱为 Y,稳定噪声的估计幅度谱为 D。最简单的做法是在幅度域计算 |Y| - α|D|,其中 α 是过度减法系数;然后保留原始带噪语音的相位,用新的幅度谱做逆 FFT。
直接减法会产生负值,因此通常再设一个频谱下限 β|D|。可以把每个频点的处理写成“减法后不能低于下限”:
α 越大,残留噪声越低,但辅音、尾音和弱语音也更容易被削掉;β 越小,频谱中越容易出现零散的深坑,帧与帧之间随机变化后就会形成带有金属感的“音乐噪声”。
用一个最小实现跑通链路
下面示例对一段合成的“弱语音 + 稳定白噪声”做频谱减法。为了让示例可直接运行,只依赖 NumPy;真实工程里应从 VAD 判定的非语音帧持续更新噪声谱,而不是固定取最前面的若干帧。
import numpy as np

def spectral_subtract(x, fs=16000, frame_size=512, hop=256,
                      noise_frames=6, alpha=1.5, beta=0.05):
    window = np.hanning(frame_size)
    out = np.zeros(len(x) + frame_size)
    weight = np.zeros_like(out)
    mags = []
    phases = []

    for start in range(0, len(x) - frame_size + 1, hop):
        frame = x[start:start + frame_size] * window
        spectrum = np.fft.rfft(frame)
        mags.append(np.abs(spectrum))
        phases.append(np.angle(spectrum))

    # 只用已知的非语音帧估计稳定噪声,避免把语音写进噪声模型。
    noise_mag = np.mean(mags[:noise_frames], axis=0)

    for i, (mag, phase) in enumerate(zip(mags, phases)):
        cleaned_mag = np.maximum(mag - alpha * noise_mag, beta * noise_mag)
        cleaned = np.fft.irfft(cleaned_mag * np.exp(1j * phase))
        start = i * hop
        out[start:start + frame_size] += cleaned * window
        weight[start:start + frame_size] += window ** 2

    valid = weight > 1e-8
    out[valid] /= weight[valid]
    return out[:len(x)]

rng = np.random.default_rng(7)
fs = 16000
duration = 0.6
t = np.arange(int(fs * duration)) / fs

# 前 0.2 秒只有稳定噪声,后面加入弱的 220 Hz 语音样式基音。
noise = 0.02 * rng.standard_normal(len(t))
speech = np.zeros_like(t)
speech[t >= 0.2] = 0.06 * np.sin(2 * np.pi * 220 * t[t >= 0.2])
noisy = speech + noise

cleaned = spectral_subtract(noisy, fs=fs)
print("长度一致:", len(cleaned) == len(noisy))
print("输出有限:", bool(np.isfinite(cleaned).all()))
预期输出:
长度一致: True
输出有限: True
这个输出只验证处理链路和重叠相加没有破坏样本长度或产生非法数值。实际音质验证还要比较语音段与非语音段的频谱、监听辅音和尾音,并检查是否出现窄带、随机跳动的“啾啾声”。
调参数时先听什么
α 可以理解为“减得有多狠”。稳定底噪明显、语音较强时可适当增大;弱语音很多时应保守。若发现擦音、齿音变薄,或者句尾被吃掉,通常说明 α 过大或噪声估计被语音污染。
β 是防止频谱被挖空的安全垫。它不会直接告诉你“该留多少噪声”,而是在局部减法过强时保留最低能量。音乐噪声明显时,除了适当提高 β,还可以对噪声谱做时间平滑、频率平滑,避免相邻帧出现过于随机的深窄谱洞。
弱语音为什么最容易受伤
频谱减法最危险的前提错误,是把弱语音帧当成纯噪声。这样估计得到的 D 里会混入真实语音频带,后续每一帧都会持续“减掉这部分语音”,形成不可逆的发闷、齿音缺失或尾音截断。
工程上通常把噪声更新与 VAD 联动:只有确认当前帧是非语音时才快速更新噪声谱;检测到语音后冻结或极慢更新。对空调、风扇这类稳定噪声,还可以给噪声谱使用指数平滑,让估计缓慢跟随环境变化而不是追逐瞬时能量。
判断这类降噪是否成功,不只看“安静了多少”,还要同时确认语音清晰度、音色连续性和弱语音保真。能压低稳定底噪,同时不让弱音节和辅音明显受损,才算参数进入可用区间。