
音频开发 / 系统课时
用 VAD 区分语音与非语音
用 VAD 区分语音与非语音
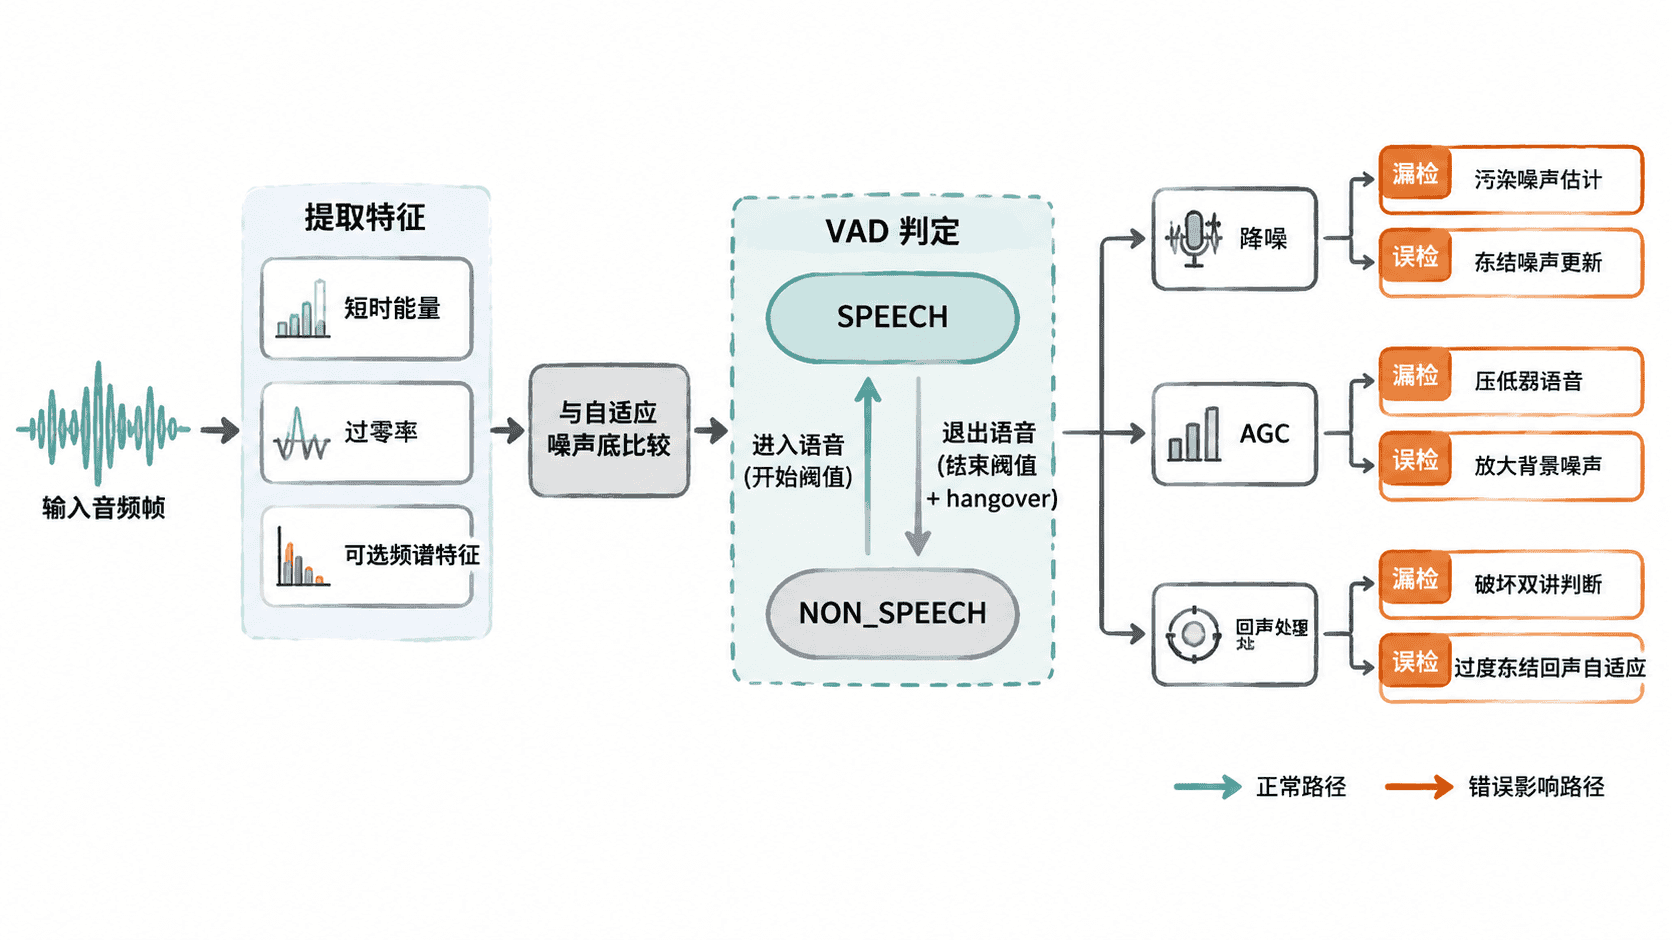
VAD 的任务不是识别说了什么,而是判断当前短时帧里“有没有有效语音”。这个二值结果会直接控制噪声估计、AGC 和回声处理,因此漏检与误检都可能被后续模块放大。本节用短时能量、过零率和迟滞机制搭一个轻量、可验证的 VAD。
学习目标
- 能用短时能量与过零率构造轻量 VAD 判据
- 能解释漏检和误检分别怎样影响降噪、AGC 与回声处理
- 能通过自适应噪声底、双阈值和 hangover 提升不同噪声下的稳定性
两个特征先解决大部分问题
短时能量回答“这一帧有多响”,过零率回答“波形符号变化有多频繁”。浊音通常能量明显高于背景噪声,且过零率相对较低;白噪声虽然能量可能很高,但过零率往往接近随机信号的高水平。
只用能量阈值时,突然变大的风噪或键盘声很容易误判为语音;只用过零率又会漏掉擦音等高频语音。轻量 VAD 常把多个弱特征组合起来,再让阈值相对“当前噪声底”自适应,而不是写死一个绝对幅度。
实现一个带迟滞的轻量 VAD
下面示例先用两帧背景噪声估计噪声均方根,再要求“能量显著高于噪声底且过零率较低”才进入语音状态。检测到语音后保留两个 hangover 帧,避免词尾或短暂停顿把状态频繁切断。
import numpy as np

class SimpleVAD:
    def __init__(self, noise_rms, start_ratio=3.0, stop_ratio=1.8,
                 zcr_limit=0.25, hangover=2):
        self.noise_rms = max(noise_rms, 1e-6)
        self.start_ratio = start_ratio
        self.stop_ratio = stop_ratio
        self.zcr_limit = zcr_limit
        self.hangover = hangover
        self.in_speech = False
        self.left = 0

    def detect(self, frame):
        rms = float(np.sqrt(np.mean(frame ** 2)))
        zcr = float(np.mean(frame[:-1] * frame[1:] < 0))
        ratio = rms / self.noise_rms

        # 进入语音用高阈值,退出语音用低阈值,避免状态在边界抖动。
        active = ratio >= (self.stop_ratio if self.in_speech else self.start_ratio)
        active = active and zcr <= self.zcr_limit

        if active:
            self.in_speech = True
            self.left = self.hangover
        elif self.in_speech and self.left > 0:
            self.left -= 1
        else:
            self.in_speech = False

        return self.in_speech

rng = np.random.default_rng(3)
fs = 16000
n = 320
t = np.arange(n) / fs

noise_a = 0.01 * rng.standard_normal(n)
noise_b = 0.01 * rng.standard_normal(n)
voice_a = 0.08 * np.sin(2 * np.pi * 200 * t) + 0.01 * rng.standard_normal(n)
voice_b = 0.06 * np.sin(2 * np.pi * 180 * t) + 0.01 * rng.standard_normal(n)
noise_c = 0.01 * rng.standard_normal(n)
noise_d = 0.01 * rng.standard_normal(n)
noise_e = 0.01 * rng.standard_normal(n)

noise_rms = float(np.median([
    np.sqrt(np.mean(noise_a ** 2)),
    np.sqrt(np.mean(noise_b ** 2)),
]))
vad = SimpleVAD(noise_rms=noise_rms, hangover=2)

frames = [noise_a, noise_b, voice_a, voice_b, noise_c, noise_d, noise_e]
states = [vad.detect(frame) for frame in frames]
print(states)
预期输出:
[False, False, True, True, True, True, False]最后两个 True 不是误检,而是有意设置的 hangover:语音结束后继续维持短暂活动状态,从而保护词尾和很短的停顿。第三个连续噪声帧才退出语音状态。
漏检与误检为什么后果不同
漏检是“有语音却判成非语音”。如果降噪模块只在非语音时更新噪声谱,漏检会把弱语音写入噪声模型,随后持续削弱相同频带;AGC 也可能错过需要增益的弱音节。回声处理中,近端语音漏检还可能让系统错误地继续自适应,影响双讲稳定性。
误检是“没有语音却判成语音”。降噪会因为冻结噪声更新而跟不上环境变化,AGC 可能把背景噪声当成目标语音放大;回声消除若长期把噪声误判成近端讲话,也会过度冻结滤波器更新。
因此 VAD 不能只追求“语音都别漏”。实际目标是在业务链路里控制两种错误的代价:通话保真优先时通常宁可多保留一点疑似语音,噪声估计则要防止被弱语音污染。
用不同噪声条件检查鲁棒性
测试时至少覆盖安静房间、稳定风扇声、宽带白噪声和突发键盘声。观察的不只是单帧准确率,还要看状态是否在边界快速抖动、词尾是否被切断,以及噪声变大后阈值能否跟随。
如果稳定风扇声因为低过零率而频繁误检,可以再加入频谱平坦度或带通能量比;如果擦音漏检,则应放宽单一过零率限制,并把频谱特征作为补充。轻量 VAD 的关键不是堆很多特征,而是让特征、阈值和状态机共同服务于后面的降噪、增益和回声链路。