
音频开发 / 系统课时
理解抽取插值中的混叠
理解抽取插值中的混叠
抽取和插值看似只是“少取几个样本”或“中间补零”,真正改变的却是频谱副本的位置。本课用两个确定频率的正弦信号直接观察折叠与镜像,并生成可试听 WAV,理解为什么混叠一旦发生就不能靠后续滤波恢复。
学习目标
- 解释整数抽取为什么会把高于新奈奎斯特频率的成分折叠到低频
- 解释插零升采样为什么会产生频谱镜像,以及低通滤波的作用
- 用频谱峰值和试听文件确认混叠造成的信息丢失
抽取为什么会发生频谱折叠
把离散信号按整数倍率 抽取,就是只保留每隔 个样本中的一个:。采样率同时从 变成 ,新的奈奎斯特频率也降为 。原信号中超过这个上限的频率不会“自动消失”,而会折回新的可表示频带。
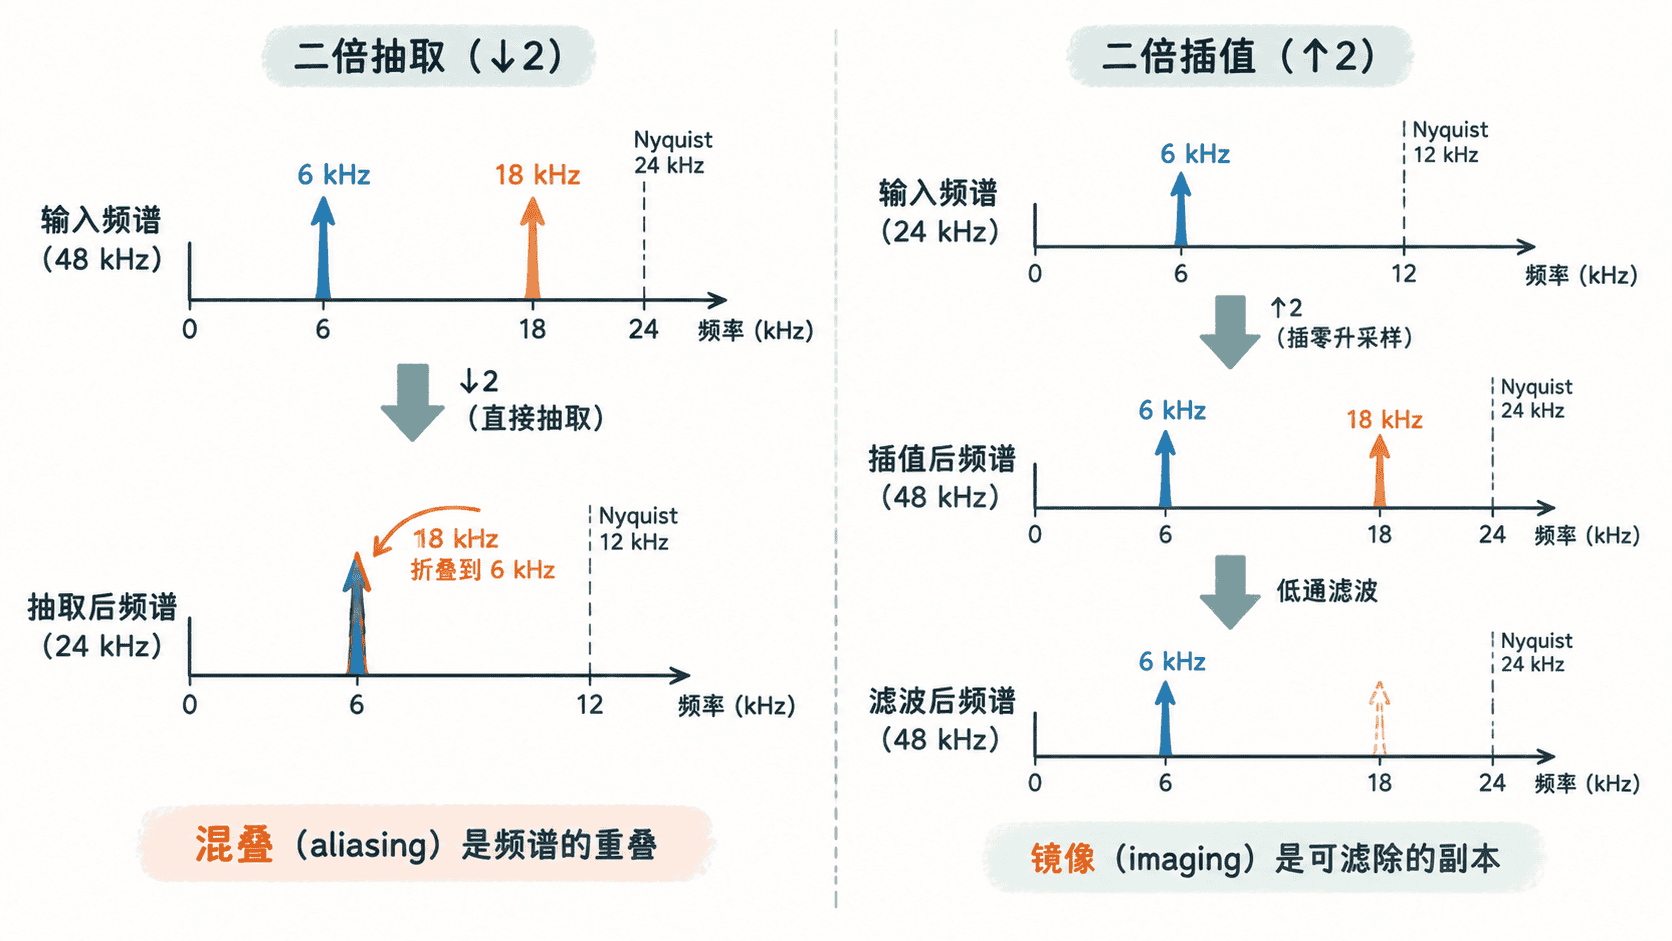
例如 48 kHz 音频直接二倍抽取到 24 kHz 后,新奈奎斯特频率只有 12 kHz。原来的 18 kHz 分量会折叠到 6 kHz。此时频谱中已经无法区分“原本存在 6 kHz”还是“18 kHz 混叠而来”,所以后级低通滤波无法逆转这次信息合并。
插零为什么会产生频谱镜像
二倍插值先把采样率的时间网格加密,再在原样本之间插入一个零。这个操作并没有创造新的带限波形,只是把原频谱压缩后周期性复制到新的频带,因此会出现镜像。
以 24 kHz、6 kHz 正弦为例,二倍插零后输出采样率变为 48 kHz。除了 6 kHz 主分量,还会在 18 kHz 处出现镜像。与抽取混叠不同,这些镜像在频谱上仍与基带分离,所以可以在插零之后用低通滤波器清除。
用一个可运行示例同时观察两种现象
下面的 Python 示例使用整秒信号,让 18 kHz、6 kHz 都正好落在 FFT 频点上,因此主峰位置稳定可复现。它还会写出原始 18 kHz 和直接抽取后的 WAV,便于实际试听混叠结果。
import numpy as np
from scipy.io.wavfile import write

def dominant_freqs(x, fs, count=2):
    spectrum = np.abs(np.fft.rfft(x))
    freqs = np.fft.rfftfreq(len(x), d=1 / fs)
    # 跳过直流分量,只取幅度最大的若干个频点。
    index = np.argsort(spectrum[1:])[-count:] + 1
    return sorted(round(float(freqs[i])) for i in index)

fs = 48_000
t = np.arange(fs) / fs
x = np.sin(2 * np.pi * 18_000 * t)

# 不加抗混叠滤波,直接二倍抽取。
down = x[::2]
print("direct downsample:", dominant_freqs(down, fs / 2, 1))

fs_low = 24_000
t_low = np.arange(fs_low) / fs_low
low = np.sin(2 * np.pi * 6_000 * t_low)

# 插零把采样率升到 48 kHz,但此时尚未做抗镜像低通。
up = np.zeros(len(low) * 2)
up[::2] = low
print("zero-insert upsample:", dominant_freqs(up, fs_low * 2, 2))

# 写出可试听文件;16 位 PCM 便于普通播放器直接打开。
write("original-18k.wav", fs, np.int16(x * 32767))
write("aliased-6k.wav", fs // 2, np.int16(down * 32767))
print("wrote: original-18k.wav, aliased-6k.wav")
预期输出
direct downsample: [6000]
zero-insert upsample: [6000, 18000]
wrote: original-18k.wav, aliased-6k.wav
播放两个 WAV 时,第二个文件会听成约 6 kHz,而不是“较低采样率下仍然存在的 18 kHz”。这说明混叠不是显示层面的频谱误差,而是采样后数据本身已经变成了另一个低频序列。
重采样时滤波器应该放在哪里
抽取时,低通滤波必须放在降采样之前,把高于目标奈奎斯特频率的内容先压下去;一旦先抽取再滤波,高频已经和低频叠在一起。插值时则先插零,再在更高采样率上低通,以清除新产生的镜像并恢复连续的样本间波形。
实际工程里,多相滤波会把“滤波 + 抽取”或“插零 + 滤波”合并计算,避免显式处理大量将被丢弃的样本或零值。但无论实现如何优化,设计约束都不变:降采样先抗混叠,升采样后抗镜像。