
音频开发 / 系统课时
对比处理前后的客观指标
对比处理前后的客观指标
音频处理“听起来更好”并不等于真的解决了问题。本节建立一套可重复的前后对比方法,用同一段素材同时检查峰值、RMS、频谱、SNR、延迟与 CPU 代价,并给出能用于回归测试的判定方式。
学习目标
- 能为处理前后素材建立公平、可重复的对比条件。
- 能计算峰值、RMS、SNR 与频谱差异,并理解每个指标回答的问题。
- 能把音质收益与延迟、CPU 占用放在同一张验收表里判断是否值得上线。
先把比较条件固定下来
客观评估最怕“比较对象不是同一件事”。处理前、处理后以及干净参考信号必须使用相同采样率、声道数和截取区间;如果算法引入了固定延迟,还要先做时间对齐,否则 SNR 会被错位直接拉低。
峰值和 RMS 不要在比较前分别做归一化。分别归一化会抹掉 AGC、限制器或衰减造成的真实电平变化,让结果看起来比实际更好。只有为了试听响度匹配时,才另外生成一份试听副本。
| 指标 | 主要回答的问题 | 典型风险 |
|---|---|---|
| Peak | 是否削顶、是否还有余量 | 峰值安全不代表整体响度合适 |
| RMS | 整体能量是否变化 | 不能单独代表主观响度 |
| SNR | 目标信号相对噪声是否改善 | 必须有可信的干净参考 |
| 频谱 | 哪些频段被增强、衰减或产生伪影 | 只看总能量会漏掉窄带问题 |
| 延迟 | 实时交互是否变慢 | 平均值会掩盖抖动和长尾 |
| CPU | 算法是否有实时余量 | 接近 100% 时容易出现爆音 |
用脚本计算电平、SNR 与频谱差异
下面的脚本读取三份单声道 16-bit PCM WAV:clean.wav 是干净参考,before.wav 是处理前信号,after.wav 是处理后信号。它会检查采样率和长度,随后输出 Peak、RMS、SNR,以及相对干净参考的平均频谱误差。
import sys
import wave
import numpy as np

EPS = 1e-12

def read_mono_pcm16(path: str):
    with wave.open(path, "rb") as wf:
        if wf.getnchannels() != 1 or wf.getsampwidth() != 2:
            raise ValueError(f"{path} 必须是单声道 16-bit PCM WAV")
        fs = wf.getframerate()
        frames = wf.readframes(wf.getnframes())
    # 将 PCM16 统一缩放到 [-1, 1),后续 dBFS 才有一致参考。
    x = np.frombuffer(frames, dtype="<i2").astype(np.float64) / 32768.0
    return fs, x

def dbfs_peak(x: np.ndarray) -> float:
    return 20.0 * np.log10(np.max(np.abs(x)) + EPS)

def dbfs_rms(x: np.ndarray) -> float:
    return 20.0 * np.log10(np.sqrt(np.mean(x * x)) + EPS)

def snr_db(clean: np.ndarray, test: np.ndarray) -> float:
    # SNR 的误差项要求 clean 与 test 已经时间对齐且增益基准一致。
    noise = test - clean
    return 10.0 * np.log10((np.sum(clean * clean) + EPS) / (np.sum(noise * noise) + EPS))

def spectral_mae_db(clean: np.ndarray, test: np.ndarray) -> float:
    # Hann 窗减少有限长度截断带来的频谱泄漏。
    window = np.hanning(len(clean))
    ref = np.abs(np.fft.rfft(clean * window))
    cur = np.abs(np.fft.rfft(test * window))
    ref_db = 20.0 * np.log10(ref + EPS)
    cur_db = 20.0 * np.log10(cur + EPS)
    return float(np.mean(np.abs(cur_db - ref_db)))

def main():
    if len(sys.argv) != 4:
        raise SystemExit("用法: python evaluate_audio.py clean.wav before.wav after.wav")

    fs0, clean = read_mono_pcm16(sys.argv[1])
    fs1, before = read_mono_pcm16(sys.argv[2])
    fs2, after = read_mono_pcm16(sys.argv[3])

    if not (fs0 == fs1 == fs2):
        raise ValueError("三份 WAV 的采样率必须一致")

    # 只比较三份素材共同存在的区间,避免长度差异污染结果。
    n = min(len(clean), len(before), len(after))
    clean, before, after = clean[:n], before[:n], after[:n]

    print(f"sample_rate={fs0} Hz, samples={n}")
    for name, x in (("before", before), ("after", after)):
        print(
            f"{name}: peak={dbfs_peak(x):.2f} dBFS, "
            f"rms={dbfs_rms(x):.2f} dBFS, "
            f"snr={snr_db(clean, x):.2f} dB, "
            f"spectral_mae={spectral_mae_db(clean, x):.2f} dB"
        )

if __name__ == "__main__":
    main()
运行命令:
python evaluate_audio.py clean.wav before.wav after.wav预期输出格式如下,具体数值取决于测试素材:
sample_rate=<SAMPLE_RATE> Hz, samples=<SAMPLES>
before: peak=<DBFS> dBFS, rms=<DBFS> dBFS, snr=<DB> dB, spectral_mae=<DB> dB
after: peak=<DBFS> dBFS, rms=<DBFS> dBFS, snr=<DB> dB, spectral_mae=<DB> dB
判断时不要只追求“所有数字都变大”。例如降噪后 SNR 应上升,但 RMS 可能略降;限制器工作后 Peak 应更安全,但频谱高频端如果出现明显抬升,反而可能意味着失真增加。
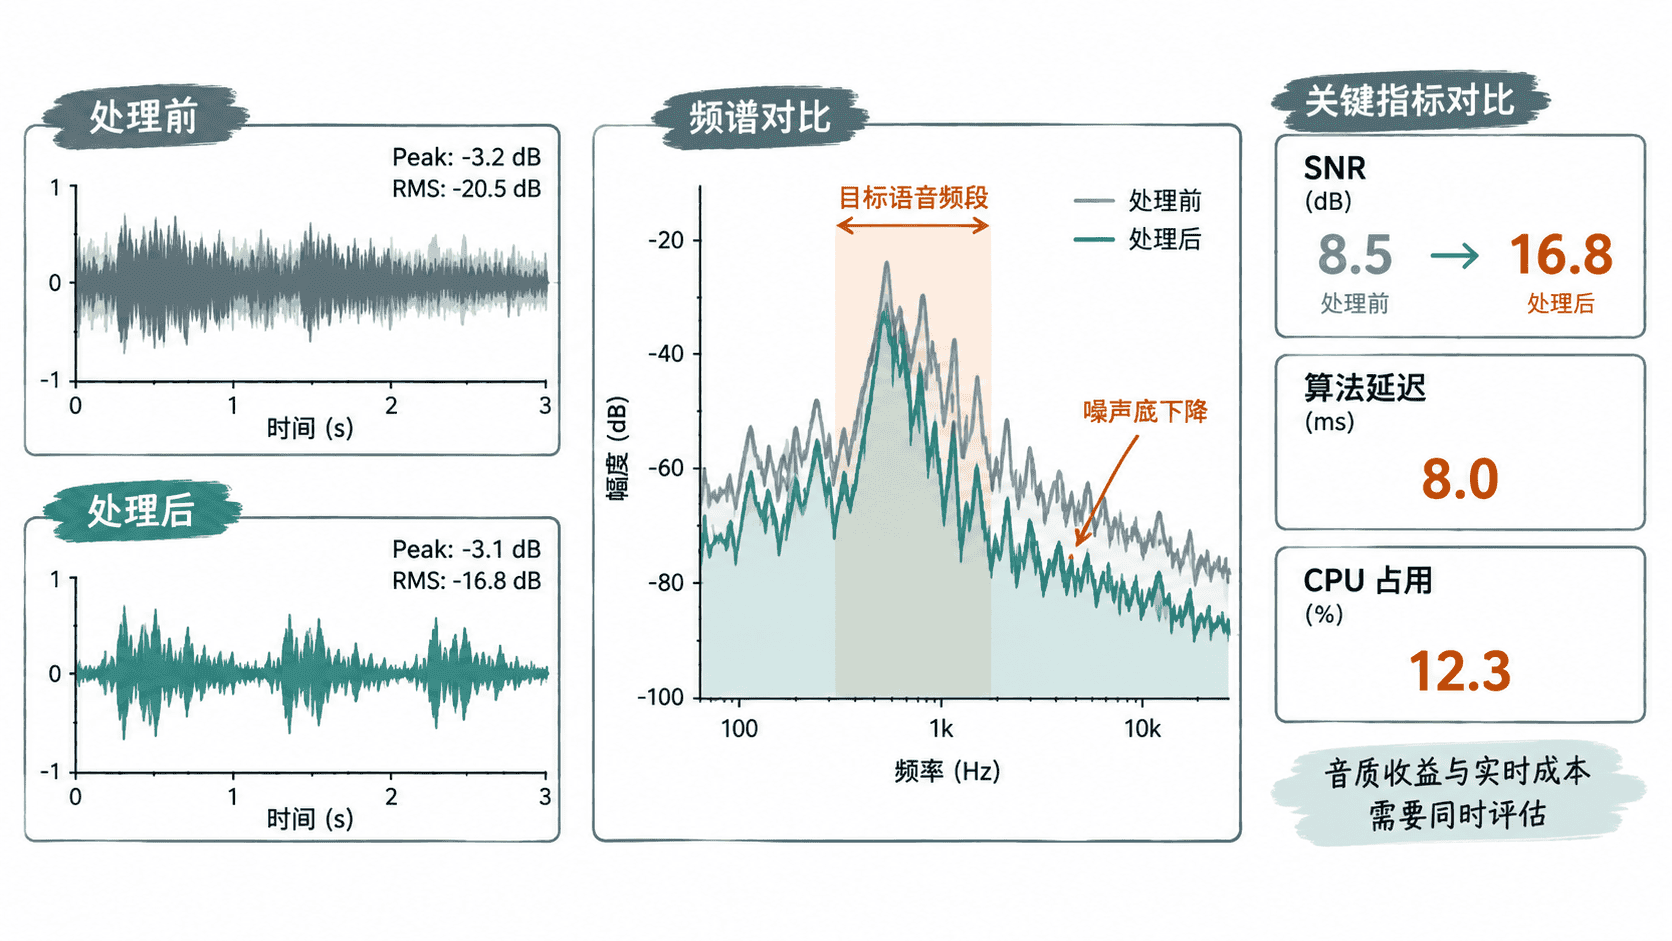
延迟和 CPU 要在真实实时链路里测
离线 WAV 只能回答“音频变成什么样”,不能回答“实时跑不跑得住”。实时处理中应记录每个音频块的处理耗时 ,并与该块代表的音频时长 比较:
若 10 ms 的音频块平均处理 4 ms,实时负载约为 40%。但工程上还应看 P95 或 P99,而不是只看平均值;偶发超过块时长就可能造成 underrun、爆音或数据丢失。
端到端延迟还包含设备缓冲、采集、算法 look-ahead、线程调度和播放缓冲。测量时应记录输入事件到对应输出事件的时间差,并至少保存平均值和 P95。只报告“算法函数执行了 2 ms”不能代表用户真正感受到的延迟。
用一张验收表做结论
一组指标的价值在于能回答“收益是否大于代价”。实际项目可先给目标设阈值,再跑固定素材回归,例如:SNR 至少提升 3 dB、Peak 不高于 -1 dBFS、目标频段没有新增明显伪峰、P95 端到端延迟低于产品预算、P95 CPU 负载保留足够余量。
如果 SNR 提高但频谱出现明显音乐噪声,或者降噪效果很好却让 P95 CPU 长期接近实时上限,都不能直接判定为“算法变好”。最终验收应同时保留原始素材、处理后素材、指标结果和参数版本,这样下一次改算法时才能做真正可重复的 A/B 回归。