
音频开发 / 系统课时
完成实时语音增强处理器
完成实时语音增强处理器
这一节把高通、降噪、VAD、AGC、限制器和可选回声抵消串成一条可运行的实时链路,并把参数、录音与性能数据一起保存。最终得到的不只是“能出声”的 Demo,而是一套可以重复验收和回归的处理器。
学习目标
- 能按正确顺序组织实时语音增强链路,并理解每个模块的职责边界。
- 能把处理器接到实时音频设备,暴露关键参数并记录性能数据。
- 能保存固定测试素材、处理结果和配置,为后续回归提供可重复基线。
先固定实时链路和职责
推荐的最小顺序是:可选 AEC → 高通 → 降噪 → VAD → AGC → 限制器。AEC 必须尽量靠前,因为它需要在后续增益处理之前看到较原始的麦克风信号和播放参考;AGC 放在降噪之后,可以避免把噪声先放大;限制器放在最后负责兜底削峰。
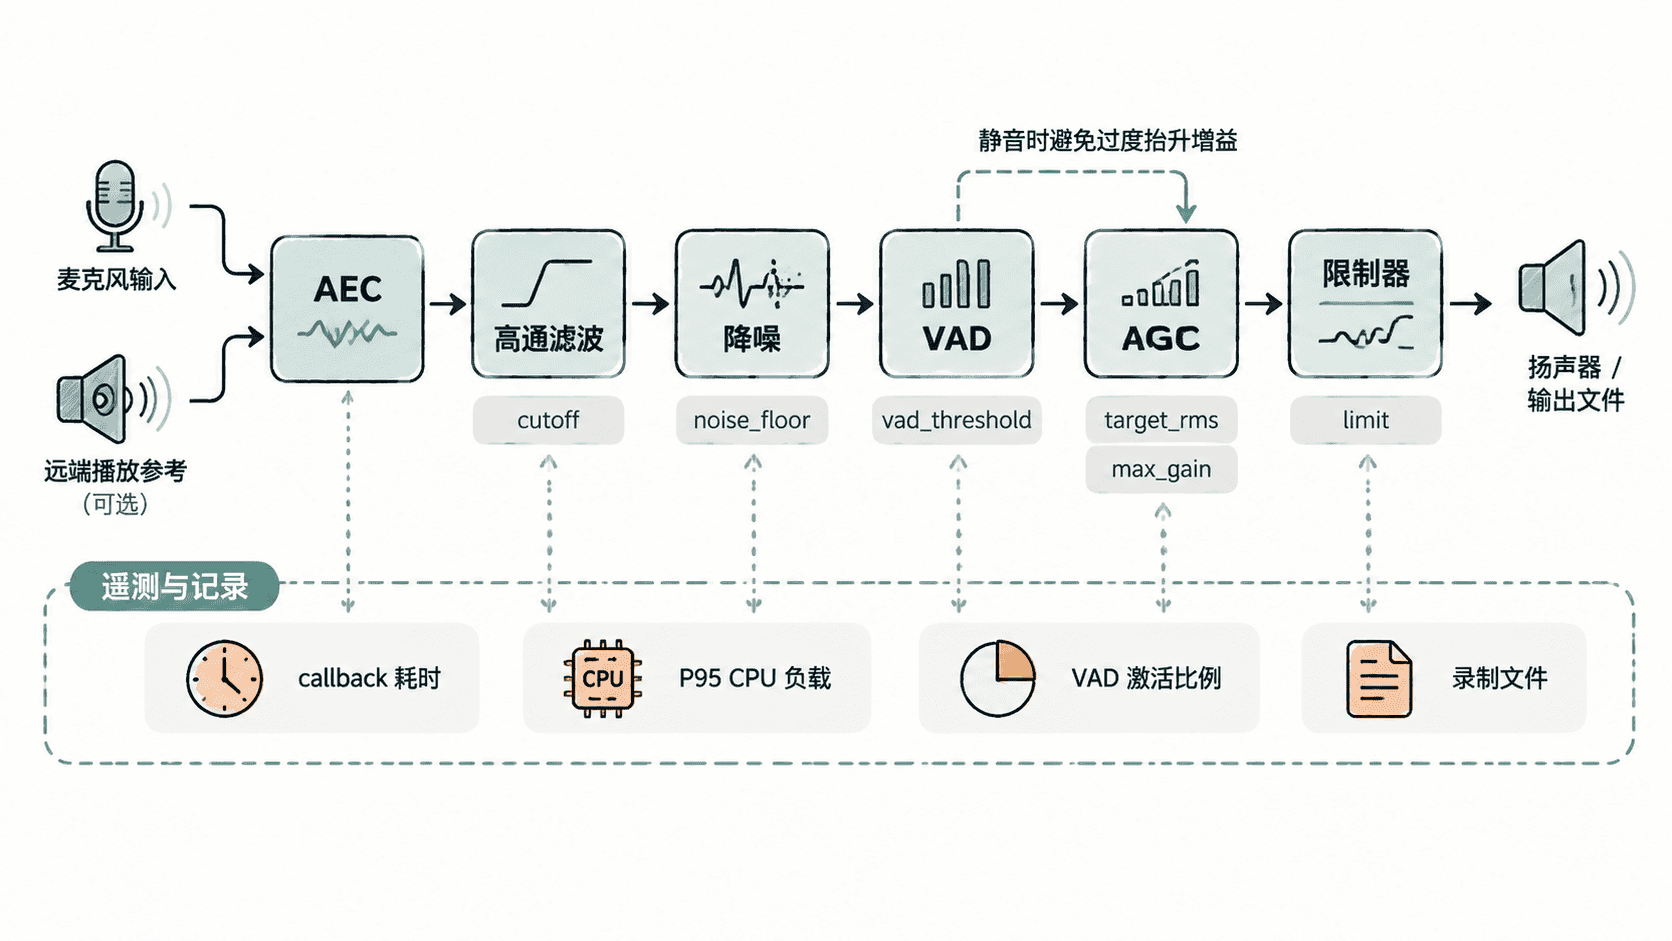
其中“降噪”本节采用轻量级自适应噪声门,适合讲清实时工程骨架;如果项目需要更高质量的频谱降噪或神经网络降噪,可以替换该模块,但不要改变实时回调的无阻塞约束。AEC 示例使用教学级 NLMS,自带播放参考通道时才能启用;没有参考信号时不要假装开启 AEC。
安装依赖并确认设备
示例使用 Python、NumPy、SoundDevice 和 SoundFile。先安装依赖:
python -m pip install numpy sounddevice soundfile预期结果:
Successfully installed <PACKAGE_VERSIONS>随后可用下面的命令查看设备编号:
python -c "import sounddevice as sd; print(sd.query_devices())"预期输出会列出当前系统可用的输入、输出设备,设备名称和编号因机器而异:
<DEVICE_LIST>实时运行前应确认输入设备支持目标采样率。默认示例使用 16 kHz、10 ms block;如果声卡只支持 48 kHz,应先在设备层固定 48 kHz,再在独立模块中重采样,不要让回调期间频繁改变采样率。
实现可运行的处理器
下面的脚本同时支持实时采集和离线回放。实时模式会保存 acceptance-input.wav、acceptance-output.wav 和 acceptance-metrics.json;离线模式可以重新读取固定输入,复用同一处理链生成新输出,从而形成可重复回归。
import argparse
import json
import time
from pathlib import Path

import numpy as np
import sounddevice as sd
import soundfile as sf

class NLMSAEC:
    def __init__(self, taps=128, mu=0.2, eps=1e-8):
        # w 保存自适应回声路径估计,xbuf 保存最近的播放参考样本。
        self.w = np.zeros(taps, dtype=np.float32)
        self.xbuf = np.zeros(taps, dtype=np.float32)
        self.mu = mu
        self.eps = eps

    def process(self, mic, ref):
        out = np.empty_like(mic)
        for i in range(len(mic)):
            self.xbuf[1:] = self.xbuf[:-1]
            self.xbuf[0] = ref[i]
            # NLMS 用参考信号估计回声,再用误差更新滤波器系数。
            echo = float(np.dot(self.w, self.xbuf))
            err = mic[i] - echo
            norm = float(np.dot(self.xbuf, self.xbuf)) + self.eps
            self.w += (self.mu * err / norm) * self.xbuf
            out[i] = err
        return out

class SpeechEnhancer:
    def __init__(self, fs, block, cutoff=80.0, vad_threshold=0.012,
                 target_rms=0.08, max_gain=6.0, limit=0.95, use_aec=False):
        self.fs = fs
        self.block = block
        # 一阶 DC-blocker 形式的高通,状态必须跨 block 保留。
        self.alpha = float(np.exp(-2.0 * np.pi * cutoff / fs))
        self.vad_threshold = vad_threshold
        self.target_rms = target_rms
        self.max_gain = max_gain
        self.limit = limit
        self.hp_x1 = 0.0
        self.hp_y1 = 0.0
        self.noise_floor = 0.005
        self.gain = 1.0
        self.aec = NLMSAEC() if use_aec else None

    def highpass(self, x):
        y = np.empty_like(x)
        x1, y1 = self.hp_x1, self.hp_y1
        for i, sample in enumerate(x):
            cur = self.alpha * (y1 + sample - x1)
            y[i] = cur
            x1, y1 = sample, cur
        self.hp_x1, self.hp_y1 = x1, y1
        return y

    def process(self, mic, ref=None):
        x = mic.astype(np.float32, copy=False)
        if self.aec is not None:
            if ref is None:
                raise ValueError("启用 AEC 时必须提供播放参考通道")
            x = self.aec.process(x, ref.astype(np.float32, copy=False))

        x = self.highpass(x)
        rms = float(np.sqrt(np.mean(x * x) + 1e-12))
        speech = rms >= self.vad_threshold

        # 只在非语音块更新噪声底,避免把人声本身学成噪声。
        if not speech:
            self.noise_floor = 0.98 * self.noise_floor + 0.02 * rms
        gate = 1.0 if speech else max(0.15, rms / (self.noise_floor * 2.0 + 1e-6))
        x = x * gate

        post_rms = float(np.sqrt(np.mean(x * x) + 1e-12))
        # AGC 采用平滑增益,限制单个 block 的突变和最大放大量。
        desired = min(self.max_gain, self.target_rms / max(post_rms, 1e-6))
        if not speech:
            desired = min(desired, 1.0)
        self.gain = 0.9 * self.gain + 0.1 * desired
        x = x * self.gain

        x = np.clip(x, -self.limit, self.limit)
        return x, speech

def run_offline(args):
    data, fs = sf.read(args.input, dtype="float32", always_2d=True)
    if fs != args.fs:
        raise ValueError(f"输入采样率为 {fs} Hz,期望 {args.fs} Hz")

    use_aec = args.aec
    need_channels = 2 if use_aec else 1
    if data.shape[1] < need_channels:
        raise ValueError("启用 AEC 的离线素材至少需要 mic + reference 两个通道")

    processor = SpeechEnhancer(args.fs, args.block, use_aec=use_aec)
    output = []
    active = 0
    loads = []

    # 离线模式复用与实时模式完全相同的 process(),用于稳定回归。
    for start in range(0, len(data), args.block):
        frame = data[start:start + args.block]
        mic = frame[:, 0]
        ref = frame[:, 1] if use_aec else None
        t0 = time.perf_counter()
        y, speech = processor.process(mic, ref)
        elapsed = time.perf_counter() - t0
        block_time = max(len(mic) / args.fs, 1e-9)
        loads.append(100.0 * elapsed / block_time)
        active += int(speech)
        output.append(y)

    out = np.concatenate(output)
    sf.write("acceptance-output.wav", out, args.fs)
    metrics = {
        "mode": "offline",
        "p95_callback_load_percent": float(np.percentile(loads, 95)),
        "vad_active_ratio": active / max(len(loads), 1),
        "config": vars(args),
    }
    Path("acceptance-metrics.json").write_text(
        json.dumps(metrics, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    print("saved: acceptance-output.wav")
    print("saved: acceptance-metrics.json")
    print(f"p95_callback_load={metrics['p95_callback_load_percent']:.2f}%")
    print(f"vad_active_ratio={metrics['vad_active_ratio']:.3f}")

def run_live(args):
    processor = SpeechEnhancer(args.fs, args.block, use_aec=args.aec)
    raw_blocks, out_blocks, loads = [], [], []
    active = 0
    total = 0
    xruns = 0
    input_channels = 2 if args.aec else 1

    def callback(indata, outdata, frames, time_info, status):
        nonlocal active, total, xruns
        # 回调内只累计状态,不执行日志格式化或磁盘 I/O。
        if status:
            xruns += 1

        # AEC 开启时约定输入 0 为麦克风、输入 1 为时间对齐的播放参考。
        mic = indata[:, 0].copy()
        ref = indata[:, 1].copy() if args.aec else None
        t0 = time.perf_counter()
        y, speech = processor.process(mic, ref)
        elapsed = time.perf_counter() - t0

        # 输出先写入声卡缓冲;验收录音仅短时保存在内存,结束后统一落盘。
        outdata[:, 0] = y
        raw_blocks.append(mic)
        out_blocks.append(y.copy())
        loads.append(100.0 * elapsed / (frames / args.fs))
        active += int(speech)
        total += 1

    with sd.Stream(
        samplerate=args.fs,
        blocksize=args.block,
        dtype="float32",
        channels=(input_channels, 1),
        callback=callback,
    ):
        time.sleep(args.seconds)

    raw = np.concatenate(raw_blocks)
    out = np.concatenate(out_blocks)
    sf.write("acceptance-input.wav", raw, args.fs)
    sf.write("acceptance-output.wav", out, args.fs)

    metrics = {
        "mode": "live",
        "p95_callback_load_percent": float(np.percentile(loads, 95)),
        "vad_active_ratio": active / max(total, 1),
        "callback_status_count": xruns,
        "config": vars(args),
    }
    Path("acceptance-metrics.json").write_text(
        json.dumps(metrics, ensure_ascii=False, indent=2), encoding="utf-8"
    )

    print("saved: acceptance-input.wav")
    print("saved: acceptance-output.wav")
    print("saved: acceptance-metrics.json")
    print(f"p95_callback_load={metrics['p95_callback_load_percent']:.2f}%")
    print(f"vad_active_ratio={metrics['vad_active_ratio']:.3f}")

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--mode", choices=("live", "offline"), default="live")
    parser.add_argument("--input")
    parser.add_argument("--fs", type=int, default=16000)
    parser.add_argument("--block", type=int, default=160)
    parser.add_argument("--seconds", type=float, default=10.0)
    parser.add_argument("--aec", action="store_true")
    args = parser.parse_args()

    if args.mode == "offline":
        if not args.input:
            raise SystemExit("--mode offline 时必须提供 --input")
        run_offline(args)
    else:
        run_live(args)

if __name__ == "__main__":
    main()
实时采集 10 秒:
python realtime_enhancer.py --mode live --seconds 10预期输出格式如下,性能数值会随设备和现场声音变化:
saved: acceptance-input.wav
saved: acceptance-output.wav
saved: acceptance-metrics.json
p95_callback_load=<CPU_PERCENT>%
vad_active_ratio=<RATIO>
如果要验证参数修改是否退化,不需要重新说一遍同样的话,直接复用固定素材:
python realtime_enhancer.py --mode offline --input acceptance-input.wav预期结果:
saved: acceptance-output.wav
saved: acceptance-metrics.json
p95_callback_load=<CPU_PERCENT>%
vad_active_ratio=<RATIO>
调参时先保证稳定,再追求“更干净”
高通截止频率过高会削弱低沉人声;VAD 阈值过高会吞掉轻声和尾音;AGC 的 max_gain 太大则会在静音期把底噪抬起。建议一次只改一组参数,并让固定输入文件跑完整回归,避免多个模块同时变化后无法定位问题。
AEC 更需要单独验收。启用 --aec 时,输入设备必须同时提供麦克风通道和与扬声器播放时间对齐的参考通道。本示例 NLMS 主要用于理解和原型验证;真实产品通常需要处理双讲、非线性扬声器失真、时钟漂移和更长回声路径,应替换为成熟 AEC 实现。
保存一组可重复的验收资产
至少保留四样东西:固定输入 WAV、处理后 WAV、参数配置、性能指标。还应另外准备安静环境、稳定风扇噪声、近讲语音、远讲语音和回声场景几组素材,并给每组设通过条件。
一次改动只有在“音频指标改善、P95 实时负载有余量、无持续削顶、无明显吞字或泵音、固定素材可重复通过”时才算完成。这样后续无论替换降噪算法、调整 VAD,还是接入真正的 AEC,都能用同一套素材和指标判断是否发生回归。