
音频开发 / 系统课时
读懂采样率位深与声道布局
读懂采样率位深与声道布局
音频接口里最容易混淆的不是参数本身,而是“一个 sample、一个 frame、一个 buffer 到底包含多少数据”。这一节用 48 kHz、16 位、双声道 PCM 把采样率、位深、样本格式和声道布局串起来,并用字节数验证缓冲区大小。
学习目标
- 区分采样率、位深、整数/浮点样本格式各自影响的维度。
- 分清 sample、frame 与 channel,读懂交错和非交错多声道布局。
- 根据采样率、声道数和样本宽度核对帧大小、数据率与缓冲区字节数。
参数分别控制什么
采样率描述每个声道每秒取得多少个时间点。48 kHz 表示每个声道每秒 48000 个样本,理想可表示频带受奈奎斯特频率约 24 kHz 限制。
位深主要描述整型 PCM 的量化精度和存储宽度。16 位有符号 PCM 每个样本通常占 2 字节;24 位 PCM 常占 3 字节,但部分 API 会为了对齐装进 4 字节容器,所以不能只看“24-bit”就推断内存布局。
浮点音频常用 float32,每个样本占 4 字节,DSP 中通常把满幅约定在 -1.0 到 1.0。它的优势主要是中间运算头间和数值处理方便,不应把“32 位浮点”简单理解成“等价于 32 位整数 PCM 的动态范围”。
sample、frame 和声道不要混用
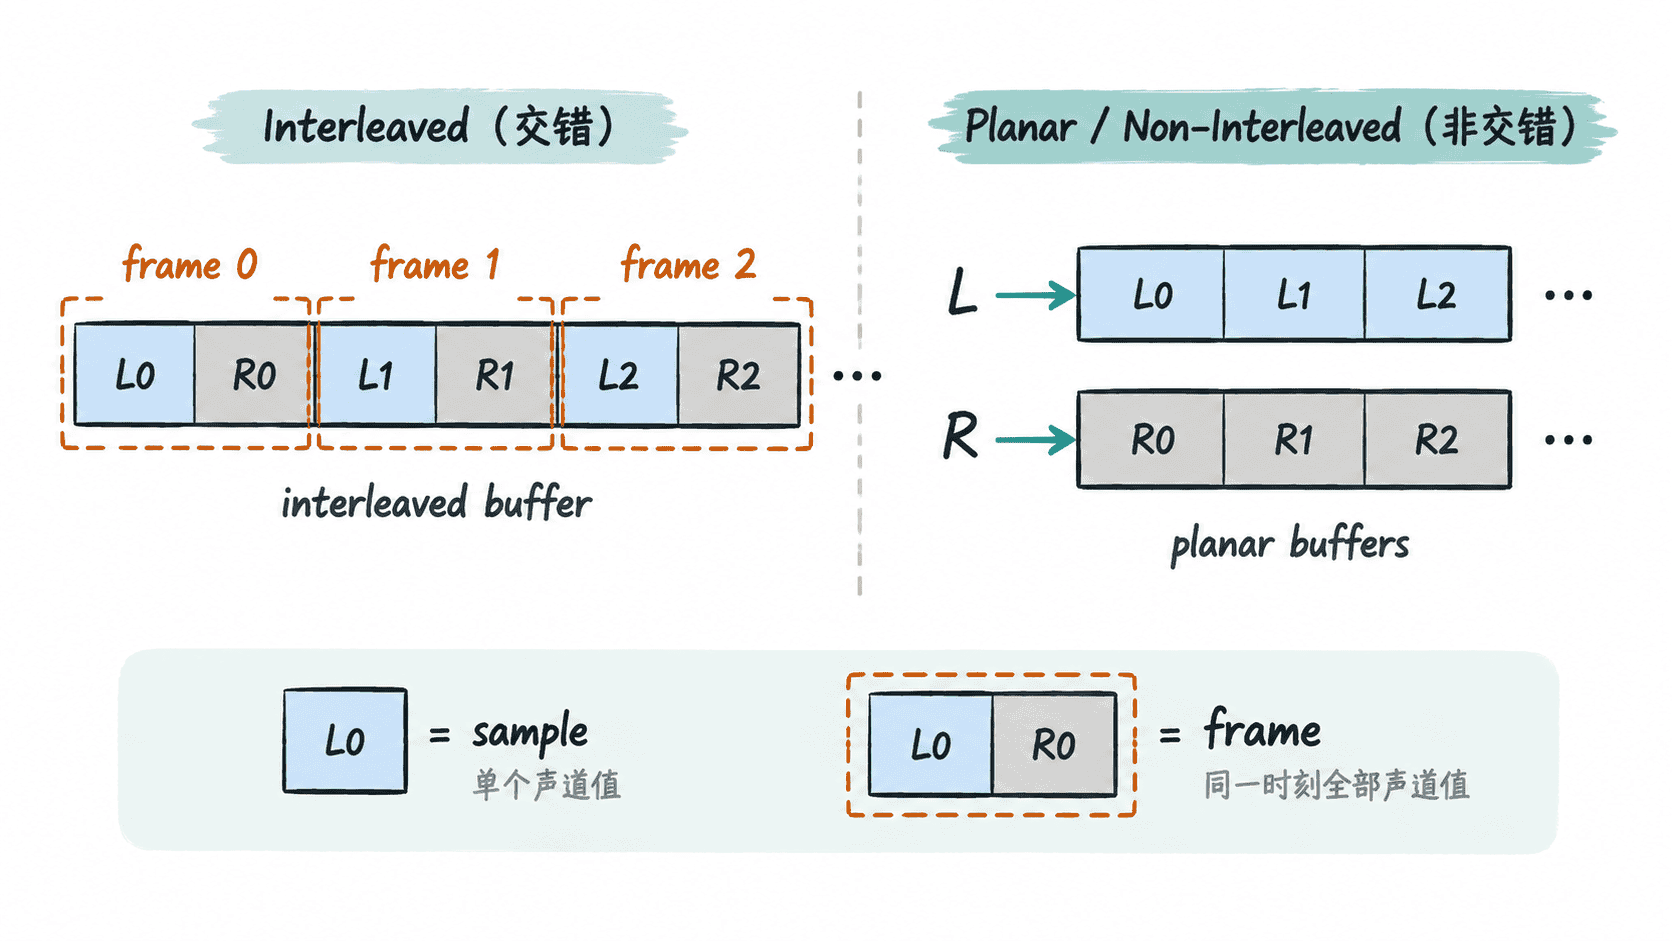
单个 sample 是某一个声道在某一个时刻的幅值。一个 frame 则包含同一时刻的全部声道样本。双声道音频中,一个 frame 同时包含左声道和右声道各一个 sample。
交错布局按时间顺序把各声道样本放在同一数组里:L0, R0, L1, R1, ...。非交错布局则把每个声道放到独立缓冲区,例如左声道数组保存 L0, L1, ...,右声道数组保存 R0, R1, ...。
用字节数核对缓冲区
以 48 kHz、16 位、双声道、10 ms 音频为例:每声道有 480 个样本,也就是 480 个 frame;双声道一共包含 960 个标量 sample。每个 sample 占 2 字节,所以每个 frame 占 4 字节,整个缓冲区占 1920 字节。
sample_rate = 48_000
bit_depth = 16
channels = 2
duration_seconds = 0.010

bytes_per_sample = bit_depth // 8
frames = int(sample_rate * duration_seconds)
scalar_samples = frames * channels
bytes_per_frame = bytes_per_sample * channels
buffer_bytes = frames * bytes_per_frame
bytes_per_second = sample_rate * bytes_per_frame

print(f"frames={frames}")
print(f"scalar_samples={scalar_samples}")
print(f"bytes_per_frame={bytes_per_frame}")
print(f"buffer_bytes={buffer_bytes}")
print(f"bytes_per_second={bytes_per_second}")
预期输出:
frames=480
scalar_samples=960
bytes_per_frame=4
buffer_bytes=1920
bytes_per_second=192000
如果接口要求 10 ms 一包,而你实际提交的双声道 16 位 PCM 长度不是 1920 字节,就应检查是否把“每声道样本数”误当成“全部样本数”,或者是否忽略了声道数与容器宽度。
接口兼容时先核对四件事
真正接入播放器、声卡或编解码器时,不要只比较采样率。还要同时确认样本格式、声道数和布局。例如同样是 48 kHz 双声道,int16 交错 PCM 与 float32 非交错缓冲区在每帧字节数、内存组织和 API 参数上都完全不同。
计算原始 PCM 数据率时可以直接使用:
这个公式只适用于未压缩 PCM 的有效载荷,不包含 WAV 文件头、网络封包或编解码器码率。只要先把 sample、frame、channel 和实际容器字节数分清,绝大多数“音频长度不对、左右声道错位、播放速度异常”的接口问题都能在进入 DSP 之前被发现。