
音频开发 / 系统课时
用 NLMS 跟踪并抵消声学回声
用 NLMS 跟踪并抵消声学回声
免提通话中,扬声器播放的远端声音会经过房间和设备结构重新进入麦克风。NLMS 用远端播放信号作为参考,在线估计这条未知回声路径,再从麦克风信号中减去预测回声;真正难点在于收敛速度、滤波器长度和双讲期间的稳定性。
学习目标
- 能说明远端参考、麦克风信号、预测回声和残差信号之间的关系。
- 能实现一个最小 NLMS 自适应滤波器并观察系数收敛。
- 能判断步长、滤波器长度与双讲对实际 AEC 效果的影响。
先建立远端参考与回声路径
设远端播放参考为 ,真实声学回声路径为未知 FIR 系统。麦克风接收到的 通常同时包含回声、近端说话声和噪声。自适应滤波器维护系数向量 ,根据最近一段远端样本预测回声:
再计算残差:
当当前阶段只有远端在说话时, 越小通常意味着估计的回声路径越接近真实路径。
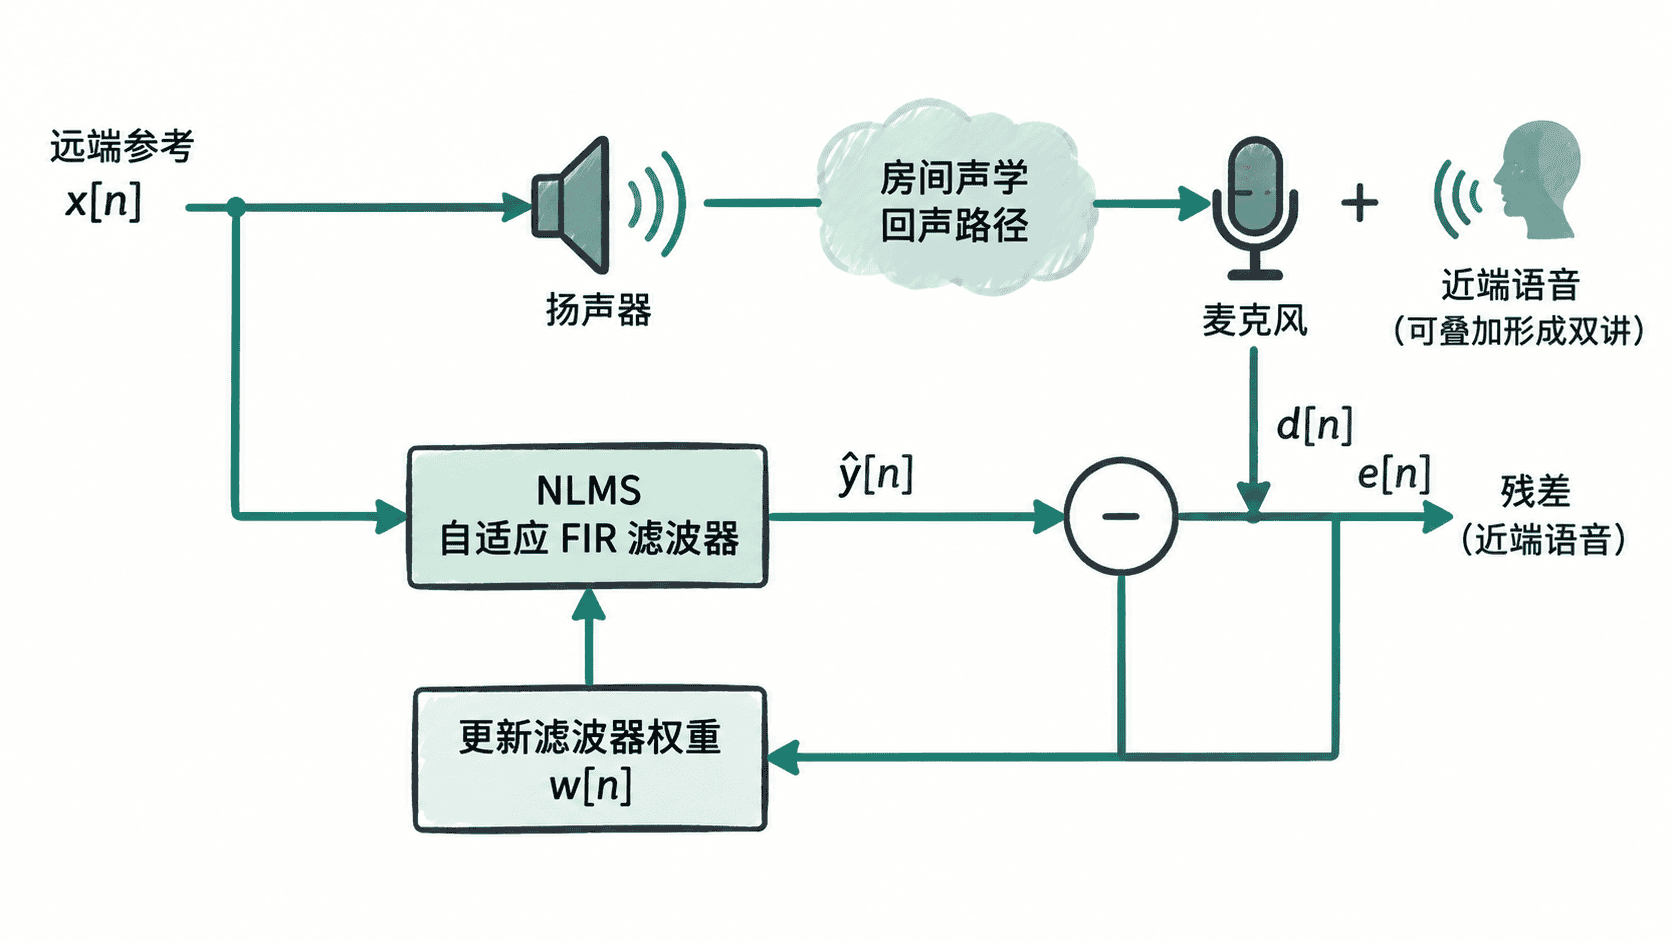
普通 LMS 的更新量会直接受参考信号幅度影响。NLMS 用当前参考向量的能量做归一化,使同一个步长参数在远端音量变化时更稳定:
其中 mu 控制跟踪速度与稳定性的折中,epsilon 防止参考能量接近零时分母过小。
实现一个最小 NLMS
下面用一个二抽头未知回声路径 [0.7, 0.3] 生成麦克风中的纯回声,再让 NLMS 从全零系数开始在线估计。这个实验故意不加入近端语音,目的是先确认最基本的收敛机制正确。
far = [1.0, 0.5, -0.5, -1.0, 0.2, 0.8, -0.3, 0.4, 0.9, -0.7] * 20
true_h = [0.7, 0.3]

mic = []
for n, x in enumerate(far):
    prev = far[n - 1] if n > 0 else 0.0
    mic.append(true_h[0] * x + true_h[1] * prev)

w = [0.0, 0.0]
mu = 0.8
eps = 1e-6
errors = []

for n, d in enumerate(mic):
    x_vec = [far[n], far[n - 1] if n > 0 else 0.0]
    echo_hat = sum(a * b for a, b in zip(w, x_vec))
    e = d - echo_hat
    power = eps + sum(v * v for v in x_vec)

    # 归一化后更新每个抽头,避免远端幅度直接决定更新尺度。
    for i in range(len(w)):
        w[i] += mu * e * x_vec[i] / power
    errors.append(e)

first_mse = sum(e * e for e in errors[:10]) / 10
last_mse = sum(e * e for e in errors[-10:]) / 10
print("estimated_h =", [round(v, 4) for v in w])
print(f"first_10_mse = {first_mse:.6f}")
print(f"last_10_mse  = {last_mse:.6f}")
预期输出
estimated_h = [0.7, 0.3]
first_10_mse = 0.063189
last_10_mse  = 0.000000
最后估计系数回到 [0.7, 0.3],尾部均方误差降为接近零,说明在“只有远端、路径不变、模型长度足够”的理想条件下,NLMS 能逐步学到真实回声路径。
步长和滤波器长度决定跟踪能力
mu 太小,系数更新慢,房间路径变化后要很久才能重新收敛;mu 太大,则可能在最优点附近持续抖动,严重时失稳。实际值还与信号统计特征、定点量化和是否存在额外保护逻辑有关,因此不能只凭一个离线样本确定。
滤波器长度必须覆盖主要回声路径。以 16 kHz 采样率为例,1600 个抽头大约覆盖 100 ms。长度不足时,后半段回声无法建模;长度过长则计算量、内存和收敛时间都会增加。工程上应结合脉冲响应或实测回声尾长选择,而不是机械追求更长。
双讲时不要继续盲目学习
双讲表示远端和近端同时说话。此时麦克风中的近端语音并不是由远端参考产生的,如果 NLMS 仍把全部残差都用于更新,就可能错误地把近端语音“学进”回声路径,造成系数漂移甚至发散。
常见做法是加入双讲检测:当残差中出现与远端参考不相干、且能量明显的近端成分时,暂停或显著降低自适应更新,只继续用当前滤波器做回声预测。参考信号接近静音时也应冻结更新,因为归一化虽然有 epsilon,但此时没有足够信息去辨识新的回声路径。
验收时先用“只有远端”的录音观察残差能量是否随时间下降,再改变扬声器与麦克风位置确认滤波器能重新收敛,最后加入双讲检查近端语音是否被误消除。只有这三步都通过,才说明 NLMS 不只是数学上收敛,而是具备进入实时通话链路的基础。