
音频开发 / 系统课时
统计端到端延迟与实时负载
统计端到端延迟与实时负载
实时音频链路是否安全,不能只看平均 CPU 占用。真正需要回答的是:声音从输入到输出总共延迟多久、每个回调是否能在帧期限前完成,以及偶发的最坏耗时会不会造成欠载。本节建立一套可重复的延迟与实时负载测量方法。
学习目标
- 拆分设备缓冲、DSP 处理和调度等待形成的端到端延迟
- 用平均值、P95、P99 和最坏耗时判断回调是否存在超时风险
- 根据帧期限计算实时负载与 CPU 余量,并建立可用于回归测试的指标
先确定实时链路的时间预算
设采样率为 ,每次音频回调处理 个采样,则一帧对应的时间期限为:
例如 48 kHz、每帧 480 个采样时,帧期限就是 10 ms。DSP 回调必须在下一帧到来之前处理完当前帧,否则缓冲区可能被耗尽,出现爆音、断续或 underrun。
端到端延迟则不只有算法耗时。实际链路通常同时包含输入设备缓冲、输入调度等待、DSP 块处理、输出排队和输出设备缓冲。
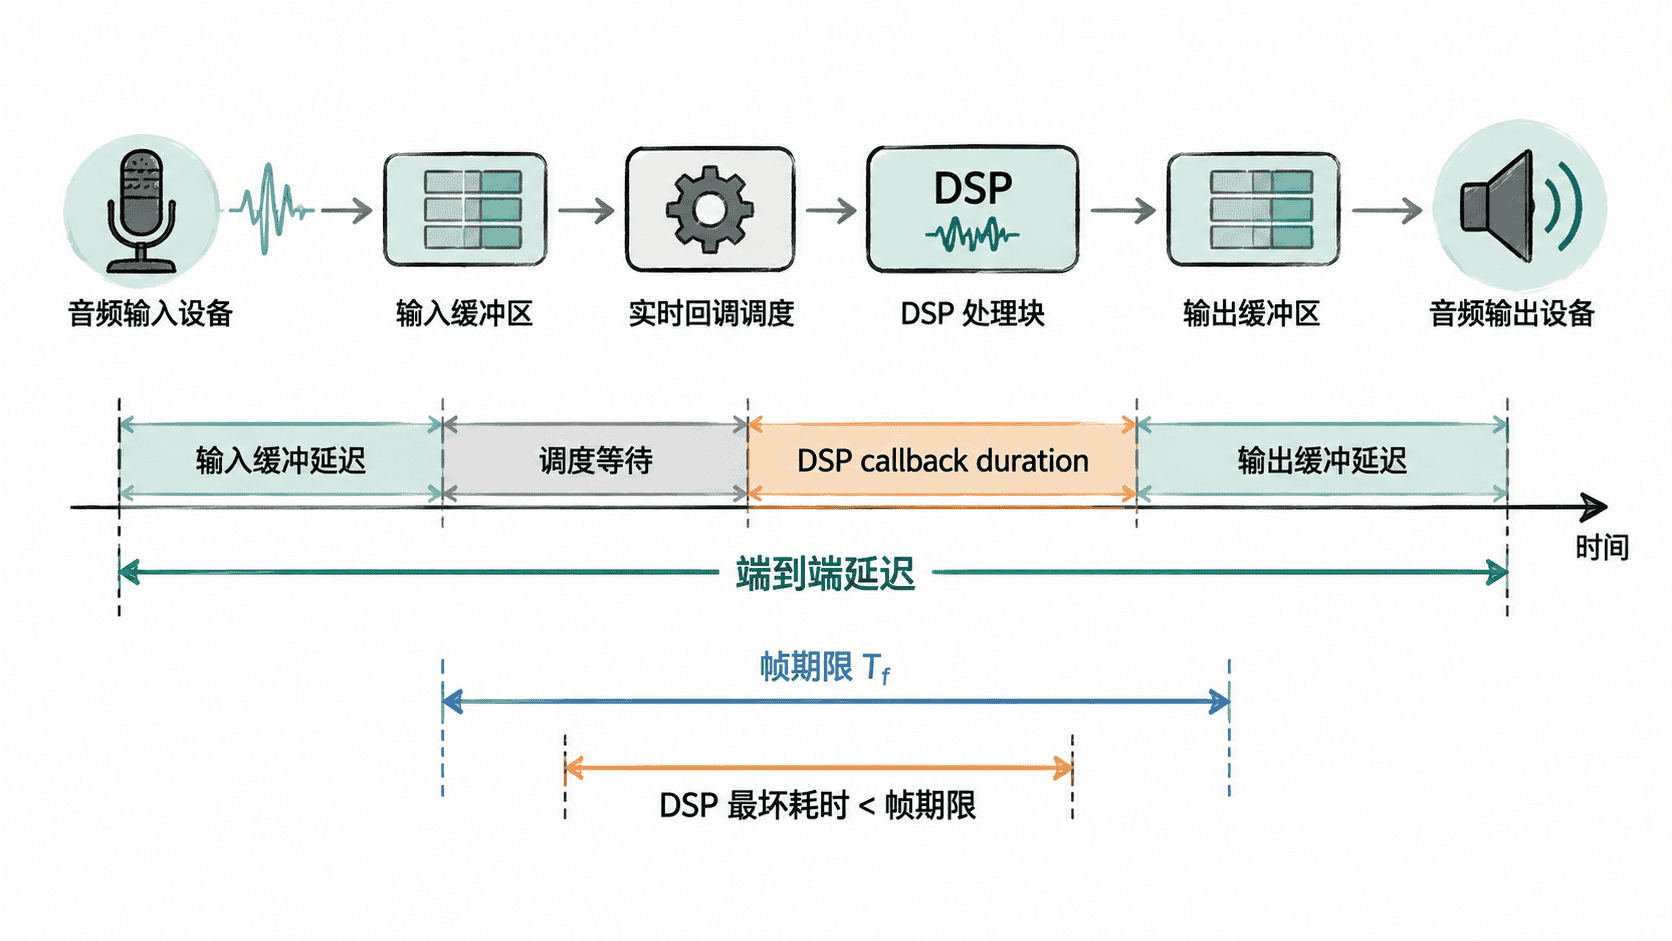
如果输入端有 2 帧缓冲、输出端有 2 帧缓冲,帧长又是 10 ms,那么仅设备缓冲就可能贡献约 40 ms。此时即使算法只运行 1 ms,也不能声称整条链路延迟只有 1 ms。
记录回调耗时分布
只记录一次回调耗时意义很小。实时风险通常来自偶发抖动,因此至少需要连续采集数千个回调样本,并统计平均值、P95、P99 和最大值。
实际工程中,可以在 DSP 回调入口和出口分别读取单调时钟,将耗时写入预分配的环形缓冲区,再由非实时线程汇总。不要在音频回调中打印日志、写文件或动态扩容容器,因为这些操作本身就会污染测量结果。
下面的完整 Python 示例演示如何对一组已经采集的回调耗时进行统计,并直接与帧期限比较。真实工程只需把 callback_ms 替换成实际测量结果。
from statistics import mean


def percentile(values: list[float], ratio: float) -> float:
    ordered = sorted(values)
    index = min(len(ordered) - 1, int((len(ordered) - 1) * ratio))
    return ordered[index]


def main() -> None:
    sample_rate = 48_000
    frames_per_buffer = 480
    callback_ms = [1.62, 1.71, 1.69, 1.84, 2.03, 1.77, 2.31, 1.73, 1.88, 2.56]

    # 一帧到达的间隔就是实时线程允许使用的理论上限。
    deadline_ms = frames_per_buffer / sample_rate * 1000
    avg_ms = mean(callback_ms)
    p95_ms = percentile(callback_ms, 0.95)
    p99_ms = percentile(callback_ms, 0.99)
    worst_ms = max(callback_ms)

    # 最坏耗时比平均耗时更适合判断实时安全余量。
    worst_load = worst_ms / deadline_ms
    headroom = 1.0 - worst_load

    print(f"frame deadline: {deadline_ms:.2f} ms")
    print(f"average:       {avg_ms:.2f} ms")
    print(f"p95:           {p95_ms:.2f} ms")
    print(f"p99:           {p99_ms:.2f} ms")
    print(f"worst:         {worst_ms:.2f} ms")
    print(f"worst load:    {worst_load:.1%}")
    print(f"headroom:      {headroom:.1%}")


if __name__ == "__main__":
    main()
预期输出:
frame deadline: 10.00 ms
average:       1.91 ms
p95:           2.31 ms
p99:           2.31 ms
worst:         2.56 ms
worst load:    25.6%
headroom:      74.4%
这里最重要的不是 1.91 ms 的平均值,而是 2.56 ms 的最坏耗时。它占用了 10 ms 帧期限的 25.6%,意味着在这批样本中仍有较大的时间余量。
把最坏耗时直接和帧期限比较
可以把每次回调的实时负载定义为:
当 时,该次处理在理论期限内完成;当 时,处理时间已经超过一帧的到达间隔,持续发生时极容易产生 underrun。
工程上不要把 当成安全状态。实时线程还会受到操作系统调度、缓存失效、中断、其他线程竞争和频率变化影响,因此应该保留明显余量。对于低延迟链路,可以先把最坏负载持续低于 60%~70% 作为工程观察线,再结合目标设备压测结果调整,而不是把 100% 当作正常工作点。
估算并验证端到端延迟
如果已知输入缓冲、输出缓冲以及算法引入的固定帧延迟,可以先做理论预算。例如 48 kHz、480 samples/frame,输入缓冲 2 帧、算法额外缓存 1 帧、输出缓冲 2 帧,则缓冲部分约为 50 ms。
但理论值不等于用户真正听到的延迟。设备驱动、系统 mixer、无线音频链路和隐含的内部缓冲都可能增加额外时间。因此面向产品验收时,应再做一次物理 loopback 测量:向输出端发送具有明显瞬态的测试脉冲,同时录制输入与输出,通过波形互相关或瞬态位置差计算真实往返延迟。
如果测得的物理延迟明显大于缓冲预算,应沿着设备缓冲、音频框架、DSP 内部缓存、重采样器和输出路径逐层核对,而不是优先优化已经只占几百微秒的算术运算。
建立可持续的实时验收指标
一次跑通并不能证明链路稳定。更有价值的做法是把统计数据纳入性能回归:在固定采样率、帧长和目标设备上连续运行足够长时间,记录 underrun 次数、P99、最大回调耗时和最坏实时负载。
验收时至少确认三件事:正常运行阶段没有 underrun;最坏回调耗时明显低于帧期限;修改 DSP 算法后,P99 和最大耗时没有异常跳升。如果平均耗时看起来正常而最大值持续逼近帧期限,就应该继续查锁竞争、内存分配、日志、调度抖动或偶发的大块计算。
最终判断实时链路是否安全,应依赖“端到端延迟 + 耗时分布 + 最坏帧负载”三组数据,而不是单独看平均 CPU。尤其在低延迟音频中,是否守住每一帧的期限,比平均跑得多快更重要。