
音频开发 / 系统课时
选择帧长平衡延迟与分辨率
选择帧长平衡延迟与分辨率
实时音频不能只追求“帧越小越好”。帧长同时决定块等待时间、FFT 频率分辨率、每秒调度次数和算法吞吐。本节用可计算指标筛选候选块大小,再用全双工回环实测往返延迟,避免只凭公式做决定。
学习目标
- 用帧长、采样率计算单帧时间、FFT 分辨率和调度频率
- 根据语音通话、音乐处理等场景选择合理块大小
- 通过回环脉冲测量真实端到端延迟并验证选择
先把四个指标算清楚
设采样率为 ,每帧包含 个采样点。单帧时长为 秒;若直接做 点 FFT,频率栅格间隔为 ;每秒需要处理约 个块。
以 48 kHz 为例,128、256、512、1024 点分别对应约 2.67、5.33、10.67、21.33 ms 的单帧时间。帧越小,等待下一块填满的时间越短,但回调触发更频繁;帧越大,FFT 分辨率更细,调度压力更低,却会增加块级延迟。
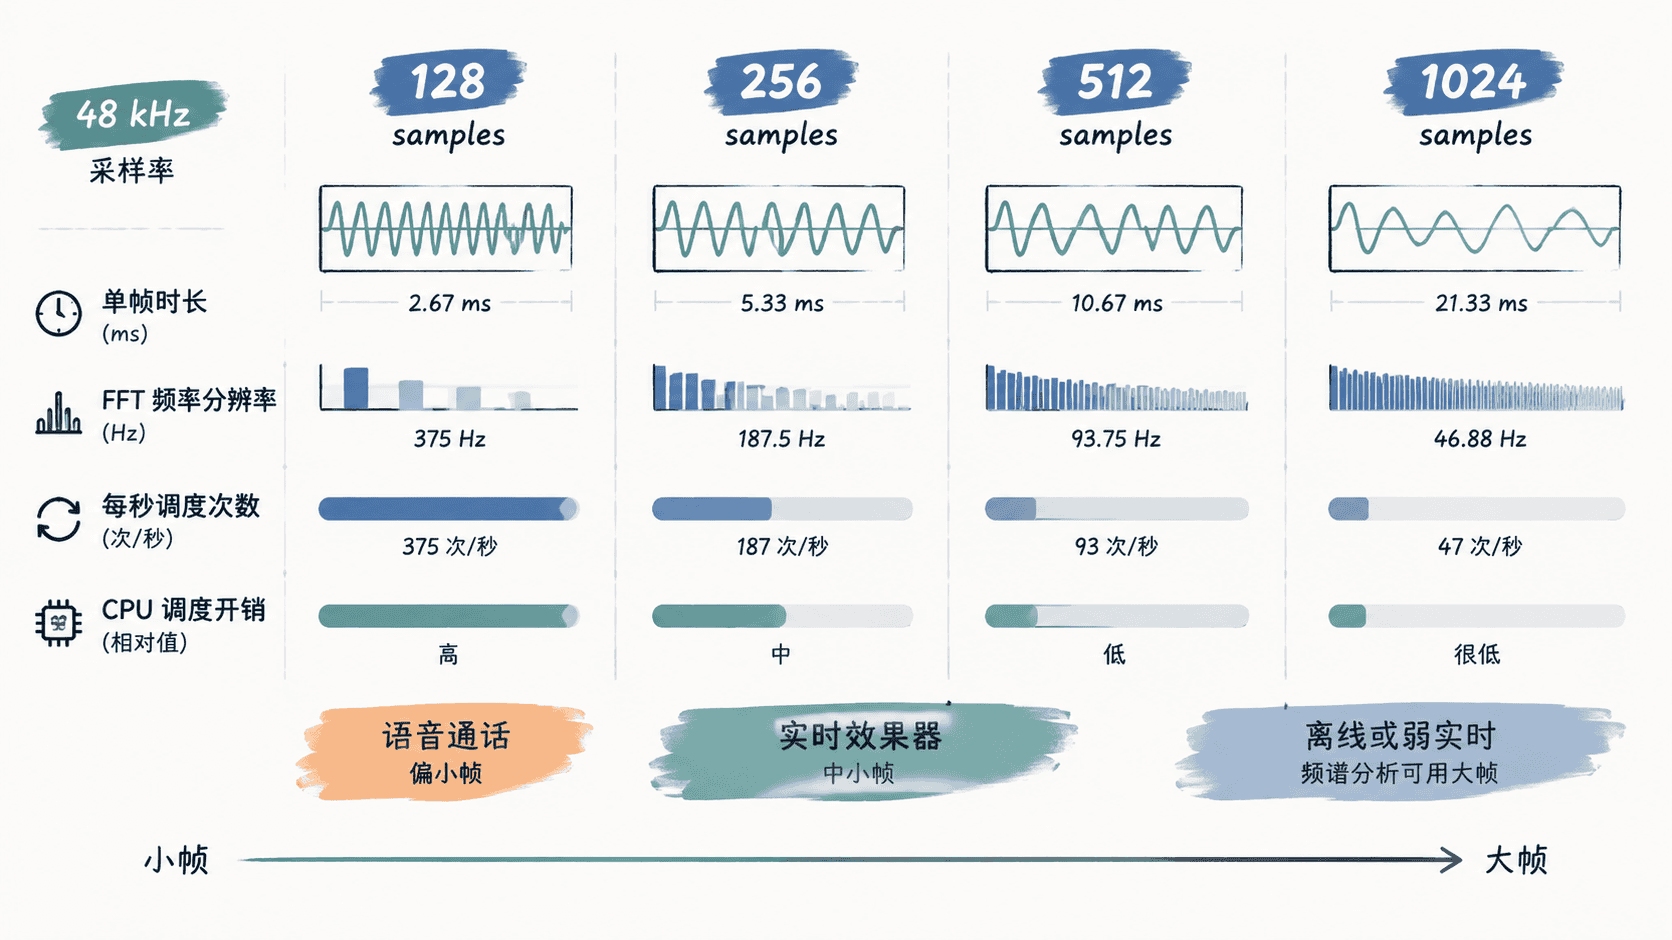
可以先用一个小脚本把候选值量化,避免凭感觉选块大小。
def compare_frames(sample_rate: int, frame_sizes: list[int]) -> None:
    print("N\tframe_ms\tfft_hz\tcallbacks_per_s")
    for n in frame_sizes:
        frame_ms = n / sample_rate * 1000
        fft_hz = sample_rate / n
        callbacks = sample_rate / n
        print(f"{n}\t{frame_ms:.2f}\t\t{fft_hz:.2f}\t{callbacks:.2f}")

if __name__ == "__main__":
    compare_frames(48000, [128, 256, 512, 1024])
预期输出:
N	frame_ms	fft_hz	callbacks_per_s
128	2.67		375.00	375.00
256	5.33		187.50	187.50
512	10.67		93.75	93.75
1024	21.33		46.88	46.88
这些数字只描述块级约束,不等于最终端到端延迟。真实链路还包含设备缓冲、驱动、安全缓冲、算法内部 look-ahead,以及系统调度抖动。
按场景缩小候选范围
语音通话首先看交互延迟,通常从 128 或 256 点开始试;若算法包含降噪、AEC 或多级滤波,应把内部额外缓存一起计入。实时乐器效果器对触感更敏感,也倾向较小帧,但必须保证峰值处理时间明显短于单帧时间。
音乐播放、均衡器或可视化分析通常可以接受更大的块。若核心算法依赖 FFT,512 或 1024 点能换来更细的频率栅格和更低的调度频率;若需要更细分辨率但又不能增加块延迟,可以考虑重叠 STFT,而不是简单无限增大设备回调帧。
用回环脉冲实测往返延迟
最可靠的验证方式是把输出物理或虚拟回接到输入,发送一次脉冲,再在录音流中寻找它出现的位置。下面示例依赖 numpy 与 sounddevice,运行前先执行 pip install numpy sounddevice,并确保输入设备能收到输出设备的回环信号。
import numpy as np
import sounddevice as sd

SAMPLE_RATE = 48000
BLOCK_SIZE = 256
DURATION_S = 1.0

def main() -> None:
    total = int(SAMPLE_RATE * DURATION_S)
    playback = np.zeros(total, dtype=np.float32)
    impulse_index = BLOCK_SIZE * 2
    playback[impulse_index] = 0.8

    recorded = sd.playrec(
        playback,
        samplerate=SAMPLE_RATE,
        channels=1,
        dtype="float32",
        blocksize=BLOCK_SIZE,
    )
    sd.wait()

    captured = recorded[:, 0]
    detected_index = int(np.argmax(np.abs(captured)))
    roundtrip_samples = detected_index - impulse_index
    roundtrip_ms = roundtrip_samples / SAMPLE_RATE * 1000

    print(f"blocksize={BLOCK_SIZE}")
    print(f"roundtrip_samples={roundtrip_samples}")
    print(f"roundtrip_ms={roundtrip_ms:.2f}")

if __name__ == "__main__":
    main()
预期结果:
blocksize=256
roundtrip_samples=<ID>
roundtrip_ms=<TIME>
<ID> 和 <TIME> 取决于声卡、驱动、操作系统和回环路径。若改为 128 点后延迟显著下降且没有欠载,说明更小帧有收益;若延迟变化很小却出现 xrun 或 CPU 峰值,则瓶颈主要不在块等待时间,应优先优化设备缓冲或算法峰值耗时。
用预算而不是单一指标做决定
确定帧长时,可以把一帧周期当作实时预算。例如 48 kHz、256 点只有约 5.33 ms;DSP 回调的最坏执行时间应留出明显余量,不能长期逼近这个上限。与此同时,FFT 分辨率是否足够、设备是否稳定、目标平台是否频繁调度,也必须一起检查。
最终选择应满足三个条件:端到端延迟达到场景要求,峰值处理时间稳定低于块周期,并且频谱或滤波算法的分辨率足够。满足这三项的最小复杂方案,才是合适的帧长。