
音频开发 / 系统课时
正确读写 WAV 与 PCM 数据
正确读写 WAV 与 PCM 数据
这一节解决最常见的音频 I/O 失真问题:先分清 WAV 容器与裸 PCM,再用明确的采样率、位深、声道和端序读取样本,最后完成一次可验证的原样写回,确保时长与 PCM 数据都没有被悄悄改变。
学习目标
- 能解释 WAV 头、数据块与裸 PCM 的区别
- 能正确处理 16 位 PCM 的端序、符号位和声道交织
- 能用时长与原始字节比较验证往返写回
先分清 WAV 容器与 PCM 样本
WAV 通常是 RIFF 容器,文件里除了音频样本,还包含 fmt 、data 等块,用来描述编码格式、声道数、采样率和位深。裸 PCM 只有连续样本,没有这些元数据;拿到 .pcm 文件时,必须从外部同时知道采样率、声道数、位深、符号格式和端序。
不要把“WAV 头固定 44 字节”当成解析规则。合法 WAV 可以包含额外块,data 块也不保证从第 44 字节开始。实际读取应交给能遍历 RIFF chunk 的库,而不是手工跳过固定长度。
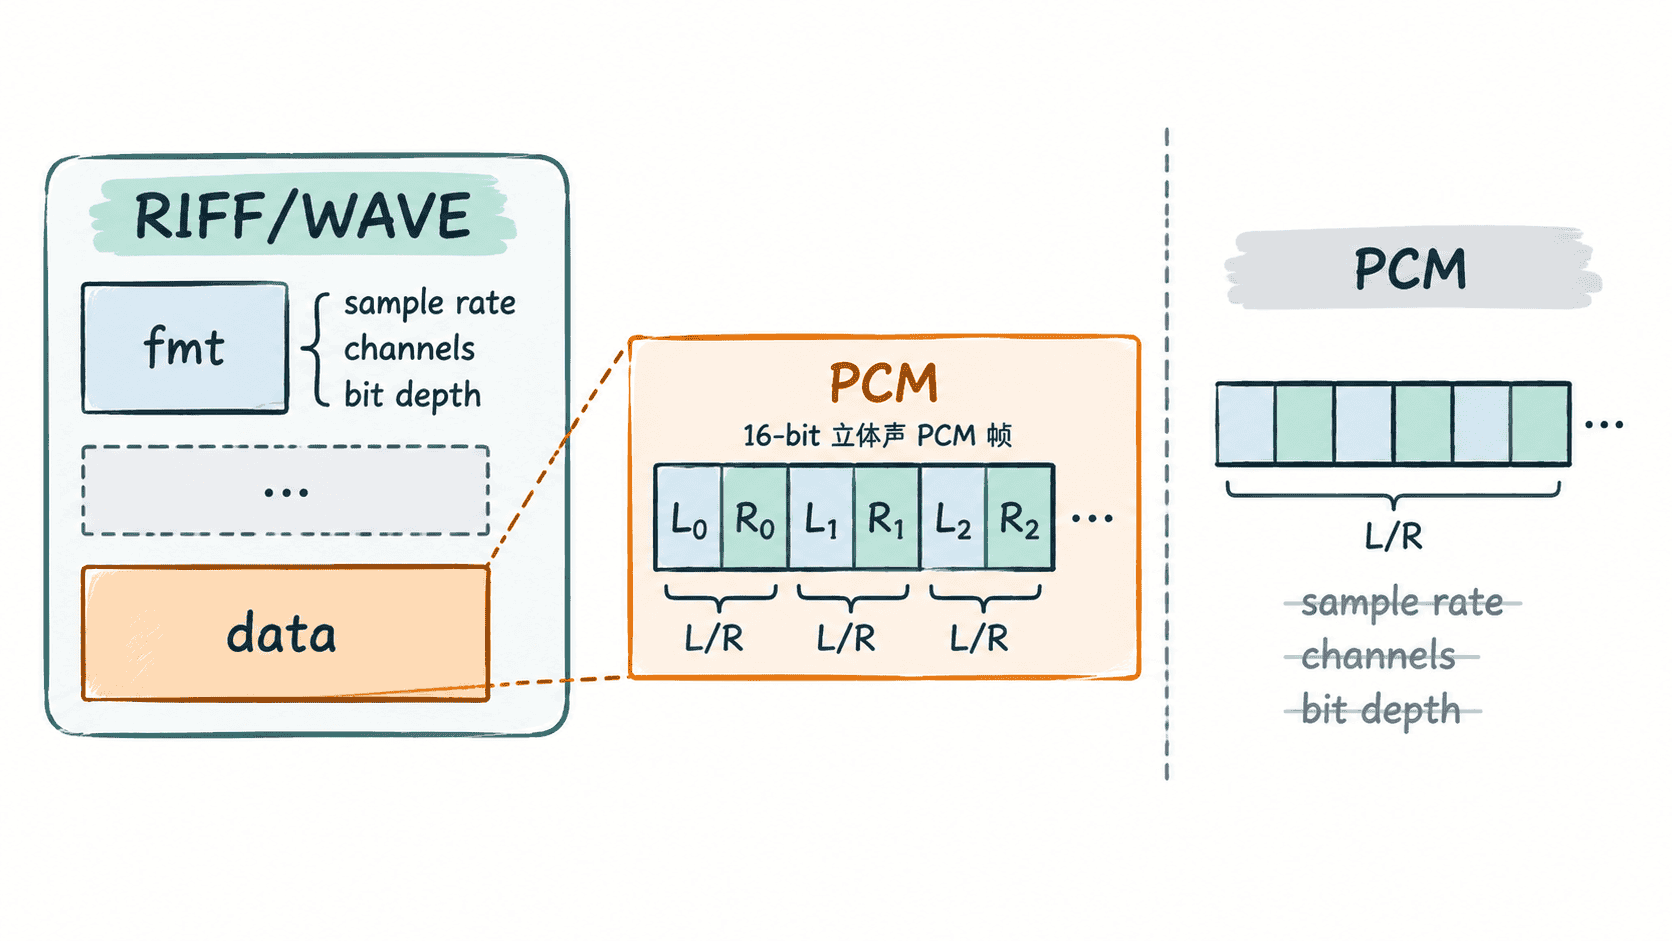
常见的 PCM S16LE 表示“16 位有符号小端整数”。单个样本范围是 -32768~32767;立体声通常按帧交织,即左、右、左、右连续存放,而不是先存完整左声道再存右声道。
用标准库完成无损往返
下面的程序先生成 1 秒、48 kHz、16 位立体声 PCM WAV,再读取参数和样本字节,按原参数写成新文件,最后比较时长与 PCM 内容。这里故意不做浮点缩放,因此可以直接验证 I/O 是否原样保真。
import math
import struct
import wave

SAMPLE_RATE = 48_000
CHANNELS = 2
SAMPLE_WIDTH = 2
FRAMES = SAMPLE_RATE

with wave.open("source.wav", "wb") as wf:
    wf.setnchannels(CHANNELS)
    wf.setsampwidth(SAMPLE_WIDTH)
    wf.setframerate(SAMPLE_RATE)

    pcm = bytearray()
    for i in range(FRAMES):
        t = i / SAMPLE_RATE
        left = round(0.5 * 32767 * math.sin(2 * math.pi * 1000 * t))
        right = round(0.5 * 32767 * math.sin(2 * math.pi * 500 * t))
        # '<hh' 明确使用小端,并按 L/R 顺序写入一个立体声帧。
        pcm.extend(struct.pack("<hh", left, right))
    wf.writeframes(pcm)

with wave.open("source.wav", "rb") as wf:
    params = wf.getparams()
    if params.sampwidth != 2 or params.comptype != "NONE":
        raise ValueError("示例只接受 16-bit 未压缩 PCM WAV")
    raw = wf.readframes(params.nframes)

with wave.open("roundtrip.wav", "wb") as wf:
    # 复用原参数,避免写回时悄悄改变声道、采样率或位深。
    wf.setparams(params)
    wf.writeframes(raw)

with wave.open("roundtrip.wav", "rb") as wf:
    out_params = wf.getparams()
    out_raw = wf.readframes(out_params.nframes)

duration_in = params.nframes / params.framerate
duration_out = out_params.nframes / out_params.framerate

print(f"channels={params.nchannels}")
print(f"sample_rate={params.framerate}")
print(f"sample_width={params.sampwidth}")
print(f"frames={params.nframes}")
print(f"duration={duration_in:.3f}s")
print(f"roundtrip_same_duration={duration_in == duration_out}")
print(f"roundtrip_pcm_identical={raw == out_raw}")
预期输出:
channels=2
sample_rate=48000
sample_width=2
frames=48000
duration=1.000s
roundtrip_same_duration=True
roundtrip_pcm_identical=True
裸 PCM 必须由外部参数解释
同一串字节,在不同参数下可以被解释成完全不同的声音。例如 0x00 0x80 按 16 位小端有符号整数解释是 -32768;若误按大端读取,数值就会变化。裸 PCM 也无法自己告诉你“每两个样本组成一个立体声帧”还是“这是单声道”。
因此读取裸 PCM 前至少要固定五件事:采样率、声道数、每样本位数、有符号或无符号、大小端。文件大小只能帮助推导帧数,不能反推出这些格式参数。
避免四类隐蔽错误
- 端序错误会让字节权重颠倒,波形通常表现为高噪声或严重失真。
- 符号位错误会把负半轴当成大正数,产生明显直流偏置与爆音。
- 声道顺序错误会让左右声道互换;若解交织步长错了,还会造成两个声道都失真。
- 缩放错误常出现在整数与浮点转换。16 位有符号 PCM 转浮点时常按
sample / 32768.0映射到接近[-1, 1);写回前必须限幅,再量化到合法整数范围。
用帧数而不是文件字节判断时长
PCM 音频的时长由“帧数 ÷ 采样率”决定。对于裸 PCM,帧数可由“数据字节数 ÷ 声道数 ÷ 每样本字节数”计算;对于 WAV,应使用 data 块对应的帧数,而不是直接拿整个文件大小计算,因为文件还包含容器头和其他 chunk。
真正可靠的往返验收至少检查三项:声道数、采样率和位深保持不变;输入输出帧数一致;不做处理时 PCM 字节完全一致。这样才能把“听起来差不多”变成可自动化验证的确定结果。