
音频开发 / 系统课时
设计环形缓冲连接设备与 DSP
设计环形缓冲连接设备与 DSP
音频设备回调和 DSP 线程往往不是完全同速:一边按硬件节奏持续写入,另一边按算法块大小读取。直接用普通队列容易引入分配、锁竞争或不可控增长。本节用单生产者单消费者环形缓冲固定内存边界,并用水位判断链路是否正在逼近溢出或欠载。
学习目标
- 理解读指针、写指针、容量和有效数据量之间的关系
- 正确处理回绕、溢出和欠载,不在实时路径动态分配内存
- 用缓冲水位判断设备与 DSP 的长期速率是否匹配
把设备回调和算法节奏解耦
环形缓冲预先分配固定容量,写指针只负责放入新采样,读指针只负责取走待处理采样。指针走到数组末尾后回到开头,因此内存不会随运行时间增长。
对于单生产者单消费者链路,可以让设备回调只写、DSP 线程只读。两端不共享复杂容器,也不需要在实时回调中扩容。真正需要持续观察的是“已用元素数”:它就是缓冲水位。
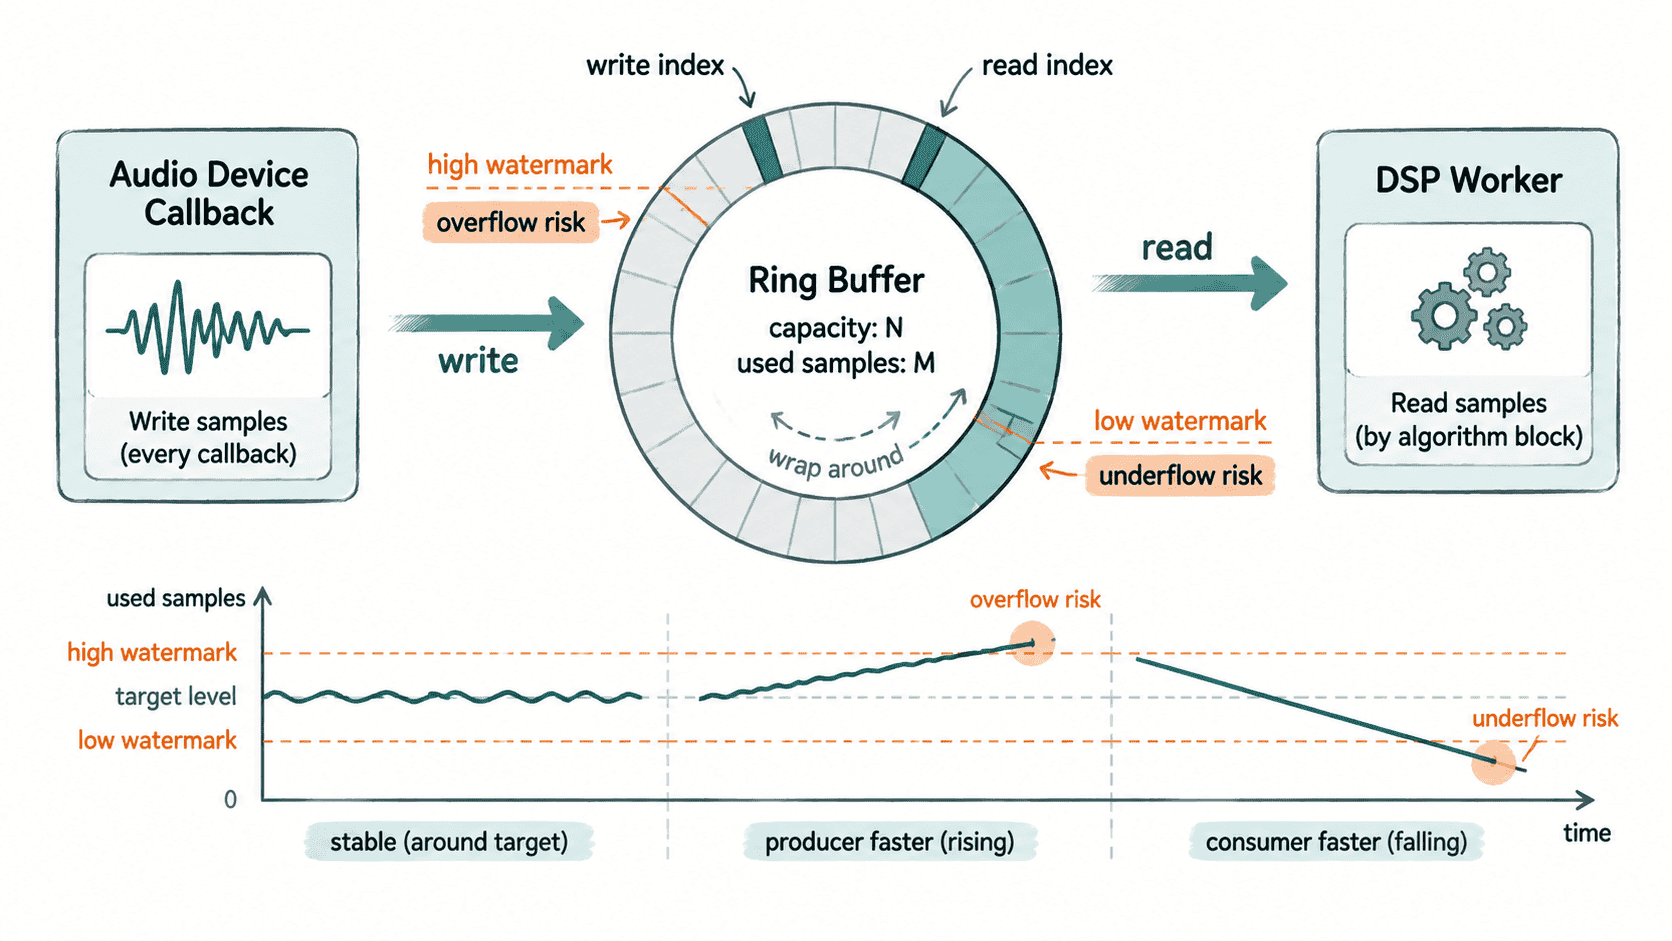
一个实用约束是始终区分“容量”和“当前可读数量”。当可写空间不足时发生溢出;当可读数据少于算法所需块大小时发生欠载。两者都应该计数并上报,而不是静默覆盖或返回未初始化数据。
用固定容量实现 SPSC 环形缓冲
下面是一个可直接编译的 C++20 最小实现。它只服务单生产者、单消费者;通过原子读写索引避免互斥锁,并预先分配固定数组。
#include <array>
#include <atomic>
#include <cstddef>
#include <iostream>

template <std::size_t Capacity>
class FloatRingBuffer {
public:
    bool push(float value) {
        const auto write = write_.load(std::memory_order_relaxed);
        const auto next = increment(write);
        if (next == read_.load(std::memory_order_acquire)) {
            return false; // 满:保留一个槽位区分满和空
        }

        data_[write] = value;
        write_.store(next, std::memory_order_release);
        return true;
    }

    bool pop(float& value) {
        const auto read = read_.load(std::memory_order_relaxed);
        if (read == write_.load(std::memory_order_acquire)) {
            return false;
        }

        value = data_[read];
        read_.store(increment(read), std::memory_order_release);
        return true;
    }

    std::size_t size() const {
        const auto write = write_.load(std::memory_order_acquire);
        const auto read = read_.load(std::memory_order_acquire);
        return write >= read ? write - read : Capacity - (read - write);
    }

private:
    static std::size_t increment(std::size_t index) {
        return (index + 1) % Capacity;
    }

    std::array<float, Capacity> data_{};
    std::atomic<std::size_t> write_{0};
    std::atomic<std::size_t> read_{0};
};

int main() {
    FloatRingBuffer<8> buffer;

    for (int i = 0; i < 5; ++i) {
        std::cout << "push " << i << ": " << buffer.push(static_cast<float>(i))
                  << ", size=" << buffer.size() << '\n';
    }

    float value = 0.0F;
    for (int i = 0; i < 3; ++i) {
        buffer.pop(value);
        std::cout << "pop " << value << ", size=" << buffer.size() << '\n';
    }

    for (int i = 5; i < 9; ++i) {
        std::cout << "push " << i << ": " << buffer.push(static_cast<float>(i))
                  << ", size=" << buffer.size() << '\n';
    }
}
可用 g++ -std=c++20 -O2 ring_buffer.cpp -o ring_buffer && ./ring_buffer 编译运行。
预期输出:
push 0: 1, size=1
push 1: 1, size=2
push 2: 1, size=3
push 3: 1, size=4
push 4: 1, size=5
pop 0, size=4
pop 1, size=3
pop 2, size=2
push 5: 1, size=3
push 6: 1, size=4
push 7: 1, size=5
push 8: 1, size=6
这里容量写成 8,但最多保存 7 个元素,因为实现故意空出一个槽位来区分“读写索引相等时是空还是满”。生产代码也可以额外维护计数器,从而使用全部槽位,但同步逻辑会更复杂。
给溢出和欠载明确策略
实时链路不能只检测异常,还要预先定义处理策略。输入侧溢出通常意味着 DSP 长期跟不上设备,优先记录计数并丢弃一整块或最新数据,具体选择取决于业务;输出侧欠载则应输出静音或保持安全值,不能读取垃圾内存。
环形缓冲也不是越大越安全。容量过大会把速率失配隐藏成越来越高的排队延迟。通常应按“若干个设备块或算法块”估算最小安全容量,再通过水位和 xrun 数据验证。
用水位曲线判断是否稳定
稳定系统的水位会围绕目标区间波动,而不会长期单向漂移。若水位持续上升,说明写入平均速度高于读取速度;若持续下降并频繁触底,说明 DSP 取数节奏过快、设备供数不足,或线程调度偶发停顿。
建议记录每个处理周期的 size()、溢出次数和欠载次数,并同时记录 DSP 峰值处理时间。短时抖动可以靠缓冲吸收,但若数十秒内水位持续偏向一侧,扩大容量只能延后故障,真正的修复是让长期生产速率与消费速率一致。
验收时应满足:正常负载下水位大部分时间处于低、高水位阈值之间;压力测试期间即使出现短时波动,也能自行回到目标区间;溢出和欠载计数在稳定运行阶段保持为零。