
音频开发 / 系统课时
用多相结构降低重采样成本
用多相结构降低重采样成本
这一课把有理数重采样从“插零、整段滤波、再抽取”改写成多相计算。最终你会用同一组 FIR 系数分别跑直接实现和多相实现,验证输出一致,并能按插值倍数估算省掉了多少无效乘法。
学习目标
- 解释多相分解为什么能跳过插零后必然为零的乘法
- 用直接方法与多相方法验证重采样结果数值一致
- 根据 FIR 长度和插值、抽取比例估算主要运算量
直接实现为什么会做无效工作
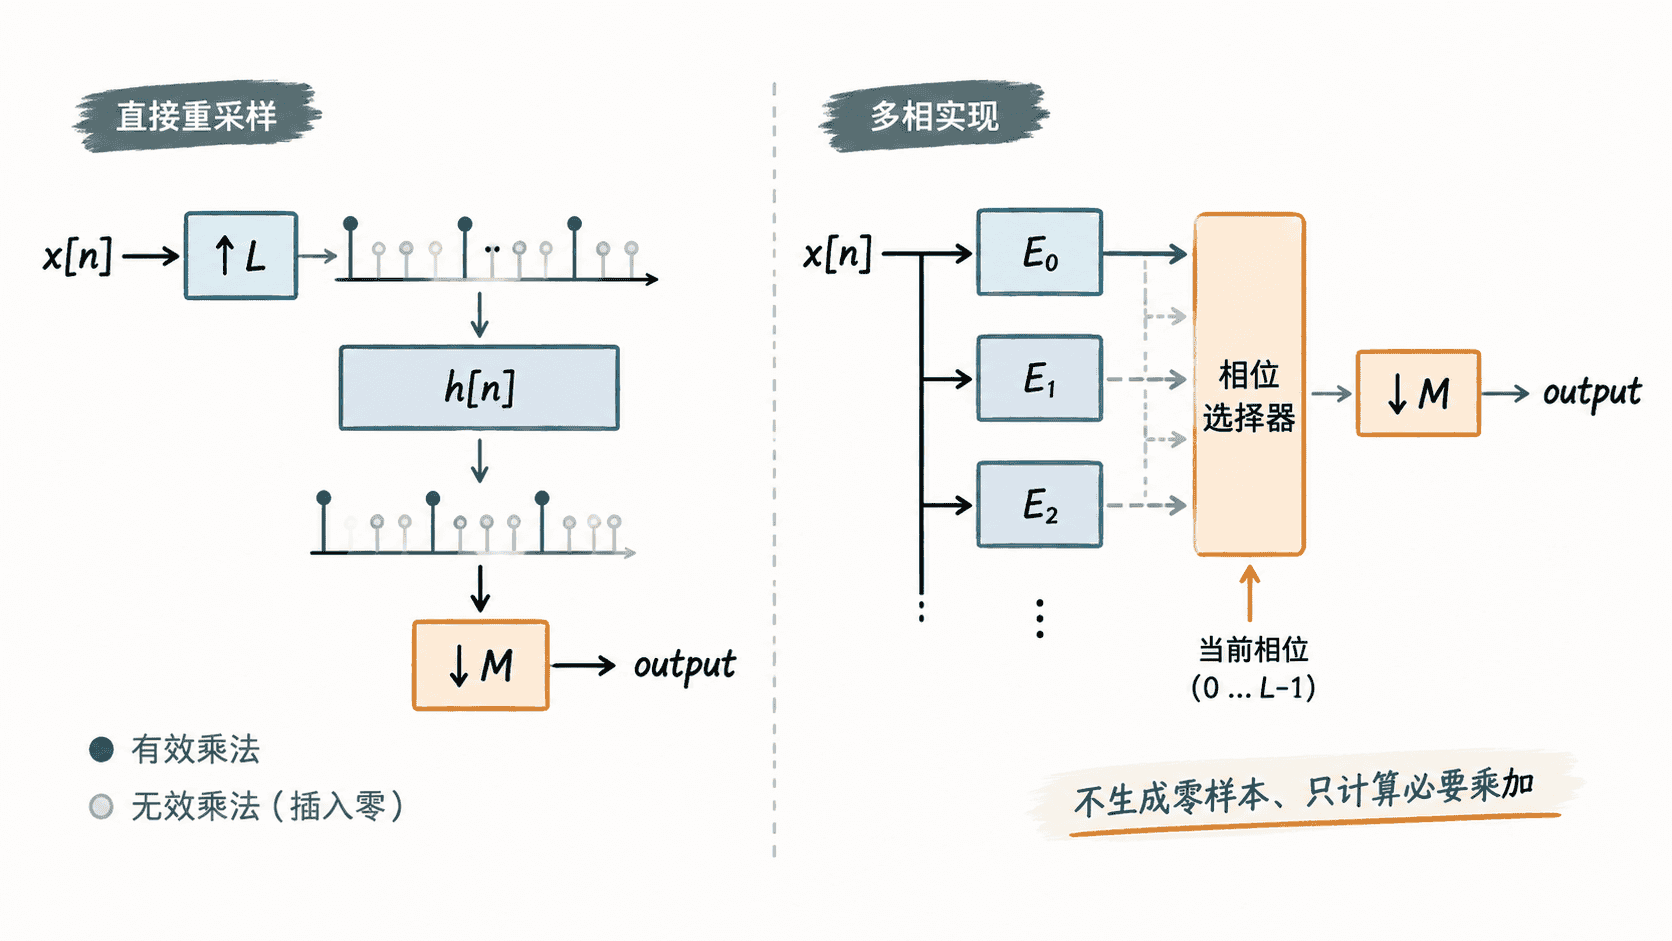
设重采样比例为 。最直观的实现先把输入按 倍插值,在相邻原始样本之间补 个零,再通过低通 FIR,最后每隔 个样本保留一个输出。数学上没有问题,但计算路径里出现了大量已知为零的输入。
如果只关注最终会被保留的输出,直接写法仍会为每个输出遍历全部 个 FIR 系数。实际上,插值后的序列只有每隔 个位置才有一个非零原始样本,因此某个输出时刻真正能参与乘加的系数只落在其中一个相位分支上。
多相分解如何只算必要项
把 FIR 系数按索引对 取模,可以写成 组子滤波器:第 组只保存 。这就是多相分解。每个分支的长度大约是 ,而输出时刻决定当前应该使用哪一组系数。
因此,多相实现不会真的构造插零后的长数组,也不会让 FIR 去乘那些确定为零的位置。它直接从原始输入取样,再用当前相位对应的系数做点积。抽取比例 则决定输出时刻如何推进相位和输入索引。
用同一滤波器验证数值一致
下面用 48 kHz 输入做 3/2 重采样。y_direct 显式构造稀疏插值序列后卷积,upfirdn 使用多相结构完成同一件事。这里的直接实现只用于建立基准,不用于性能测试。
import numpy as np
from scipy.signal import firwin, upfirdn

fs_in = 48_000
L, M = 3, 2
n = 2048
t = np.arange(n) / fs_in
x = np.sin(2 * np.pi * 1000 * t) + 0.3 * np.sin(2 * np.pi * 7000 * t)

# 截止频率按升采样后的归一化频率设计,并乘 L 保持通带增益。
h = firwin(63, 1 / max(L, M), window="hann") * L

# 只保留到最后一个真实输入样本所在的位置,避免尾部额外补零改变长度。
x_up = np.zeros((len(x) - 1) * L + 1)
x_up[::L] = x
y_direct = np.convolve(x_up, h, mode="full")[::M]

# upfirdn 内部按多相形式执行升采样、FIR 和降采样。
y_poly = upfirdn(h, x, up=L, down=M)

print("same_length:", len(y_direct) == len(y_poly))
print("numerically_equal:", np.allclose(y_direct, y_poly, atol=1e-12))
print("direct taps/output:", len(h))
print("polyphase taps/output:", (len(h) + L - 1) // L)
预期输出
same_length: True
numerically_equal: True
direct taps/output: 63
polyphase taps/output: 21
两条结果逐样本一致,说明多相结构只是改变计算顺序,没有改变该 FIR 重采样器的离散系统结果。浮点误差会随平台和库实现略有变化,因此验证时使用容差而不是要求二进制完全相等。
运算量应该怎么估算
忽略首尾边界后,输出样本数大约是输入样本数的 倍。直接对每个保留输出遍历全部 个系数时,总乘法量约为 ;多相实现每个输出只访问约 个系数,总量约为 。
因此,在相同滤波器下,多相结构相对这种直接输出计算大约减少到原来的 。本例 、,每个输出从 63 个系数降到约 21 个。实际速度还会受 SIMD、缓存、块大小和库实现影响,不能把这个理论比例直接当成墙钟时间加速比。
放进实时音频链路时还要保留状态
批处理函数一次拿到完整数组,而实时音频每次只有一个 block。工程实现必须跨 block 保存 FIR 历史样本、当前多相分支以及输入输出相位,否则块边界会重复或漏掉样本。比例固定时可用相位累加器推进;比例变化时还要处理滤波器过渡和时钟漂移。
判断实现是否正确时,先做与直接基准的逐样本容差比较,再看频谱和端到端延迟;性能优化应放在数值等价已经成立之后。