
音频开发 / 系统课时
用卷积实现 FIR 滤波
用卷积实现 FIR 滤波
这一课把 FIR 滤波落到可运行代码:先把离散卷积写成滑动加权和,再把一次性卷积改成分块流式处理,并正确保留块间历史样本。最后用直接卷积做对照,确认实现没有在块边界产生丢样或错位。
学习目标
- 能用离散卷积解释 FIR 每个输出样本如何由当前及历史输入加权得到
- 能实现带状态的分块 FIR,正确处理相邻音频块之间的边界
- 能根据滤波器长度判断频率选择性、延迟与计算量的基本变化
FIR 本质是滑动加权和
长度为 的 FIR 滤波器由一组有限系数 决定。对输入 ,输出为:
计算某个 时,只需要当前样本和前 个输入样本。所谓“卷积”,在实现层面就是让系数窗口沿输入序列滑动,每移动一次做一组乘加。
例如三点平滑滤波器 会把当前样本与前两个样本组合起来。它不会创建无限历史,因此只要保存最近 个输入,就足以继续处理下一块数据。
把一次性卷积改成流式处理
离线处理可以把整段音频一次性传给卷积函数,但实时链路通常每次只拿到一小块样本。关键问题是:新块开头的输出仍依赖上一块末尾的历史样本,不能把每一块当成独立信号。
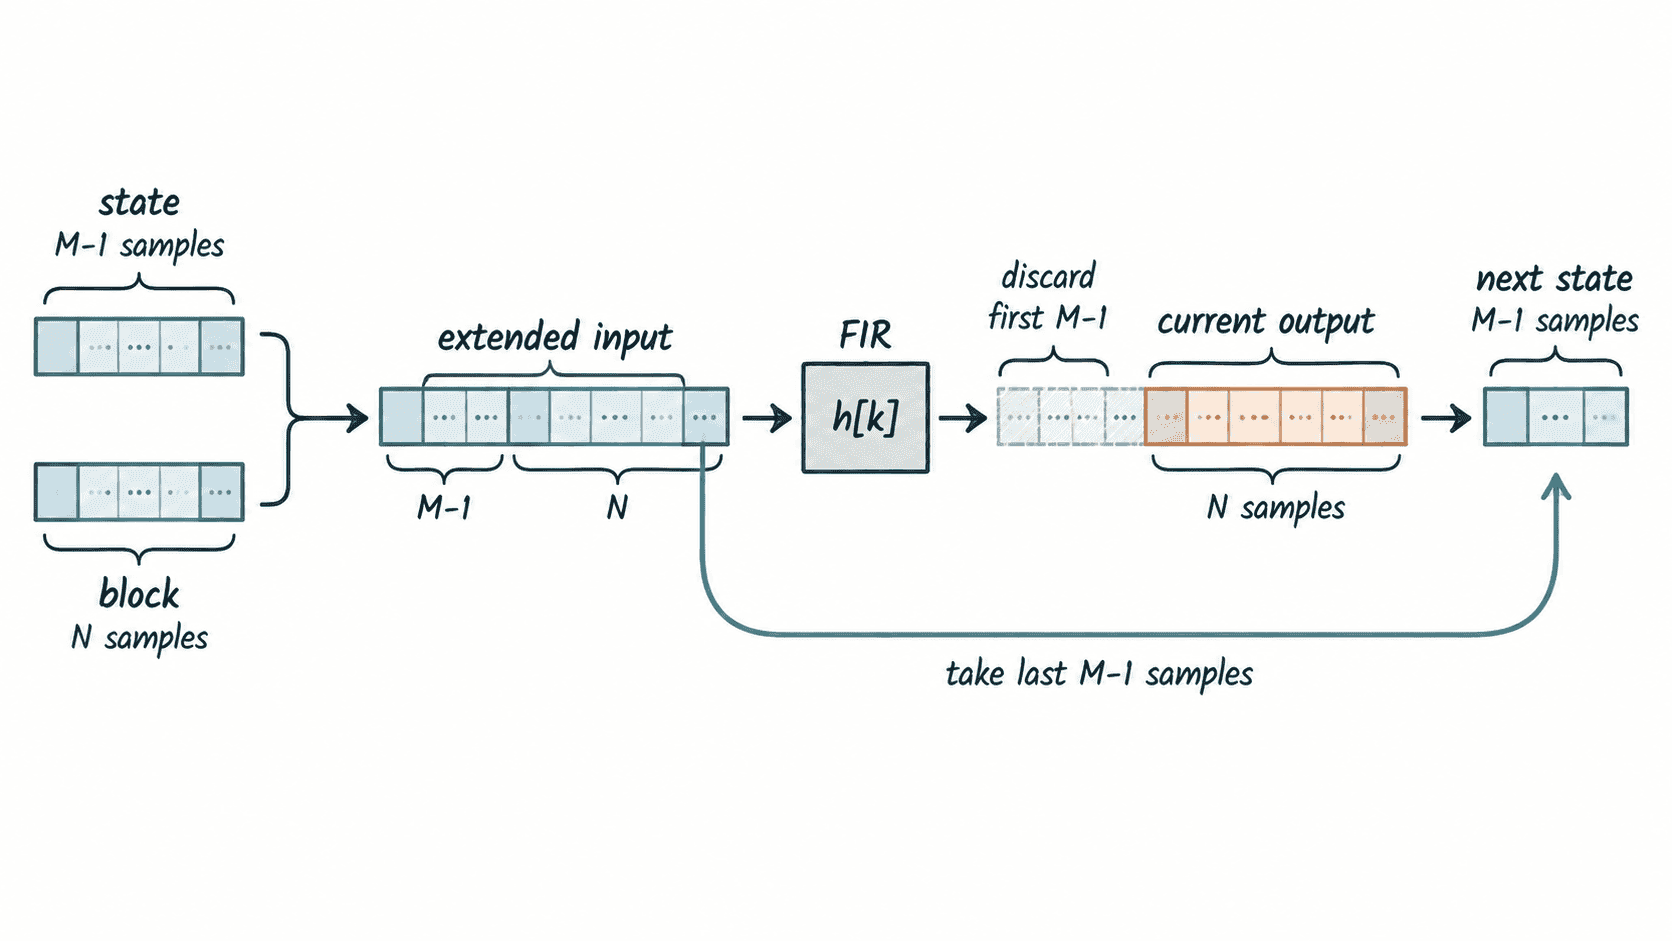
下面的实现把状态封装在 FIRFilter 中。示例依赖 NumPy,可直接运行。
import numpy as np

class FIRFilter:
    def __init__(self, taps):
        self.taps = np.asarray(taps, dtype=float)
        if self.taps.ndim != 1 or len(self.taps) == 0:
            raise ValueError("taps must be a non-empty 1-D sequence")
        # 只保存计算下一块开头所需的 M-1 个历史输入样本。
        self.state = np.zeros(len(self.taps) - 1, dtype=float)

    def process(self, block):
        block = np.asarray(block, dtype=float)
        if block.ndim != 1:
            raise ValueError("block must be 1-D")

        extended = np.concatenate([self.state, block])
        full = np.convolve(extended, self.taps, mode="full")

        # 从与当前 block 第一个样本对齐的位置开始取结果。
        start = len(self.taps) - 1
        out = full[start:start + len(block)]

        if len(self.state) > 0:
            self.state = extended[-len(self.state):].copy()
        return out

h = np.array([0.25, 0.50, 0.25])
x = np.array([1., 2., 3., 4., 5., 6.])

fir = FIRFilter(h)
y_stream = np.concatenate([
    fir.process(x[:3]),
    fir.process(x[3:])
])

# 直接卷积作为参考,只比较与输入等长的因果输出。
y_direct = np.convolve(x, h, mode="full")[:len(x)]

print("stream:", y_stream)
print("direct:", y_direct)
print("equal :", np.allclose(y_stream, y_direct))
预期输出:
stream: [0.25 1.   2.   3.   4.   5.  ]
direct: [0.25 1.   2.   3.   4.   5.  ]
equal : True
这里没有在每块末尾把卷积“尾巴”直接输出,因为这些尾部值还混入了块外默认补零的假设。实时处理中更稳妥的做法是保留输入历史,并在下一块到来后再计算真正属于后续时间位置的输出。
为什么块边界最容易写错
最常见的错误是对每个块直接调用 np.convolve(block, h),再截取前 len(block) 个样本。这样每个新块都会隐式认为块前面全是零,于是块首若干输出与连续信号不一致,听感上可能出现周期性的点击、能量抖动或瞬态异常。
另一个错误是保存上一块的“输出尾巴”而不是输入历史。直接型 FIR 的状态本质上是过去的输入样本;除非你明确实现 overlap-add 或 overlap-save 这类 FFT 卷积算法,否则不要把两种状态模型混在一起。
滤波器长度会改变什么
当采样率固定时,增加 FIR 长度通常能给设计带来更窄的过渡带和更高的频率响应塑形自由度,但代价也直接增加。直接卷积每产生一个输出样本大约需要 次乘法和相近数量的加法,因此计算量与抽头数近似线性增长。
如果系数具有对称性并设计成线性相位 FIR,其群延迟通常约为 个采样。长度越大,实时链路的算法延迟也越明显。对于很长的滤波器,例如房间脉冲响应,直接逐样本卷积往往不再经济,此时更适合分区 FFT 卷积。
实际工程中可以先用较短 FIR 保证链路正确,再根据目标频响逐步增加抽头数。无论怎样调整长度,最先要保持的验证标准都不变:同一输入下,流式分块结果应与连续直接卷积在数值误差范围内一致。