
音频开发 / 系统课时
用 Overlap-Add 处理块边界
用 Overlap-Add 处理块边界
实时音频必须一块一块处理,但每个块与长 FIR 卷积后都会向右延伸。如果直接把块结果首尾拼接,边界处会丢失卷积尾巴并产生突变。本课实现 Overlap-Add:每块先做零填充和 FFT 卷积,再把相邻块的重叠区相加,最后用连续信号验证输出与整段线性卷积一致。
学习目标
- 理解分块卷积为什么会出现重叠区,以及重叠长度如何确定
- 正确实现零填充、频域卷积、重叠相加和尾部处理
- 用参考卷积与边界误差检查确认连续音频没有拼接断点
块边界为什么不能直接拼
设输入块长度为 ,FIR 长度为 。一个输入块与 FIR 做线性卷积后,结果长度不是 ,而是 。其中后面的 个样本会延伸到下一个输入块的时间范围内。
所以第二块的卷积结果不能接在第一块结果末尾,而要从第二块原本的起始位置放入输出,并与第一块延伸过来的尾巴逐样本相加。这就是 Overlap-Add 的核心。
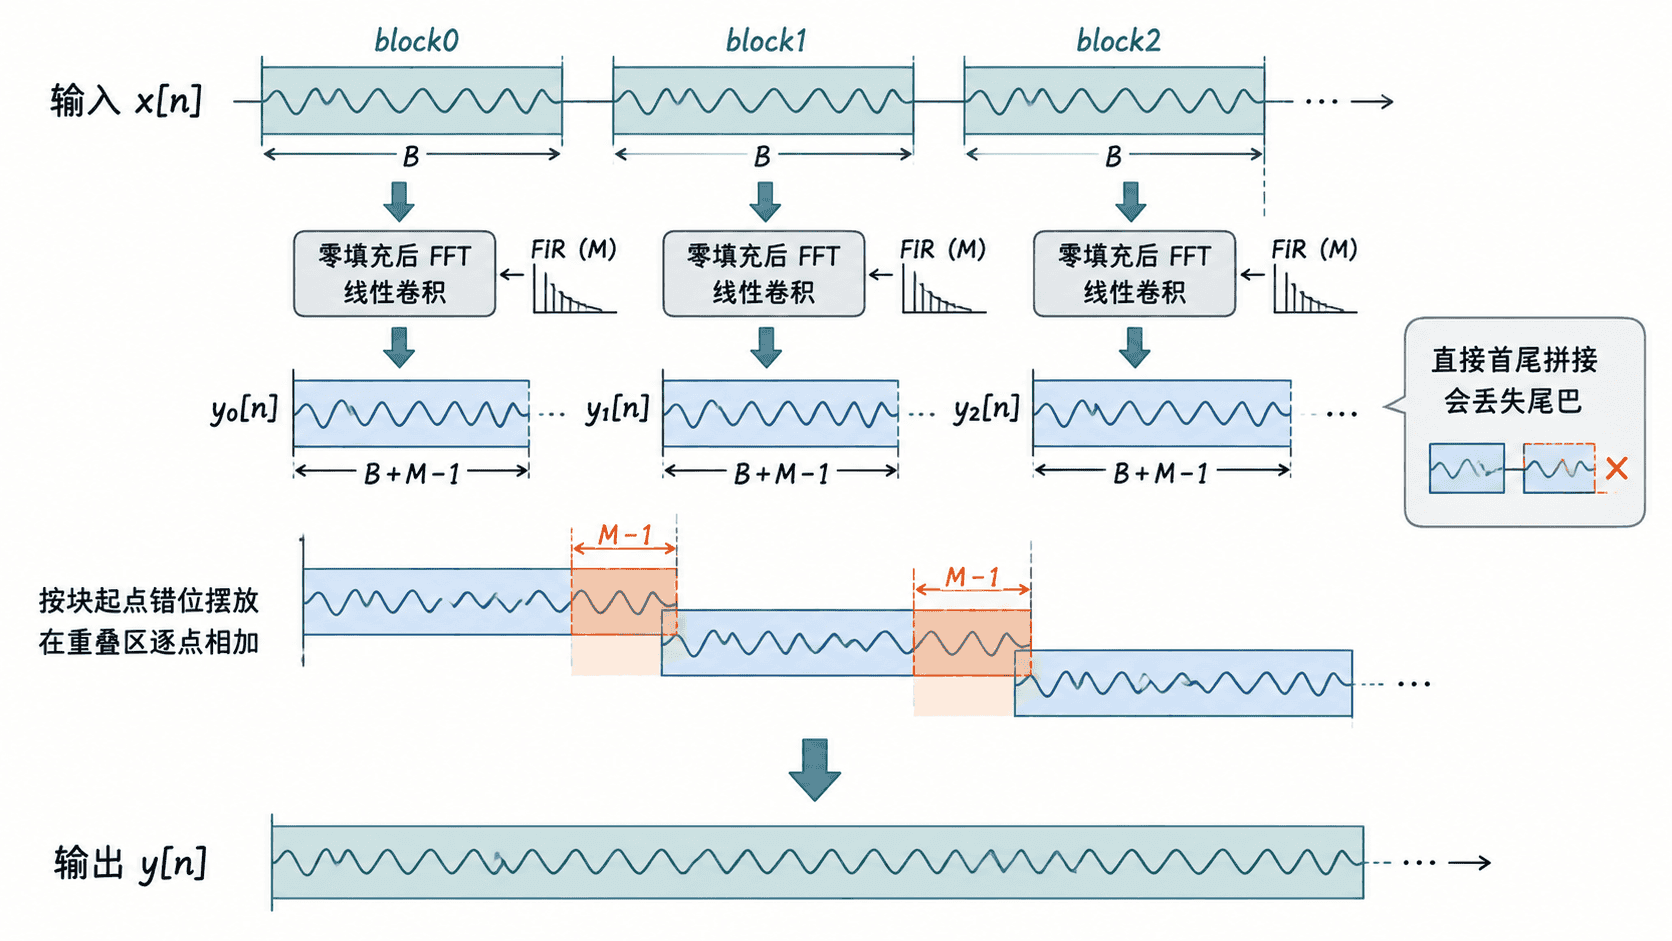
实现 Overlap-Add
下面的实现预先计算 FIR 的频谱,因为同一个滤波器会被所有输入块复用。每次只对当前音频块做 FFT,然后把局部卷积结果累加到全局输出的正确区间。
import numpy as np

def next_pow2(n: int) -> int:
    return 1 << (n - 1).bit_length()

def overlap_add(x: np.ndarray, h: np.ndarray, block_size: int) -> np.ndarray:
    if block_size <= 0:
        raise ValueError("block_size must be positive")
    if len(h) == 0:
        raise ValueError("h must not be empty")

    n_fft = next_pow2(block_size + len(h) - 1)
    h_spec = np.fft.rfft(h, n=n_fft)
    y = np.zeros(len(x) + len(h) - 1, dtype=np.float64)

    for start in range(0, len(x), block_size):
        block = x[start:start + block_size]
        x_spec = np.fft.rfft(block, n=n_fft)
        local = np.fft.irfft(x_spec * h_spec, n=n_fft)

        # 最后一块可能不足 block_size,因此按真实块长计算有效卷积长度。
        valid_len = len(block) + len(h) - 1
        y[start:start + valid_len] += local[:valid_len]

    return y

if __name__ == "__main__":
    rng = np.random.default_rng(23)
    x = rng.standard_normal(10000)
    h = rng.standard_normal(513)

    y_ola = overlap_add(x, h, block_size=1024)
    y_ref = np.convolve(x, h)

    print("length =", len(y_ola))
    print("max_abs_error =", f"{np.max(np.abs(y_ola - y_ref)):.3e}")
    print("allclose =", np.allclose(y_ola, y_ref, rtol=1e-10, atol=1e-10))
预期输出如下,误差末位可能随平台变化。
length = 10512
max_abs_error = <FLOAT_AROUND_1E-13>
allclose = True
这里最重要的两件事是 length 等于 len(x) + len(h) - 1,并且 allclose 为 True。这说明每块的尾巴既没有被丢掉,也没有因为位置错误而重复累计。
零填充如何避免循环卷积污染
对固定块长 ,每块线性卷积的最大长度是 ,因此 FFT 长度必须至少达到这个值。示例进一步取到不小于它的 2 的幂,只是为了让常见 FFT 实现更高效,不是数学上的硬性要求。
如果 n_fft < B + M - 1,本应落在局部结果尾部的样本会绕回当前块开头。即使后面再做 Overlap-Add,也只是把已经污染的块继续相加,无法恢复正确结果。
最后一块也要按真实长度处理。若整段输入长度不是 block_size 的整数倍,最后一块会更短,此时有效局部输出长度应为 len(block) + len(h) - 1,不能固定写成 block_size + len(h) - 1。
用连续音频检查接缝
数值 allclose 能检查整体正确性,但音频工程里还应专门观察块边界。下面构造连续双音信号,用一个指数衰减 FIR 做卷积,并比较每个块边界位置的输出与整段参考卷积。
import numpy as np

def next_pow2(n: int) -> int:
    return 1 << (n - 1).bit_length()

def overlap_add(x: np.ndarray, h: np.ndarray, block_size: int) -> np.ndarray:
    n_fft = next_pow2(block_size + len(h) - 1)
    h_spec = np.fft.rfft(h, n=n_fft)
    y = np.zeros(len(x) + len(h) - 1)

    for start in range(0, len(x), block_size):
        block = x[start:start + block_size]
        local = np.fft.irfft(
            np.fft.rfft(block, n=n_fft) * h_spec,
            n=n_fft,
        )
        valid_len = len(block) + len(h) - 1
        y[start:start + valid_len] += local[:valid_len]

    return y

if __name__ == "__main__":
    sample_rate = 48000
    block_size = 1024
    duration = 0.25
    t = np.arange(int(sample_rate * duration)) / sample_rate

    x = 0.6 * np.sin(2 * np.pi * 440 * t) + 0.3 * np.sin(2 * np.pi * 880 * t)
    h = np.exp(-np.arange(1500) / 350.0)
    h /= np.sum(h)

    y = overlap_add(x, h, block_size)
    ref = np.convolve(x, h)

    boundaries = np.arange(block_size, len(x), block_size)
    boundary_error = np.max(np.abs(y[boundaries] - ref[boundaries]))
    max_error = np.max(np.abs(y - ref))

    print("boundary_count =", len(boundaries))
    print("boundary_error =", f"{boundary_error:.3e}")
    print("max_error =", f"{max_error:.3e}")
    print("seamless =", np.allclose(y, ref, rtol=1e-10, atol=1e-10))
预期输出中,边界数量固定为 11;误差会随平台略有变化,但应接近浮点舍入级别,并且 seamless 为 True。
boundary_count = 11
boundary_error = <FLOAT_AROUND_1E-16_TO_1E-13>
max_error = <FLOAT_AROUND_1E-16_TO_1E-13>
seamless = True
如果整体误差只在块边界附近突然增大,优先检查三个位置:局部结果是否从正确的 start 索引累加、重叠区是否使用 += 而不是覆盖赋值、最后一块的 valid_len 是否按真实块长计算。
选择块长时看两个方向
较小的 block_size 会缩短输入缓冲等待时间,但需要更频繁地执行 FFT;较大的块能提高吞吐,却会拉高算法和缓冲延迟。对于固定 FIR,FFT 长度又由 block_size + len(h) - 1 决定,所以块长变化还可能跨过 2 的幂边界,使单次 FFT 成本突然上升。
实时链路中应先根据音频回调允许的最大延迟限定块长范围,再在候选值上实测 CPU 占用。只要局部 FFT 不发生循环卷积、重叠区按时间位置累加、最后一块正确裁剪,Overlap-Add 就能把分块处理恢复成与整段线性卷积等价的连续输出。