
服务注册与分布式协调 / 系统课时
客户端基础设施封装
客户端基础设施封装
本课实现综合项目共享的 Curator 客户端基础设施。目标是统一连接参数、重试策略、状态监听和关闭顺序,让上层注册、配置、选举和锁模块不再各自管理连接。
学习目标
- 封装
CuratorFramework的创建、启动和关闭 - 正确区分
SUSPENDED、RECONNECTED与LOST - 为重试和生命周期设置清晰边界
只创建一个共享客户端
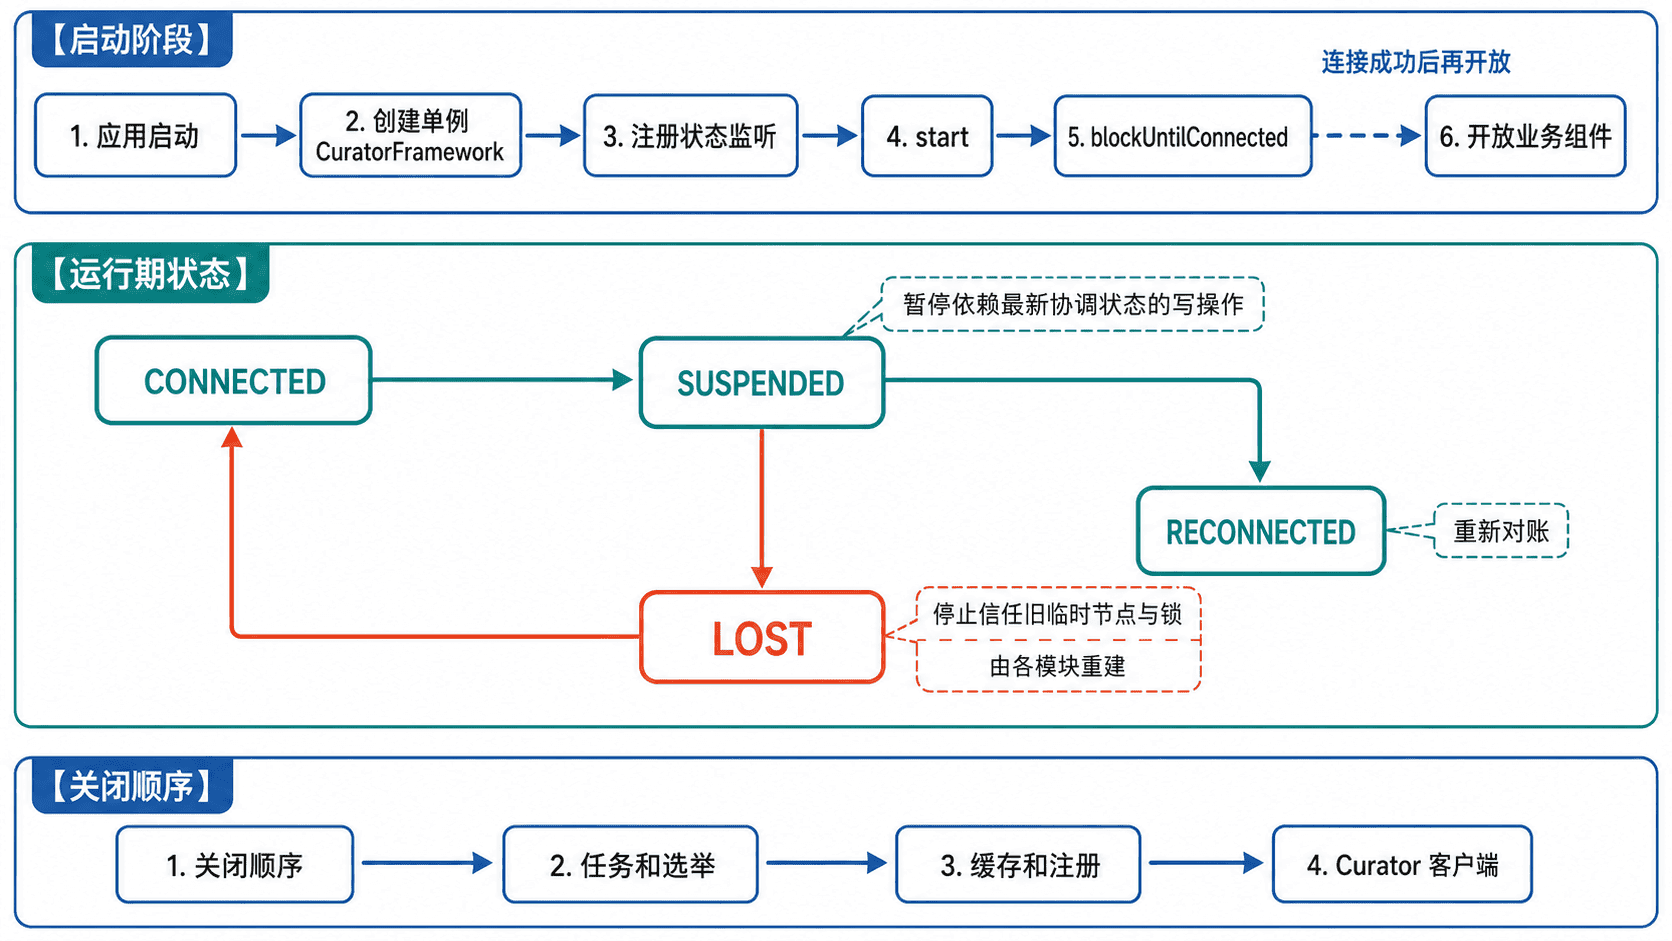
同一进程中的业务模块应复用一个 CuratorFramework。重复创建客户端会增加会话、线程和 Watch 数量,也让连接状态难以统一处理。基础设施层负责在连接成功后开放业务组件,关闭时先停止业务监听,再关闭客户端。
实现客户端管理器
下面是片段示例,依赖 Curator Framework。连接地址、超时和重试次数应由配置注入;上层模块通过同一个 manager 获取客户端。
import java.util.concurrent.TimeUnit;
import org.apache.curator.RetryPolicy;
import org.apache.curator.framework.CuratorFramework;
import org.apache.curator.framework.CuratorFrameworkFactory;
import org.apache.curator.framework.state.ConnectionState;
import org.apache.curator.retry.ExponentialBackoffRetry;

public final class ZkClientManager implements AutoCloseable {
    private final CuratorFramework client;

    public ZkClientManager(String connectString) {
        RetryPolicy retryPolicy = new ExponentialBackoffRetry(500, 5);
        this.client = CuratorFrameworkFactory.builder()
                .connectString(connectString)
                .sessionTimeoutMs(15_000)
                .connectionTimeoutMs(5_000)
                .retryPolicy(retryPolicy)
                .namespace("anystack-demo")
                .build();

        this.client.getConnectionStateListenable()
                .addListener((c, state) -> onStateChanged(state));
    }

    public void start() throws InterruptedException {
        client.start();
        boolean connected = client.blockUntilConnected(10, TimeUnit.SECONDS);
        if (!connected) {
            client.close();
            throw new IllegalStateException("ZooKeeper connection timeout");
        }
    }

    public CuratorFramework client() {
        return client;
    }

    private void onStateChanged(ConnectionState state) {
        System.out.println("ZooKeeper state: " + state);
    }

    @Override
    public void close() {
        client.close();
    }
}
预期行为
启动成功时输出 ZooKeeper state: CONNECTED
短暂断网时可能依次输出 SUSPENDED、RECONNECTED
会话超时后输出 LOST,重新建立连接后再次收到连接状态
应用关闭后客户端线程和监听器被释放
这段代码没有包含业务模块的恢复动作。生产实现应把状态变化发布为内部事件,由注册、配置、选举和锁模块分别处理自己的会话态资源。
正确解释连接状态
SUSPENDED 表示暂时失去连接,但旧会话可能仍有效。此时应暂停必须依赖最新协调状态的写操作,保留本地可用配置,不要立即重复注册临时节点。
RECONNECTED 表示重新连上服务器。使用 Curator recipe 的组件通常会修复部分状态,但业务仍应重新读取关键路径并核对本地缓存,不能假设断线期间的每个事件都会补发。
LOST 表示旧会话已确认失效。临时节点、选举资格和锁所有权都不能继续信任,必须按新会话重建。任何任务执行器收到 LOST 后,都应立即停止以“仍持有锁”为前提的动作。
限制重试边界
指数退避适合短暂故障,但重试次数必须有限。连接级重试不等于业务操作幂等;对不确定写入仍要查询确认,不能让自动重试掩盖重复执行风险。
启动阶段可以等待连接并快速失败,让编排平台决定重启;运行阶段则应进入降级状态并持续报告健康度。两种阶段的策略不要混在一个无限循环中。
生命周期顺序
启动顺序为客户端、状态监听、配置缓存、服务注册、选举和任务模块。关闭顺序相反:先停止接收新任务和选举回调,再关闭缓存与注册 recipe,最后关闭 Curator 客户端。
这样可以避免客户端先关闭后,上层组件仍尝试访问 ZooKeeper,也能减少重复回调和线程泄漏。验证时可连续启动和关闭应用多次,确认会话、线程与 Watch 数量回到基线。
本课总结
- 同一进程复用一个
CuratorFramework,由基础设施层统一管理 SUSPENDED、RECONNECTED和LOST对应不同的业务动作- 重试必须有上限,且不能替代写操作的幂等和结果确认
下一课预告
下一课将在共享客户端之上实现服务实例注册、会话恢复、元数据更新和实例列表监听。