
服务注册与分布式协调 / 系统课时
心跳与会话超时
心跳与会话超时
本课解决会话超时参数“设置了却不一定原样生效”的问题。你将理解 tickTime、客户端请求值与服务端协商值之间的关系,并能为网络抖动和故障检测选择合理超时。
学习目标
- 理解心跳维持会话的工作过程
- 计算会话超时的协商边界
- 验证客户端实际获得的超时时间
心跳如何维持会话
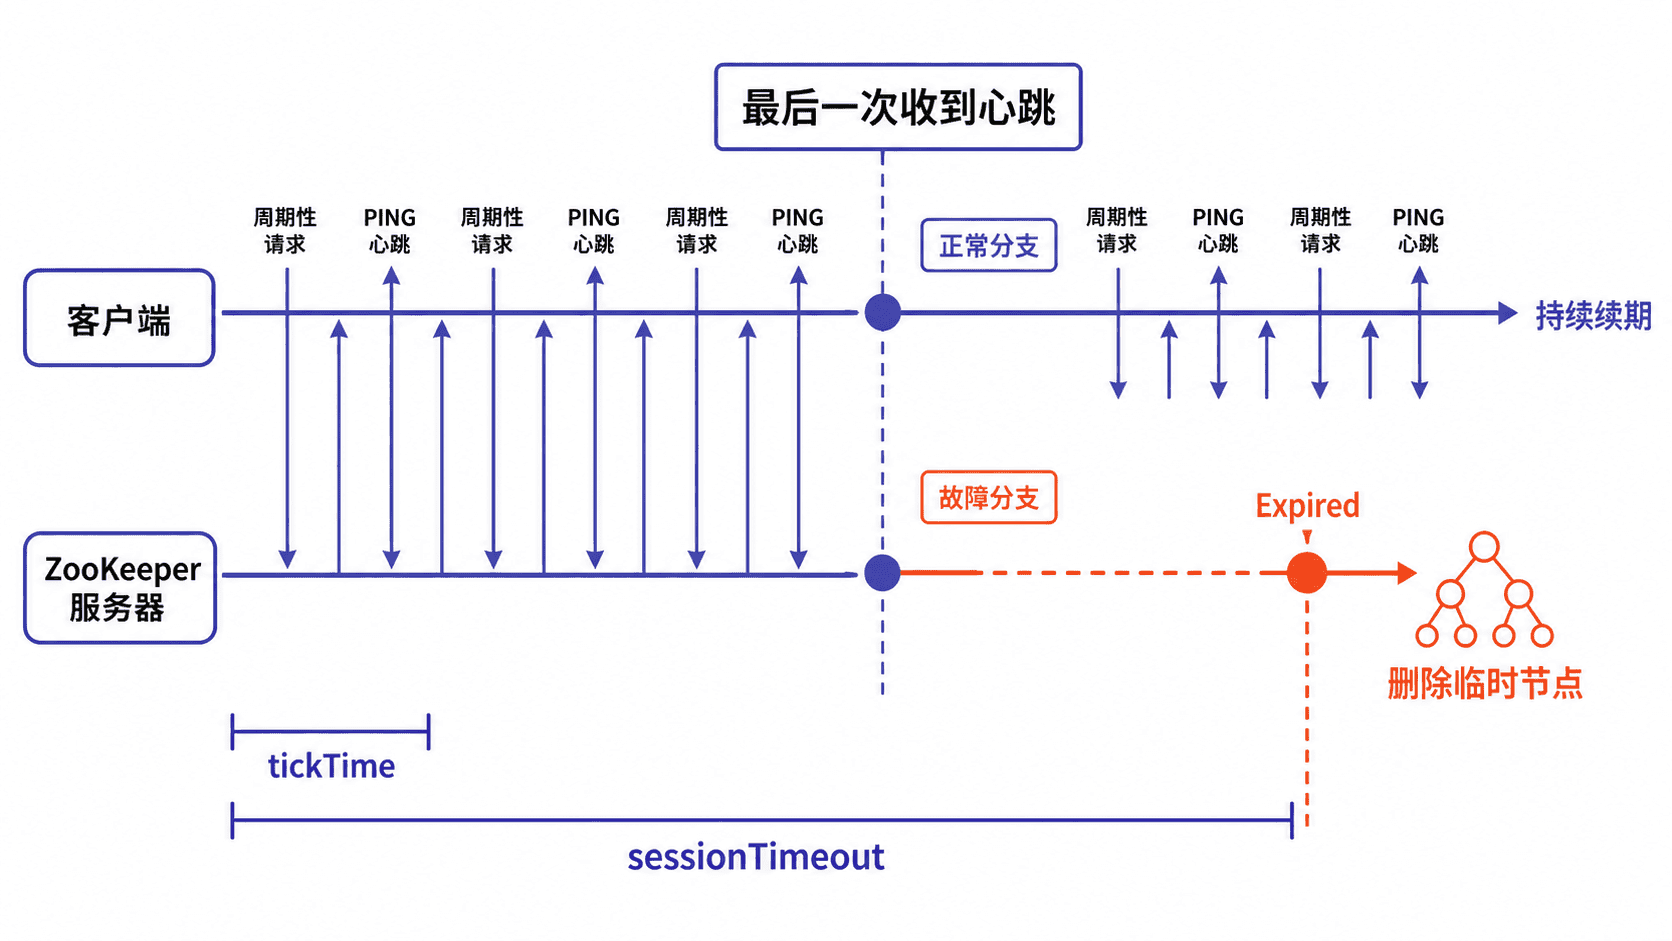
客户端有正常请求时,请求本身可以表明会话仍然活跃;空闲时,客户端库会发送 PING。服务端持续收到该会话的请求或心跳,就会延后过期判断。
TCP 断开通常先被客户端感知,但会话是否过期由服务端依据协商后的会话超时决定。因此“连接断了”和“会话超时了”可能相隔一段时间。
tickTime 与协商范围
tickTime 是服务端用于心跳和超时管理的基本时间单位。默认配置下,服务端通常把客户端请求的会话超时限制在 2 × tickTime 到 20 × tickTime 之间;若显式配置 minSessionTimeout 或 maxSessionTimeout,则以配置后的边界为准,最终值由服务端返回。
配置片段示例:
tickTime=2000
dataDir=/var/lib/zookeeper
clientPort=2181
在该配置且未覆盖最小、最大会话超时的情况下,默认协商范围通常为 4000 到 40000 毫秒。客户端即使请求过小或过大的值,也应以服务端协商结果为准。
读取实际会话超时
片段示例:假设 connectedLatch 会在默认 Watcher 收到 SyncConnected 时释放。
int requestedTimeoutMs = 10_000;
ZooKeeper zk = new ZooKeeper(connectString, requestedTimeoutMs, watcher);

connectedLatch.await();
System.out.println("sessionTimeoutMs=" + zk.getSessionTimeout());
预期结果:
sessionTimeoutMs=<NEGOTIATED_MILLISECONDS><NEGOTIATED_MILLISECONDS> 是服务端确认后的实际值,可能与请求值相同,也可能被调整。业务告警、重试和资源接管时间都应围绕这个值设计。
如何选择超时时间
超时过短能更快清理故障会话,但网络抖动、长时间停顿或服务端繁忙更容易造成误过期。超时过长更稳健,却会延迟临时节点删除、锁释放和领导者接管。
应结合跨机房延迟、故障检测目标、客户端暂停时间和集群负载压测决定。不要用频繁业务轮询代替客户端库的会话维护,也不要把操作超时、连接超时和会话超时混为同一个参数。
本课总结
- 心跳和正常请求共同维持会话活性
- 客户端请求值会受
tickTime和服务端会话超时边界约束 - 设计故障接管逻辑时必须读取并使用实际协商超时
下一课预告
下一课将沿着断线后的时间线,分析客户端如何切换服务器并恢复同一个会话。