
服务注册与分布式协调 / 系统课时
崩溃恢复与数据同步
崩溃恢复与数据同步
ZooKeeper 在 Leader 崩溃后不能立刻恢复写入:新 Leader 必须先确认集群共同认可的事务历史,再让各 Follower 收敛到同一前缀。本篇聚焦 ZAB 的发现、同步阶段,以及 DIFF、TRUNC、SNAP 三种数据同步方式如何处理不同差异。
学习目标
- 说明发现阶段与同步阶段各自解决的安全问题
- 区分 DIFF、TRUNC、SNAP 的适用差异与代价
- 用 zxid 判断事务历史的先后关系,并理解同步完成后才能重新广播写事务
恢复的核心不是选出 Leader
Leader 选举只解决“接下来由谁组织集群”,并不等于数据已经一致。旧 Leader 可能在崩溃前发送过尚未获得多数确认的提议,不同 Follower 也可能停在不同 zxid。新 Leader 若直接接受写入,就可能把未提交尾部当成事实,或覆盖已经提交的事务。
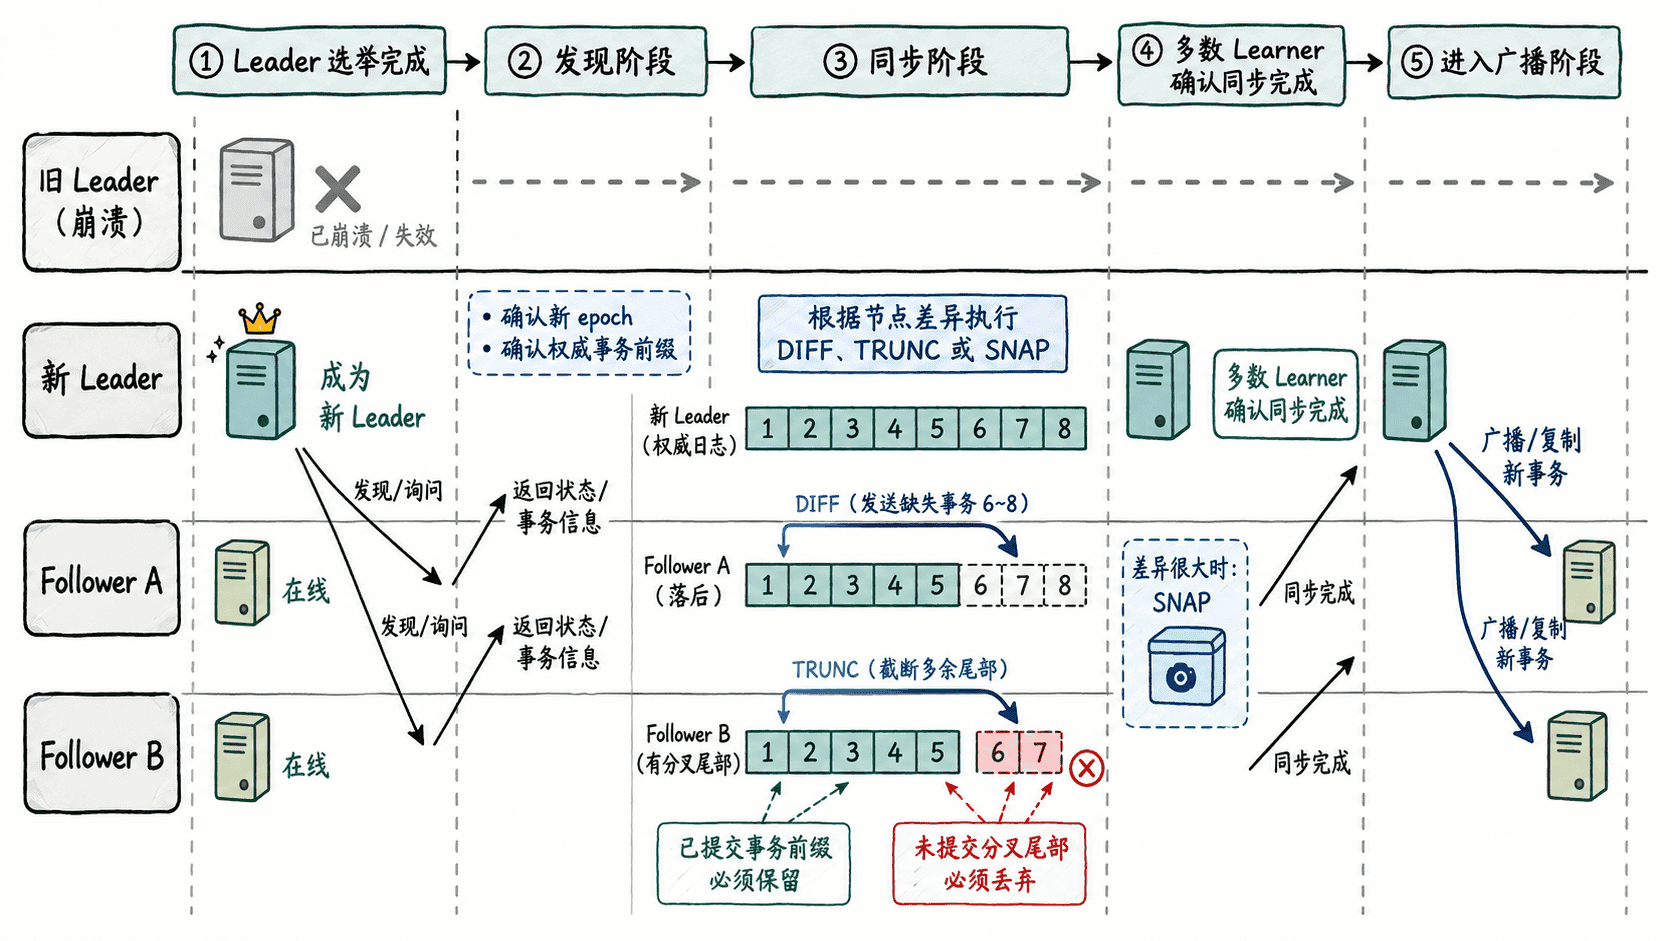
ZAB 的崩溃恢复因此要完成两个动作:先在发现阶段建立新的领导任期并确认权威历史,再在同步阶段把可参与服务的 Learner 对齐到这个历史。只有多数节点完成同步并确认新 Leader 后,集群才进入正常广播阶段。
发现阶段确定权威历史
zxid 是 ZAB 事务顺序的重要标识,高位可理解为 Leader 任期对应的 epoch,低位是该任期内递增的事务计数。恢复时,新 Leader 需要基于选举结果和多数节点反馈确认新的 epoch,并确保自己所采用的事务历史不会遗漏已经被多数确认的提交。
安全目标可以概括为“保留已提交前缀,拒绝分叉尾部”。如果某个 Follower 比权威历史少,它可以补齐;如果它多出的是未被新 Leader 接受的尾部,就必须回退;如果缺口已经无法通过现存事务日志补齐,则需要用完整状态重新建立基线。
下面的 Python 程序不是 ZooKeeper 源码算法,而是一个可运行的教学模型,用“Follower 最后 zxid 是否落在 Leader 可提供的事务日志窗口内”帮助理解三类同步选择。
def sync_mode(follower_zxid: int, log_min: int, leader_last: int) -> str:
    if follower_zxid < log_min:
        return "SNAP"
    if follower_zxid <= leader_last:
        return "DIFF"
    return "TRUNC"

log_min = 0x0000000500000020
leader_last = 0x000000050000002A

cases = {
    "behind-but-in-log": 0x0000000500000026,
    "diverged-tail": 0x0000000500000031,
    "too-old-for-log": 0x00000004000000F0,
}

for name, zxid in cases.items():
    print(f"{name}: {sync_mode(zxid, log_min, leader_last)}")
预期输出:
behind-but-in-log: DIFF
diverged-tail: TRUNC
too-old-for-log: SNAP
真实 ZooKeeper 还会结合 epoch、事务历史连续性以及 Leader 当前可用日志范围判断,不能只凭“zxid 大小”手工决定同步方式。
三种同步方式如何收敛
| 方式 | 典型条件 | 对 Follower 的处理 |
|---|---|---|
| DIFF | Follower 历史是权威历史的前缀,且缺失事务仍在 Leader 可发送的日志范围内 | 发送缺失事务,让 Follower 追到当前提交点 |
| TRUNC | Follower 带有不属于权威历史的尾部 | 先截断到双方共同认可的 zxid,再继续补齐需要的事务 |
| SNAP | 差距过大,或 Leader 已没有足够的历史日志完成增量补齐 | 发送快照/完整数据库状态,以新的基线重新开始 |
DIFF 的网络和磁盘成本通常最低;TRUNC 的关键是删除“看起来更新但没有成为权威历史”的尾部;SNAP 成本最高,却能在日志窗口不足时恢复长期离线或差距过大的节点。三者不是管理员手工选择的恢复策略,而是 Leader 根据双方历史关系自动决定的同步路径。
同步完成才重新开放广播
完成数据搬运还不够。Learner 必须把同步结果应用到本地,并确认新 Leader 对应的时代与历史;Leader 收到足够确认后,才能安全进入正常广播阶段。此后新的事务继续按 ZAB 的提议、确认和提交顺序推进。
因此,崩溃恢复的本质不是“找到存活节点里数据最多的那台机器”,而是建立一个被多数节点接受、包含所有已提交事务且不存在非法分叉的权威前缀,再让集群围绕这个前缀收敛。