
服务注册与分布式协调 / 系统课时
监控与故障演练
监控与故障演练
这节课把 ZooKeeper 的“健康”变成可观察、可验证的信号,并在保留多数派的前提下演练断网、节点宕机、会话过期与 Leader 切换,最终得到一套可重复执行的故障注入与验收方法。
学习目标
- 用
mntr、srvr建立角色、延迟、连接数和请求积压的监控基线。 - 在不破坏多数派的前提下模拟网络隔离、进程停止和会话过期,并识别对应信号。
- 验证 Leader 重新选举、客户端恢复和节点重新加入是否符合预期。
建立演练前的监控基线
故障演练前先记录正常值,否则故障发生后只能看到“变了”,却不知道是否异常。至少关注 zk_server_state、zk_avg_latency、zk_max_latency、zk_outstanding_requests、zk_num_alive_connections、zk_znode_count 与 zk_watch_count。稳定集群中应只有一个 Leader,其余可投票节点通常为 Follower。
本课用四字命令做最小化采集。ZooKeeper 若启用了命令白名单,需要允许 mntr、srvr 和 ruok;生产环境不要配置通配符 *,也不要把四字命令端口暴露给不可信网络。
SERVERS=("<IP1>:2181" "<IP2>:2181" "<IP3>:2181")

for server in "${SERVERS[@]}"; do
  host="${server%:*}"
  port="${server#*:}"
  echo "== $server =="
  printf 'mntr\n' | nc -w 2 "$host" "$port" | grep -E 'zk_server_state|zk_avg_latency|zk_max_latency|zk_outstanding_requests|zk_num_alive_connections|zk_znode_count|zk_watch_count'
done
预期输出
== <IP1>:2181 ==
zk_avg_latency  <VALUE>
zk_max_latency  <VALUE>
zk_num_alive_connections  <VALUE>
zk_outstanding_requests  0
zk_server_state  leader
zk_watch_count  <VALUE>
zk_znode_count  <VALUE>
== <IP2>:2181 ==
...
zk_server_state  follower
== <IP3>:2181 ==
...
zk_server_state follower<IP1>、<IP2>、<IP3> 和各指标实际值会因环境而不同。重点不是追求固定数字,而是保存“正常角色 + 正常区间”,演练时再比较变化幅度。
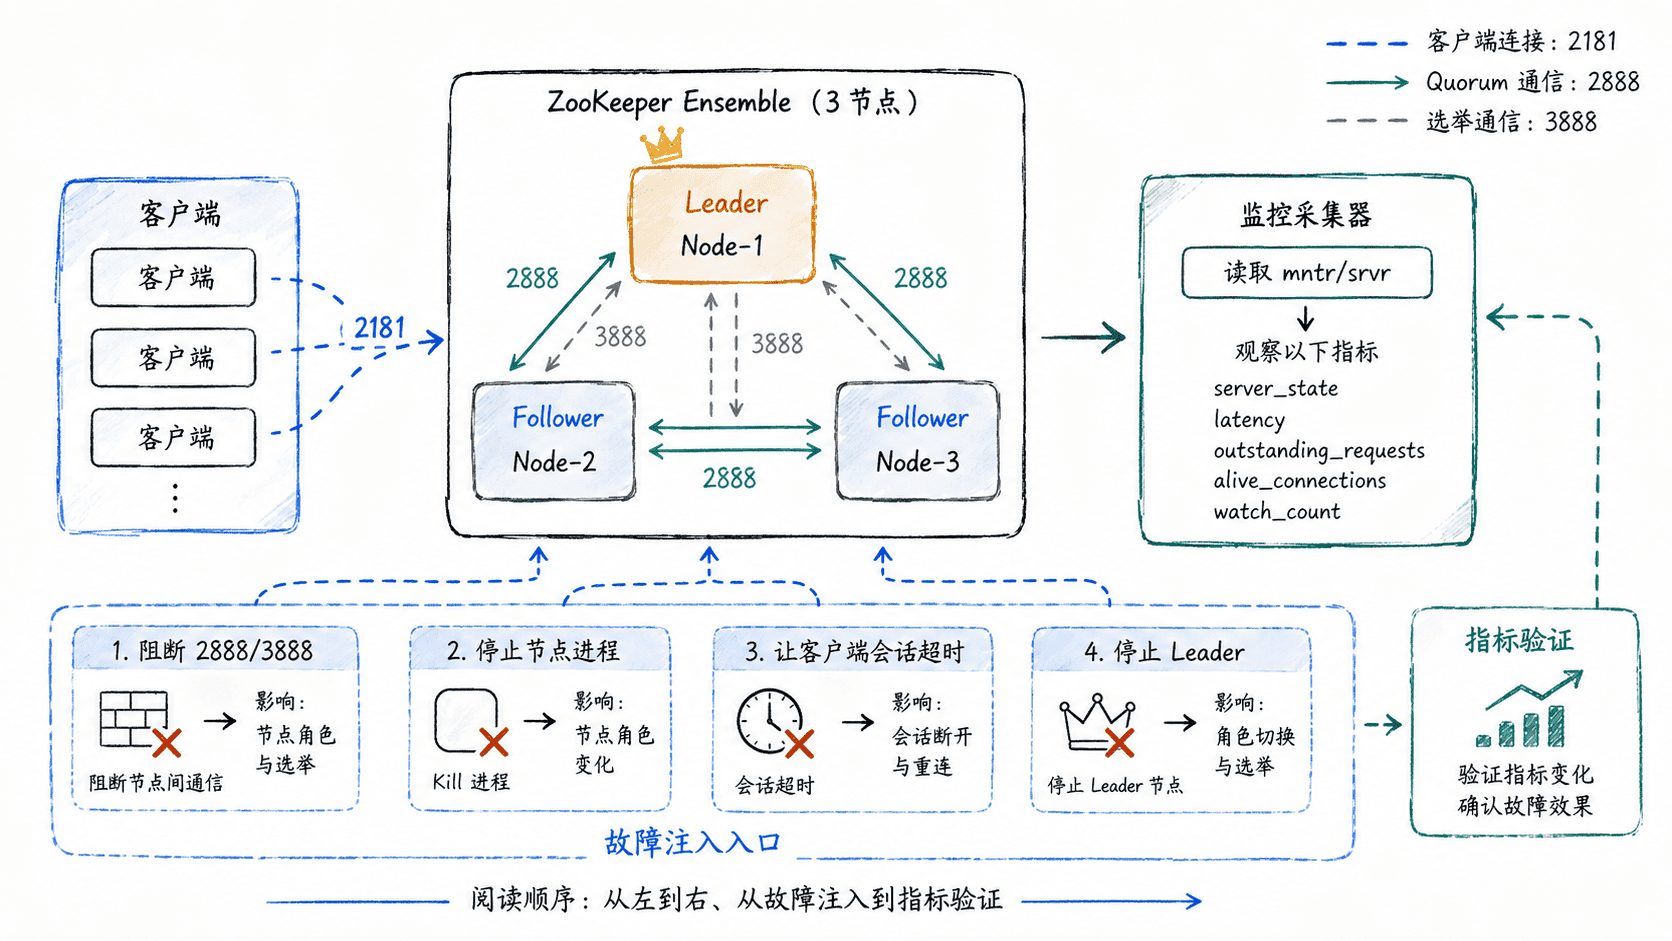
演练断网与节点宕机
网络演练优先隔离一个 Follower 的 quorum 端口,而不是直接断整机网卡,这样既能观察失联行为,又不会把 SSH 管理链路一并切断。下面命令应在目标 Follower 上执行;执行前确认集群至少还能保留多数派,并准备自动清理规则。
cleanup() {
  sudo iptables -D INPUT -p tcp -m multiport --dports 2888,3888 -j DROP 2>/dev/null || true
  sudo iptables -D OUTPUT -p tcp -m multiport --dports 2888,3888 -j DROP 2>/dev/null || true
}
trap cleanup EXIT

sudo iptables -I INPUT 1 -p tcp -m multiport --dports 2888,3888 -j DROP
sudo iptables -I OUTPUT 1 -p tcp -m multiport --dports 2888,3888 -j DROP
sleep 15
cleanup
trap - EXIT
预期结果
隔离期间:目标节点无法维持正常 quorum 通信;多数派侧仍保持一个 Leader 并继续提供服务。
规则清理后:目标节点重新连接并同步数据,最终恢复为 follower 或 observer 等正常角色。
单节点宕机演练应先停 Follower,再停 Leader。使用系统服务管理时,在目标主机执行下面命令,其中 <VALUE> 替换为实际 ZooKeeper 服务单元名。每次只注入一个变量,便于把指标变化和根因对应起来。
SERVICE="<VALUE>"
sudo systemctl stop "$SERVICE"
sleep 10
sudo systemctl is-active "$SERVICE" || true
sudo systemctl start "$SERVICE"
sudo systemctl is-active "$SERVICE"
预期输出
inactive
active演练会话过期
会话过期最直观的验证对象是临时节点。下面用 zkCli.sh 创建临时节点后直接杀死客户端进程,不发送正常关闭会话请求;等待会话超时后,再用新客户端读取该节点。ZK_HOME 和连接串需要替换为实际值。
ZK_HOME="<PATH>"
ZK_CONNECT="<IP1>:2181,<IP2>:2181,<IP3>:2181"
FIFO="/tmp/zk-session-drill-<ID>"
LOG="/tmp/zk-session-drill-<ID>.log"

rm -f "$FIFO"
mkfifo "$FIFO"
"$ZK_HOME/bin/zkCli.sh" -server "$ZK_CONNECT" -timeout 8000 <"$FIFO" >"$LOG" 2>&1 &
CLI_PID=$!
exec 3>"$FIFO"

printf 'create -e /drill-session "<ID>"\n' >&3
sleep 2
kill -9 "$CLI_PID"
exec 3>&-

sleep 12
printf 'get /drill-session\n' | "$ZK_HOME/bin/zkCli.sh" -server "$ZK_CONNECT"
rm -f "$FIFO"
预期输出
Node does not exist: /drill-session如果节点仍存在,先确认客户端是否真的被杀死,再检查服务端允许的最小、最大会话超时范围。客户端请求的 8000 毫秒可能会被服务端重新协商,因此生产演练应以服务端实际协商值为准,而不是机械等待固定 12 秒。
验证 Leader 切换与恢复闭环
先用 srvr 找到当前 Leader,再只停止这一个节点。Leader 离开后,只要剩余投票节点仍构成多数派,集群应在短暂选举后产生新的 Leader;客户端可能经历一次重连,但不应长期失去读写能力。
SERVERS=("<IP1>:2181" "<IP2>:2181" "<IP3>:2181")

for server in "${SERVERS[@]}"; do
  host="${server%:*}"
  port="${server#*:}"
  mode="$(printf 'srvr\n' | nc -w 2 "$host" "$port" | awk -F': ' '/Mode/ {print $2}')"
  printf '%s -> %s\n' "$server" "${mode:-unreachable}"
done
预期输出
<IP1>:2181 -> leader
<IP2>:2181 -> follower
<IP3>:2181 -> follower
在 <IP1> 所在主机停止 ZooKeeper 后,重复执行角色检查:应看到原 Leader 不可达,另外两个节点中恰好一个变为 leader。恢复原节点后再次检查,它通常会以 Follower 身份重新加入。与此同时比较演练前后的 zk_avg_latency、zk_outstanding_requests 和连接数;这些指标应在选举窗口内短暂波动,随后回落到新的稳定基线。
一次合格的演练不以“服务最终起来了”为结束,而要同时满足三个条件:多数派始终可解释、客户端会话行为符合预期、监控指标能准确指出故障开始与恢复时间。这样监控、故障注入和恢复步骤才形成可复用的生产 Runbook。