
服务注册与分布式协调 / 系统课时
ZooKeeper 的一致性保证
ZooKeeper 的一致性保证
本课解决“ZooKeeper 到底保证什么、又不保证什么”的问题。学完后,你能用五项核心保证解释写入顺序、数据可靠性和读取新鲜度,并避免把 ZooKeeper 误认为所有读取都具备线性一致性。
学习目标
- 说清全局顺序、客户端顺序、单一系统映像、可靠性和及时性
- 区分 ZooKeeper 的一致性保证与线性一致性
- 根据保证边界选择正确的读写方式
五项核心保证
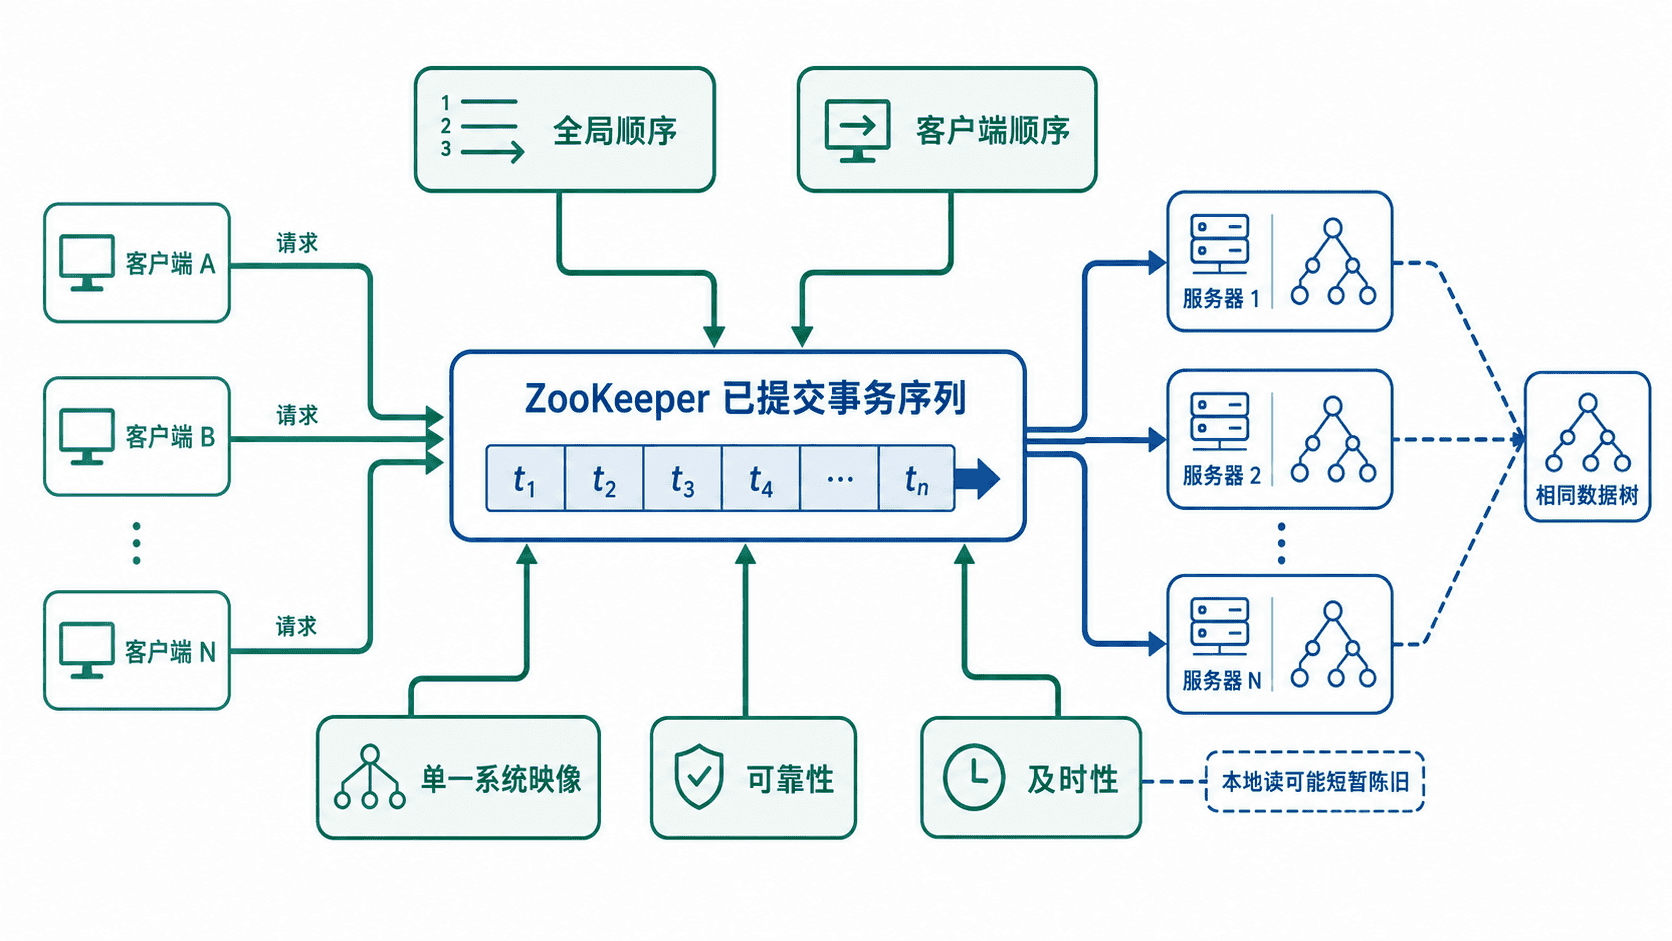
ZooKeeper 将所有成功提交的更新放入一个全局顺序中。每个客户端发出的请求也按发送顺序处理,因此同一会话内不会出现后发写入先于先发写入生效的情况。
- 全局顺序:所有更新都能按同一事务顺序排列。
- 客户端顺序:同一客户端的请求按发送顺序执行。
- 单一系统映像:客户端连接任意正常服务器,最终观察到的是同一份逻辑数据树。
- 可靠性:已提交更新不会因单个节点故障而丢失,除非之后被新更新覆盖。
- 及时性:各服务器会在有限时间内追上已提交状态,但本地读取可能短暂落后。
它不等于所有读取都线性一致
写请求必须经过 Leader 和多数派确认,而普通读请求通常由当前连接的服务器直接返回。若该服务器尚未应用最新提交,另一个客户端刚完成的写入可能暂时不可见。因此,单一系统映像强调一致的逻辑数据树,不代表任意时刻的每次本地读都返回全局最新值。
同一客户端在写操作成功返回后继续读取,可以依靠会话内顺序观察自己的更新;跨客户端依赖最新值时,应使用版本检查、显式同步或由业务协议建立屏障。
用一次配置切换验证边界
假设客户端 A 把 /config/payment 从 v1 更新为 v2,写请求成功时说明该更新已经进入多数派可恢复的事务历史。客户端 B 若连接到尚未应用该事务的 Follower,紧接着读取仍可能短暂得到 v1。
验证时可记录 A 写入返回后的节点版本,再让 B 先执行 sync,随后读取同一路径并检查值与版本。若业务还要继续修改配置,应使用期望版本执行条件更新,避免把一次新鲜读取误当成并发写入保护。
设计时如何利用这些保证
配置发布、主节点选举和分布式锁通常依赖“更新有统一顺序”和“已提交结果可靠保存”。业务代码应把状态变化设计为小型、可版本化的 znode 更新,并通过版本号防止并发覆盖。
ZooKeeper 不适合保存大对象,也不应把一次普通读取当作跨客户端强一致查询。需要严格读后写因果关系时,应先确认前置写已提交,再读取或执行条件更新。
本课总结
- ZooKeeper 为更新提供统一顺序、原子提交和可靠保存
- 普通读取可能短暂陈旧,不能直接等同于线性一致读取
- 版本检查、会话顺序和同步屏障用于处理更严格的因果关系
下一课预告
下一课将沿请求链路拆解本地读和 Leader 写,解释两者为何具有不同的延迟与一致性表现。