
服务注册与分布式协调 / 系统课时
Leader 频繁切换
Leader 频繁切换
本课解决 ZooKeeper 集群反复选举、Leader 很快失位的问题。你将按“确认现象、区分网络与停顿、核对超时、修复后验证”的顺序定位根因,避免只靠调大参数掩盖真实故障。
学习目标
- 从多节点日志确认是否发生重复选举
- 区分网络抖动、进程停顿、磁盘长尾与参数问题
- 制定不破坏多数派安全性的修复和验证方案
先确认是否真的在重复选举
客户端偶发重连不等于 Leader 切换。应同时检查多台服务器日志,寻找 LOOKING、LEADING、FOLLOWING、NEWLEADER 等状态在短时间内反复出现,并核对相同时间段是否伴随会话抖动。
LOG_DIR=/var/log/zookeeper
grep -E "LOOKING|LEADING|FOLLOWING|NEWLEADER|LEADERINFO" "$LOG_DIR"/zookeeper*.log | tail -n 50
预期输出
<TIME> peer state changed: FOLLOWING
<TIME> peer state changed: LOOKING
<TIME> NEWLEADER zxid=<ZXID>
<TIME> peer state changed: LEADING
实际日志格式会随版本变化。判断重点不是匹配某一行,而是多个投票节点在相近时间进入 LOOKING,随后完成新一轮选举。
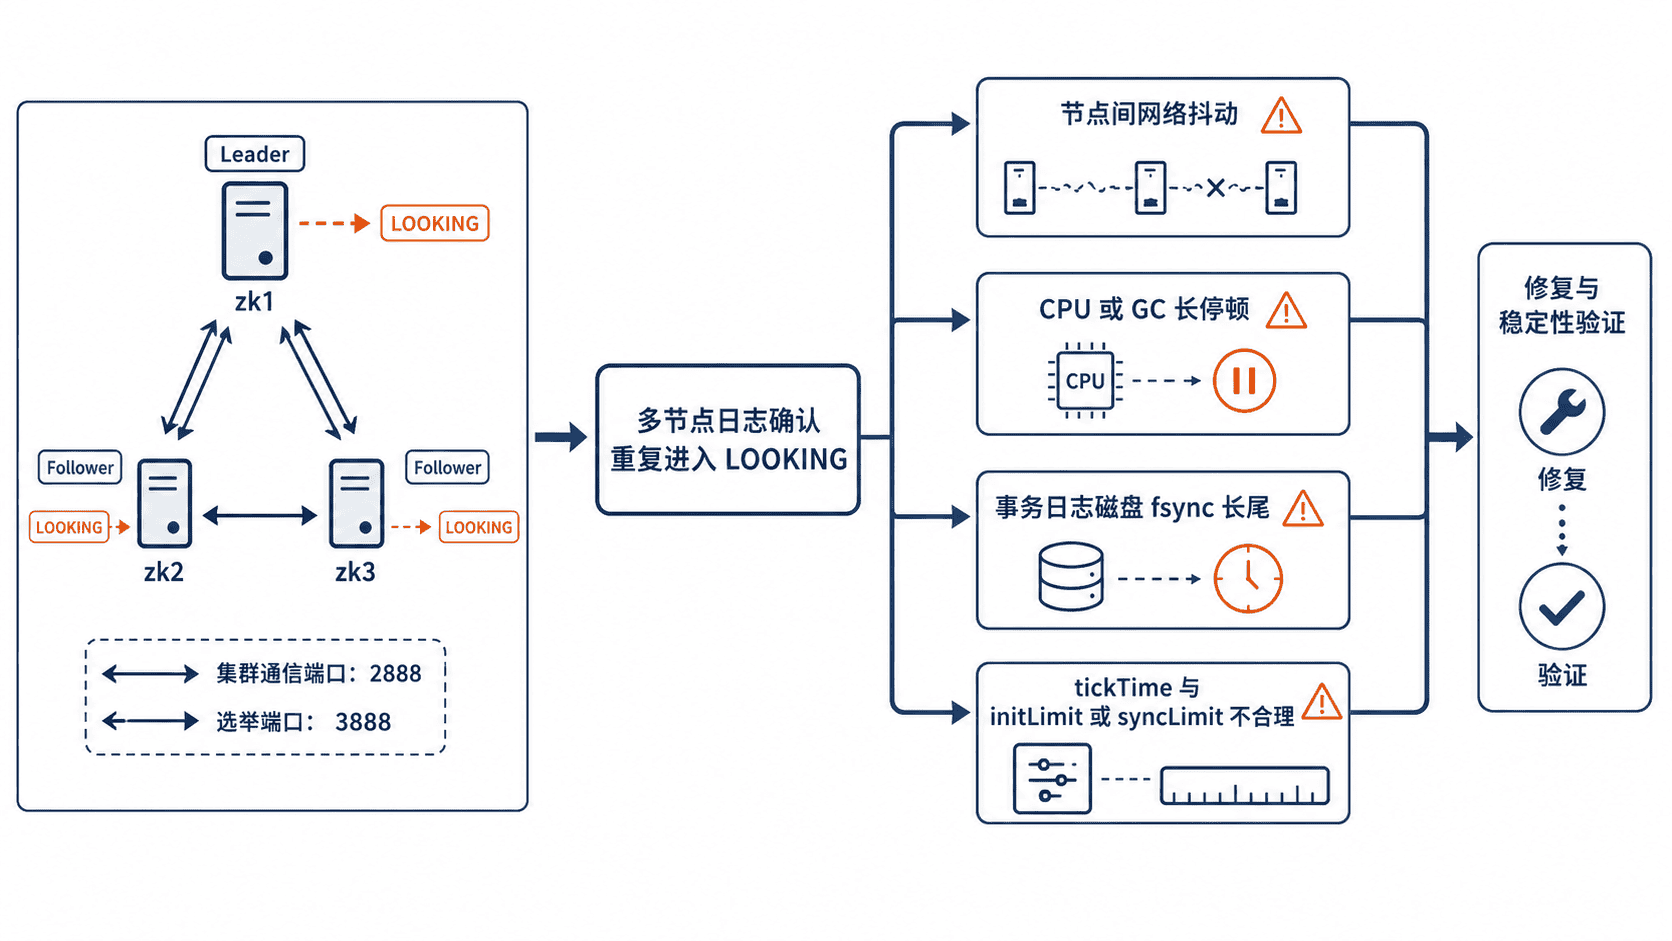
按影响面定位根因
先检查节点间通信。默认情况下,2888 用于集群通信,3888 用于选举;安全组、跨可用区抖动、NAT、连接跟踪耗尽或双向丢包,都可能让节点误判对端失联。探测必须从每台节点分别连向其他节点,不能只从运维机单向测试。
再看进程停顿。长时间 Stop-The-World、CPU 被同机任务抢占、容器 CPU 限额过低,会让心跳与选举线程无法及时调度。若选举时间与 GC pause 或系统负载峰值重合,应先解决资源停顿。
最后检查磁盘。Leader 写事务日志并等待多数派确认,fsync 长尾会拖慢提议提交;Follower 长时间无法跟进也可能退出同步状态。重点观察 await、队列长度和尖峰,而不只看平均吞吐。
PEERS="zk-2 zk-3"
for host in $PEERS; do
  nc -vz "$host" 2888
  nc -vz "$host" 3888
done

uptime
iostat -x 1 3
预期输出
Connection to zk-2 2888 port [tcp/*] succeeded!
Connection to zk-2 3888 port [tcp/*] succeeded!
<TIME> up <UPTIME>, load average: <LOAD_1>, <LOAD_5>, <LOAD_15>
Device  r/s  w/s  await  aqu-sz  %util
<DEVICE> <VALUES>
端口失败或连接频繁重建时继续排查网络;负载与 GC 停顿同时升高时处理资源争用;磁盘 await 出现明显长尾时检查事务日志盘和同盘任务。
核对超时参数
tickTime 是基本时间单位,Follower 初始连接和同步窗口约为 tickTime × initLimit,运行期同步容忍窗口约为 tickTime × syncLimit。参数过小会放大短暂抖动,过大则延迟故障发现和重新选举。
调整前应记录节点间 RTT、GC 最大停顿和磁盘长尾,再留出合理余量。所有投票节点必须使用一致的关键参数;不要把参数放大到足以掩盖分钟级停顿,持续停顿通常意味着资源或部署架构需要修复。
修复与验证
网络问题优先消除跨区不稳定链路、端口策略和丢包;资源问题应为 ZooKeeper 预留 CPU、内存与低争用磁盘;时间同步应保持各节点时钟稳定,但不要通过回拨系统时间处理漂移。
修复后至少跨越一个业务高峰观察:角色保持稳定,日志不再反复进入 LOOKING,客户端断开率下降,GC 与磁盘长尾回到基线。再安排单节点重启演练,确认剩余节点仍能维持多数派,并在预期时间内完成正常选举。
本课总结
- 重复选举要由多节点状态日志共同确认,不能只看客户端重连
- 网络、进程停顿和磁盘长尾都可能表现为心跳或同步超时
- 超时参数应基于实测基线调整,修复后必须验证角色稳定性
下一课预告
下一课将沿请求链路拆解延迟升高问题,分别检查客户端排队、服务端处理、事务日志同步和多数派确认。