
服务注册与分布式协调 / 系统课时
日志损坏与数据恢复
日志损坏与数据恢复
本课解决 ZooKeeper 因事务日志或快照损坏而无法启动、反复退出或无法完成数据加载的问题。你将先保护现场,再根据多数派是否健康选择单节点重建或整集群备份恢复。
学习目标
- 识别事务日志和快照损坏的常见启动现象
- 根据健康多数派状态选择安全恢复路径
- 完成恢复后的角色、数据和业务一致性验证
立即隔离并保护现场
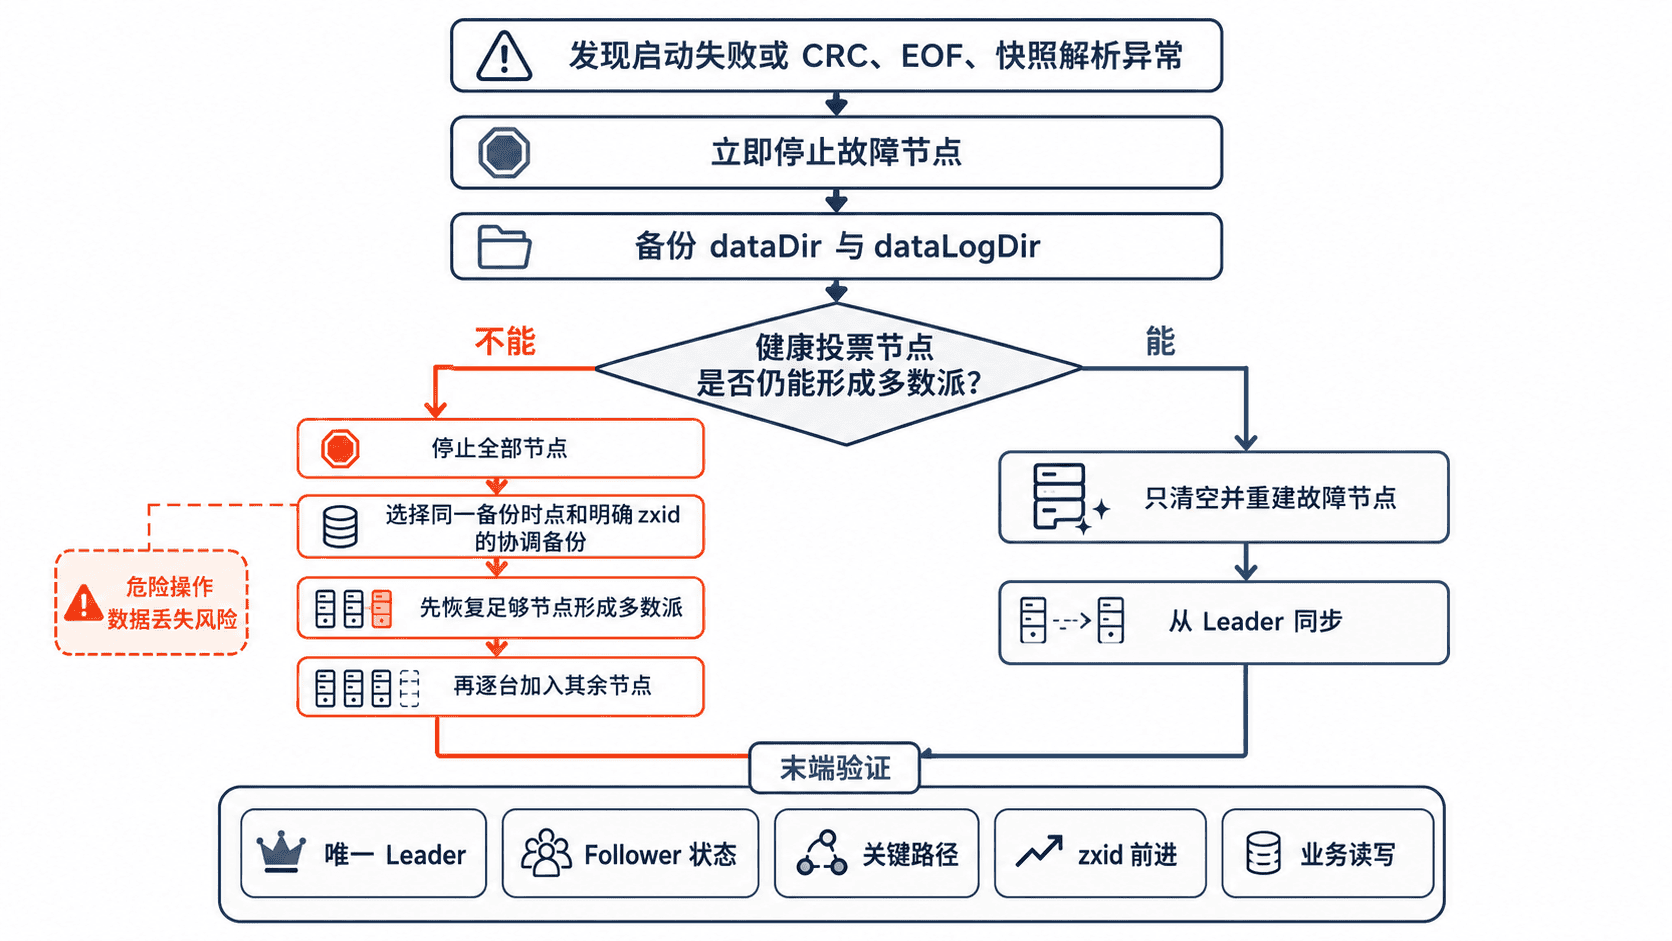
发现损坏后先停止故障节点,完整复制 dataDir 和 dataLogDir,再进行任何删除或修复。不要同时清理多台节点,也不要在进程运行时直接复制数据库文件并把它当作可靠备份。
sudo systemctl stop zookeeper

DATA_DIR=/var/lib/zookeeper
DATA_LOG_DIR=/var/lib/zookeeper-log
BACKUP_DIR=/backup
NODE_ID=zk-1
STAMP=$(date +%Y%m%d-%H%M%S)
ARCHIVE="$BACKUP_DIR/zk-node-${NODE_ID}-${STAMP}.tar.gz"

sudo mkdir -p "$BACKUP_DIR"
sudo tar -czf "$ARCHIVE" "$DATA_DIR" "$DATA_LOG_DIR"
sha256sum "$ARCHIVE"
预期输出
<SHA256> /backup/zk-node-zk-1-<TIME>.tar.gz目录和服务名按实际环境替换。备份文件应保存在故障节点之外,并记录对应节点、配置版本和发现时间。
确认损坏对象
启动日志常见现象包括读取 snapshot 失败、事务日志尾部不完整、CRC 或 EOF 异常、无法找到可用快照。可使用发行包自带工具离线查看具体文件,工具路径和输出格式可能随版本变化。
SNAPSHOT_FILE=/var/lib/zookeeper/version-2/snapshot.<ZXID>
TXN_LOG_FILE=/var/lib/zookeeper-log/version-2/log.<ZXID>

zkSnapShotToolkit.sh "$SNAPSHOT_FILE"
zkTxnLogToolkit.sh "$TXN_LOG_FILE"
预期输出
正常文件:列出 zxid、会话或事务记录
损坏文件:报告解析失败、校验失败或 unexpected end
工具输出只用于确认损坏范围,不能代替恢复策略判断。最重要的问题是:当前是否仍有足够健康投票节点形成多数派并提供可信数据源。
多数派健康时重建单节点
若三节点集群仍有两台健康节点,最安全的做法通常是只重建故障节点。保留 zoo.cfg、动态配置和 myid,将故障数据库目录完整归档后创建空目录,再启动该节点,让它从当前 Leader 同步数据。
不要把某台运行中节点的 version-2 目录直接复制到另一台并立即启动,也不要删除健康节点数据。同步完成后,故障节点应进入 FOLLOWING 或 OBSERVING,而不是持续 LOOKING。
多数派不可用时从备份恢复
若无法形成多数派,恢复必须基于同一备份时点和明确的 zxid 关系。先停止全部节点,选择经过验证的协调备份,恢复到足够数量的节点形成多数派,再逐台加入其余节点。
混合不同时间点的快照和事务日志可能造成数据回退或启动失败。若只有单节点数据可用,应明确可接受的数据丢失窗口,并在恢复前由业务负责人确认,而不是把不确定数据直接推回生产。
恢复后验证
先检查每台节点角色,确认只有一个 Leader,其他投票节点正常跟随;再核对关键路径、配置版本、临时节点恢复行为和客户端错误率。事务 zxid 应持续前进,不能在节点重启后反复回退。
ZK_PORT=2181
HOSTS="zk-1 zk-2 zk-3"

for host in $HOSTS; do
  echo "== $host =="
  printf 'stat\n' | nc "$host" "$ZK_PORT" | grep '^Mode:'
done
预期输出
== zk-1 ==
Mode: leader
== zk-2 ==
Mode: follower
== zk-3 ==
Mode: follower
实际 Leader 所在节点可能不同。随后应执行应用级读写验证,并观察至少一个快照周期,确认新事务日志和快照能够继续正常生成。
本课总结
- 先停止故障节点并完整备份现场,再执行任何清理
- 有健康多数派时优先重建单节点;无多数派时必须使用协调备份
- 恢复成功不仅是进程启动,还要验证角色、zxid、关键路径和业务读写
下一课预告
下一课将按“结果是否确定、能否重试、是否需要补偿”分类诊断常见错误码。