
服务注册与分布式协调 / 系统课时
分布式系统为何需要协调
分布式系统为何需要协调
当同一项工作由多台机器共同完成时,难点往往不在“能否执行”,而在“大家是否对当前状态、负责人和执行顺序达成一致”。本课用配置同步、选主和并发竞争三个典型问题,说明分布式协调服务为什么会出现。
学习目标
- 识别分布式系统中需要协调的典型场景
- 理解“共享状态 + 顺序 + 失效感知”是协调问题的核心
- 区分业务数据存储与协调状态管理的职责
协调问题从哪里来
单机程序中的变量、锁和进程状态都在一个故障域内,操作系统能够给出较稳定的执行顺序。进入分布式环境后,节点之间只能通过网络交换信息,而网络延迟、超时、进程暂停和机器宕机会让“谁先发生”“谁还活着”变得不再显然。
例如三台服务都读取同一份配置。如果每台机器各自维护副本,更新时就可能出现 A 已切到新配置、B 仍使用旧配置、C 暂时无法连接配置源的情况。系统此时需要的不是更多副本,而是一个大家都认可的协调点。
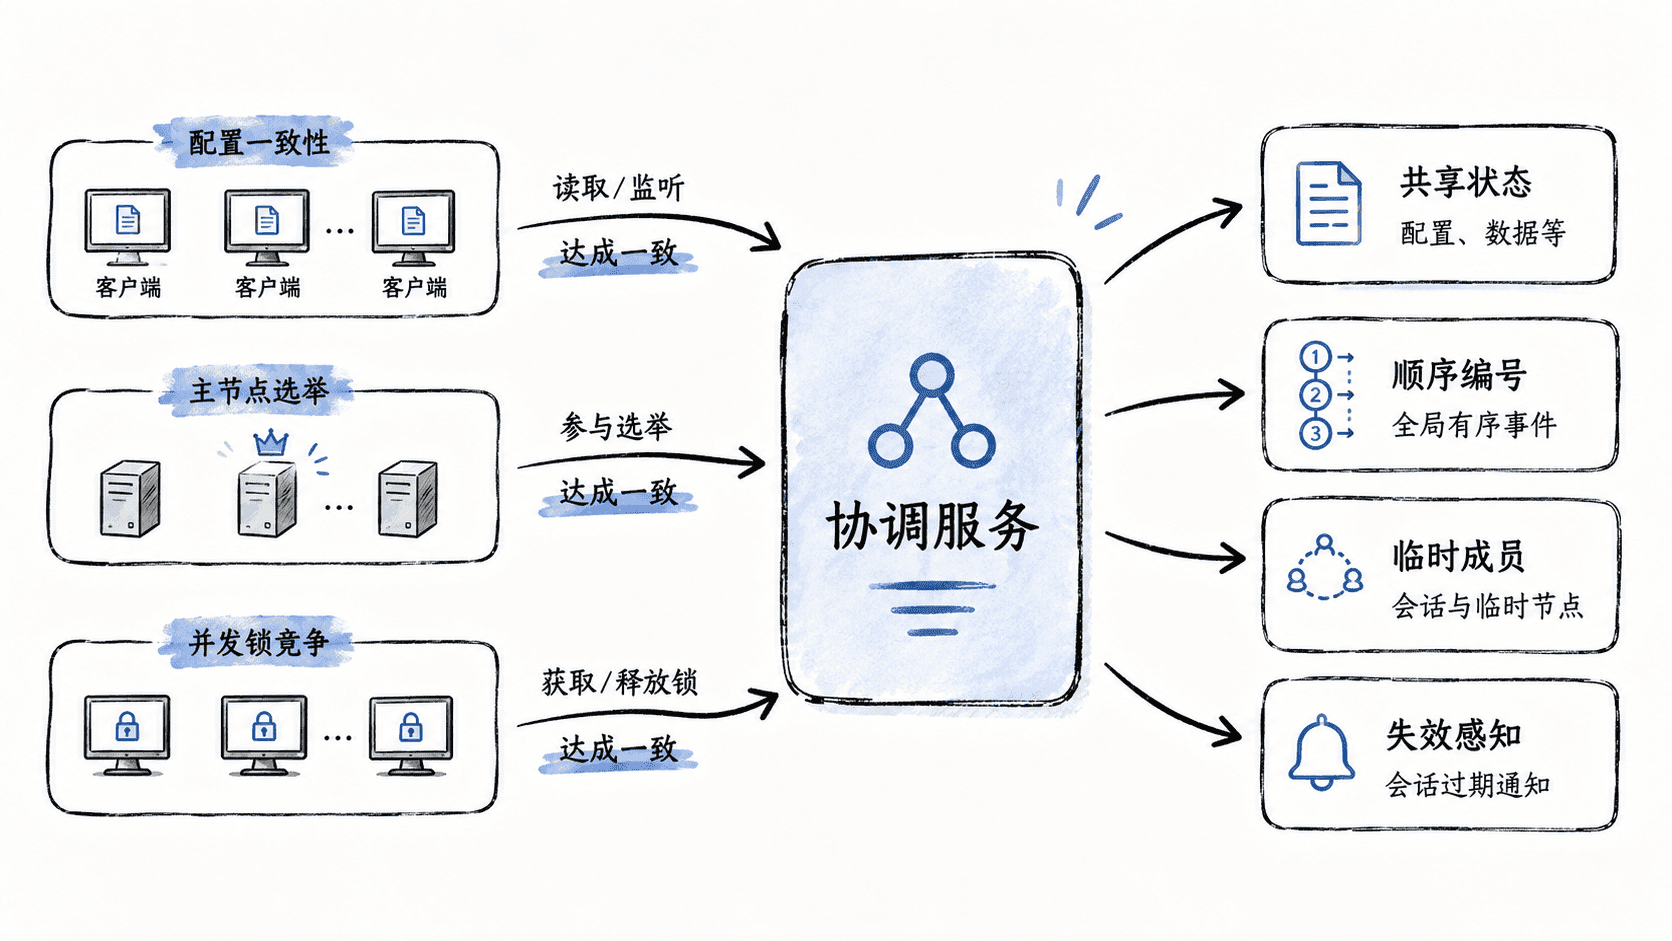
三类最常见的协调需求
配置一致性关注的是“当前有效版本是什么”。多个节点需要读取同一个权威状态,并在状态变化时尽快感知,否则就会出现一部分实例按旧规则处理请求、另一部分按新规则处理请求。
节点选主关注的是“现在谁负责”。集群通常只允许一个节点承担某些单写任务,因此要在候选者之间确定唯一领导者,并在领导者失效后重新选举。
并发竞争关注的是“谁先获得资格”。当多个节点同时争抢一个稀缺资源时,需要可比较的顺序或互斥机制,避免两台机器都认为自己已经拿到锁。
协调服务真正要提供什么
把这三类问题抽象后,会发现它们都依赖少量但关键的能力:保存小规模共享状态、让参与者观察状态变化、给竞争者建立顺序,并能识别某个参与者已经离开。
这些状态与订单、日志、图片等业务数据不同。协调数据通常体量小、变化频率有限,却直接决定“谁能做什么”。因此它更强调一致性和故障语义,而不是大吞吐存储。
下面用一个极简 ZooKeeper CLI 示例感受“大家读取同一个协调状态”的含义。假设已经连接到 zkCli.sh,先创建一个共享节点,再读取它:
create /coord-demo v1
get /coord-demo
预期输出
Created /coord-demo
v1如果节点已存在,create 会失败,这是正常的唯一性保护;实际实验时可以换一个尚未使用的路径。
什么时候应该引入协调机制
当系统需要唯一主节点、分布式锁、成员存活判断、配置版本统一或任务抢占时,就已经进入协调问题的范围。反之,如果只是保存大量业务对象、做全文搜索或承载高吞吐消息流,协调服务并不是合适的主存储。
判断标准可以简化为一句话:当多个独立节点必须对“小而关键的共享状态”形成一致决定时,就需要明确的协调机制,而不能只靠重试和本地判断。