
服务注册与分布式协调 / 系统课时
主节点选举
主节点选举
主节点选举要解决的不是“谁先启动”,而是让多个进程在同一协调路径上竞争唯一领导权,并在当前 Leader 退出或会话失效后自动交接。本课从临时顺序节点的机制出发,再用 Curator LeaderSelector 实现可重复参与的领导者竞争。
学习目标
- 解释临时顺序节点如何形成稳定、公平的选举队列
- 使用
LeaderSelector实现领导权获取、释放与自动重新排队 - 正确处理会话丢失、业务中断与外部副作用
临时顺序节点如何完成选举
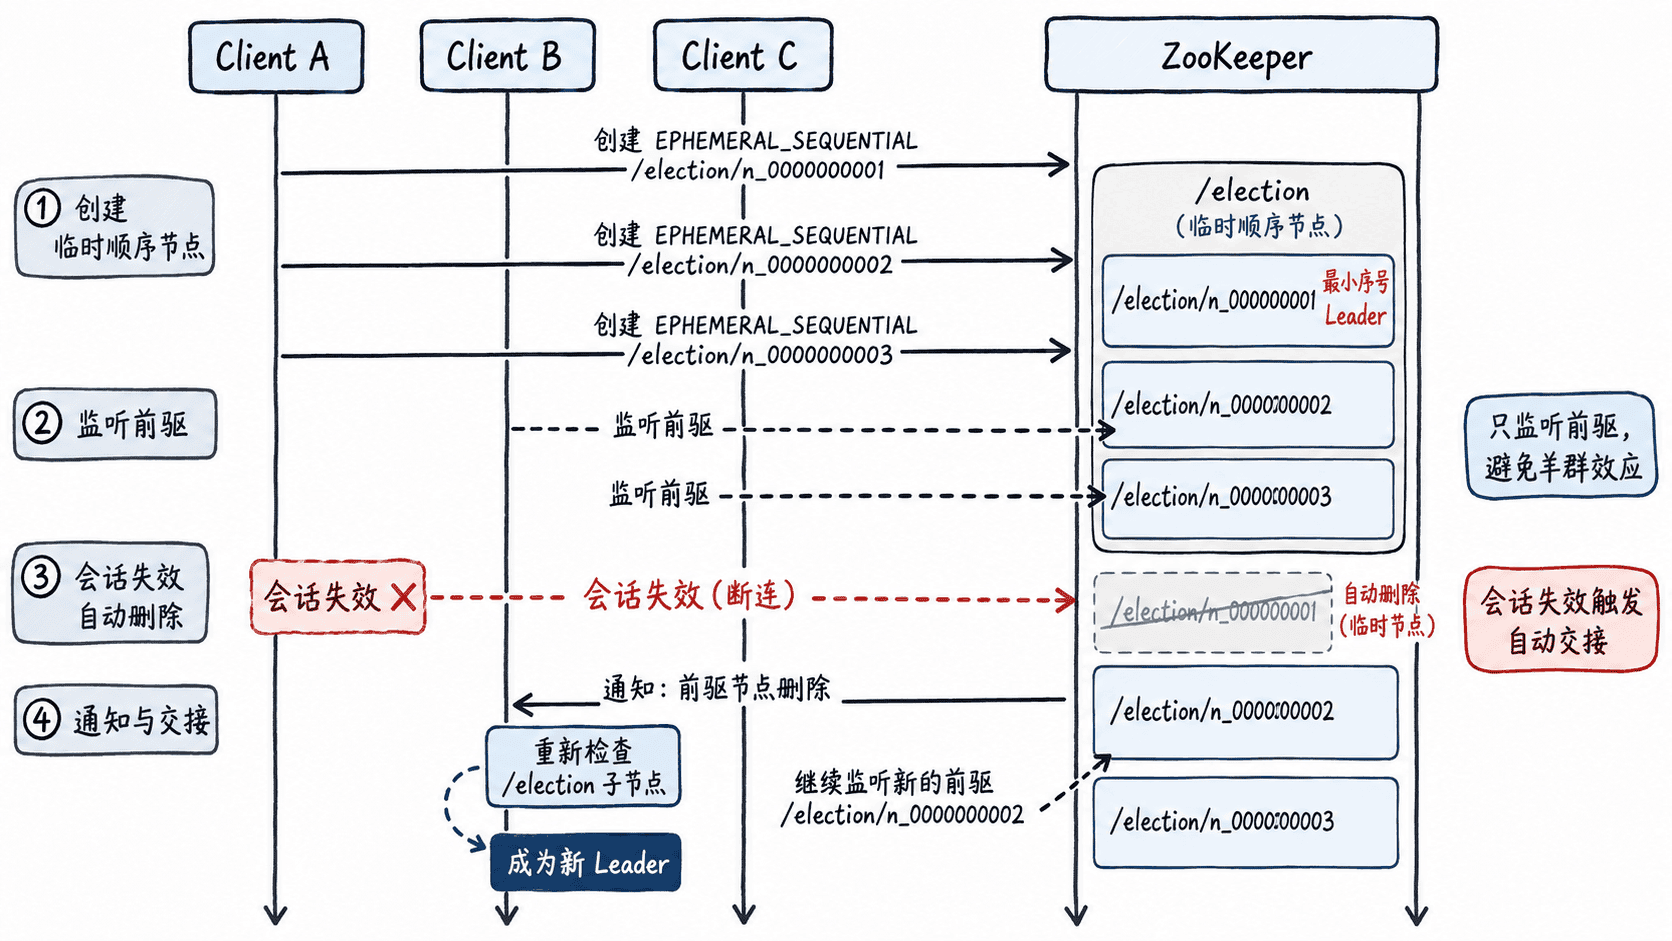
经典做法是在固定父路径下为每个候选者创建 EPHEMERAL_SEQUENTIAL 节点,例如 /election/candidate-0000000012。所有候选者读取子节点并按序号排序,序号最小者成为 Leader;其余候选者只监听自己前一个节点,而不是共同监听 Leader。
这样既利用了临时节点“会话结束即删除”的特性完成故障转移,又避免所有候选者同时被唤醒形成羊群效应。前驱节点消失后,下一名重新检查排序;如果自己已经最小,就接管领导权。
使用 LeaderSelector 实现自动交接
Curator 的 LeaderSelector 封装了选举细节。takeLeadership() 被调用时,当前进程已经获得领导权;该方法一旦返回,就表示主动放弃领导权。调用 autoRequeue() 后,实例在放弃后会重新进入后续选举。
以下示例假设项目已经引入 curator-framework 与 curator-recipes,并使用与目标 ZooKeeper 环境兼容的 Curator 版本。
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;
import org.apache.curator.framework.CuratorFramework;
import org.apache.curator.framework.CuratorFrameworkFactory;
import org.apache.curator.framework.recipes.leader.LeaderSelector;
import org.apache.curator.framework.recipes.leader.LeaderSelectorListenerAdapter;
import org.apache.curator.retry.ExponentialBackoffRetry;

public class LeaderElectionDemo {
    public static void main(String[] args) throws Exception {
        String connectString = args.length > 0 ? args[0] : "127.0.0.1:2181";
        String nodeId = args.length > 1 ? args[1] : "node-a";
        CuratorFramework client = CuratorFrameworkFactory.newClient(
                connectString, new ExponentialBackoffRetry(1000, 3));
        client.start();
        if (!client.blockUntilConnected(10, TimeUnit.SECONDS)) {
            throw new IllegalStateException("ZooKeeper connection timeout");
        }
        LeaderSelector selector = new LeaderSelector(
                client,
                "/demo/leader",
                new LeaderSelectorListenerAdapter() {
                    @Override
                    public void takeLeadership(CuratorFramework ignored) throws Exception {
                        System.out.println(nodeId + " became leader");
                        try {
                            // 用可中断任务模拟 Leader 工作;返回即交还领导权。
                            Thread.sleep(5000);
                        } finally {
                            System.out.println(nodeId + " relinquishes leadership");
                        }
                    }
                });
        selector.setId(nodeId);
        selector.autoRequeue();
        selector.start();
        Runtime.getRuntime().addShutdownHook(new Thread(() -> {
            selector.close();
            client.close();
        }));
        new CountDownLatch(1).await();
    }
}
预期输出
<ID> became leader
<ID> relinquishes leadership
<ID> became leader
<ID> 是实际获得领导权的参与者标识。并发启动多个实例时,谁先成为 Leader 取决于 ZooKeeper 中的竞争顺序;每次 takeLeadership() 返回后,其他参与者都有机会接管。
把故障当成领导权的一部分
主节点选举最危险的错误,是把“曾经成为 Leader”当成持续有效的事实。连接进入 SUSPENDED 时,进程已经不能确定自己仍持有领导权;会话进入 LOST 后,应视为领导权已经失效。领导者执行循环必须能够响应中断,并尽快停止只允许 Leader 执行的任务。
如果 Leader 会修改数据库、对象存储或消息系统,仅靠 ZooKeeper 选举仍不能消除旧 Leader 的迟到写入。对高风险写操作应增加幂等约束、版本检查或 fencing token,让下游能够拒绝过期领导者的请求。
当需求只是保护一个很短的临界区时,分布式锁通常比长期 Leader 更直接;当一个实例需要持续承担调度、分片协调或唯一后台任务时,再使用领导者选举,并把“失去会话后立即停止工作”纳入业务协议。