
服务注册与分布式协调 / 系统课时
队列方案与使用限制
队列方案与使用限制
ZooKeeper 可以用“持久顺序节点 + 临时领取节点”实现低吞吐的协调型队列。本课给出一个可运行的最小实现,并重点说明并发领取、失败恢复、吞吐和消息可靠性边界,避免把 ZooKeeper 当成通用消息队列使用。
学习目标
- 使用持久顺序节点保存队列元素,并按序号确定消费顺序
- 用临时领取节点避免多个消费者同时处理同一元素
- 判断 ZooKeeper 队列在吞吐、数据规模和可靠性上的适用边界
队列的最小模型
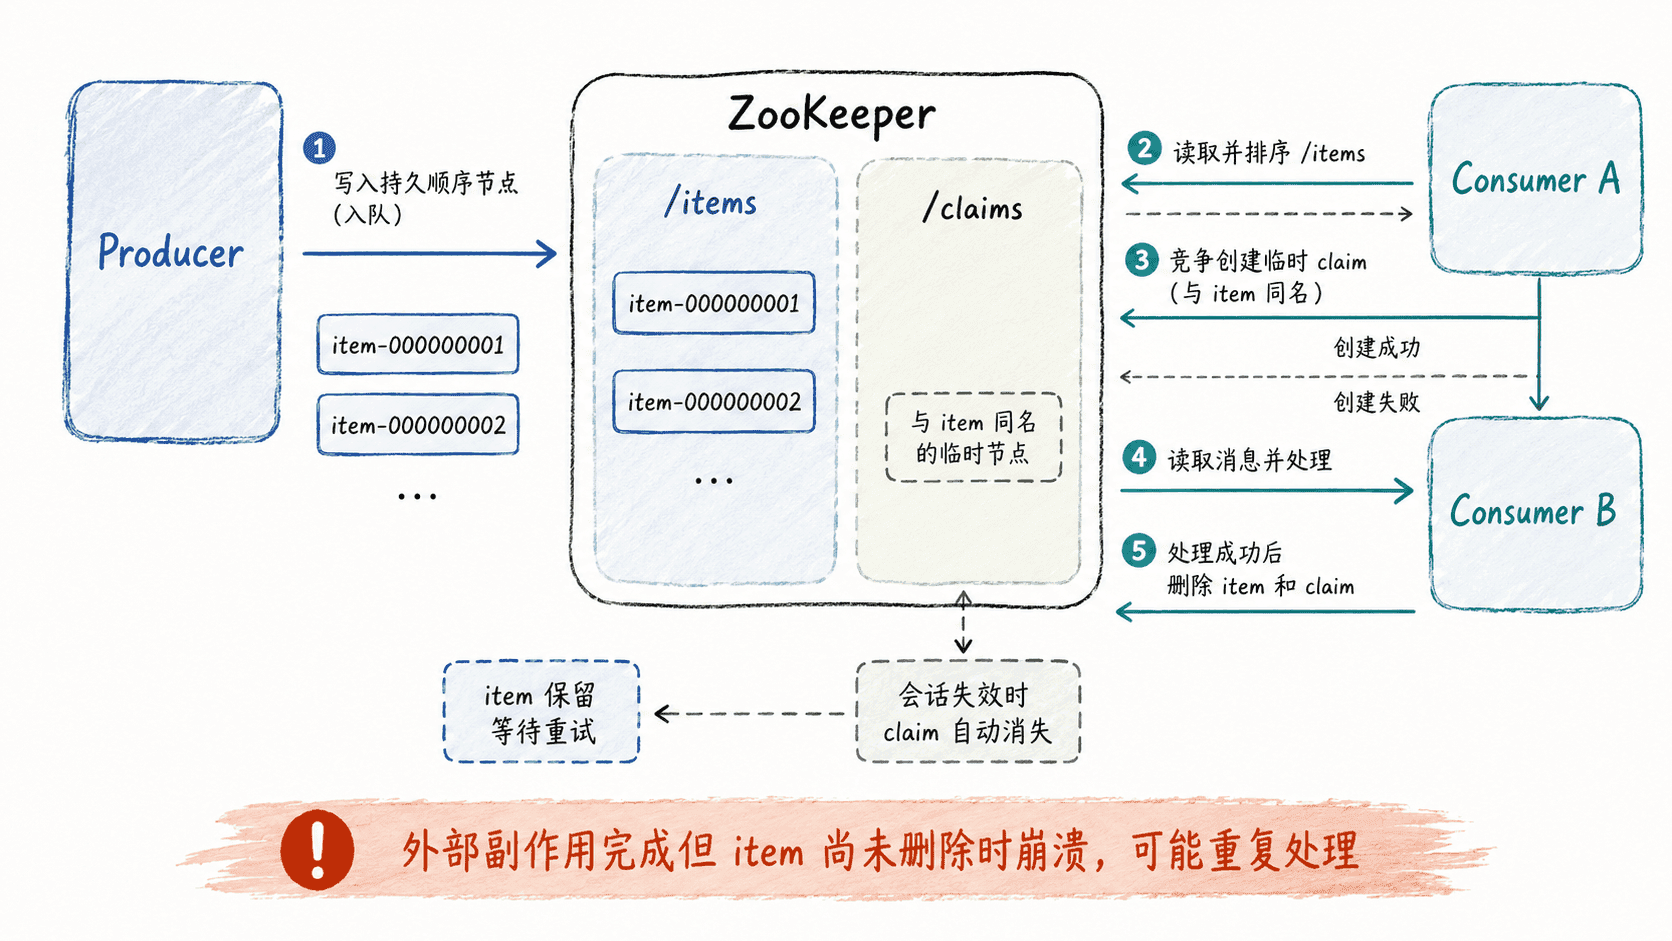
生产者在 /demo-queue/items 下创建 item- 前缀的持久顺序节点,ZooKeeper 会为每个节点追加单调递增序号。消费者读取子节点、按名称排序,再从最小序号开始尝试领取,因此不需要单独维护中心计数器。
为避免多个消费者同时拿到同一个元素,可以在 /demo-queue/claims 下为目标元素创建同名的临时节点。create 本身具有原子性:谁先创建成功,谁获得处理权;其他消费者收到 NodeExists 后继续尝试下一个元素。消费者会话失效后,临时领取节点自动删除,尚未确认的队列元素仍保留。
实现一个可运行的基础队列
下面的 Python 示例依赖 Kazoo 客户端,并假设本机 127.0.0.1:2181 已有可连接的 ZooKeeper。put 创建持久顺序节点,take 用临时节点竞争领取,ack 在业务处理成功后删除队列元素。
from kazoo.client import KazooClient
from kazoo.exceptions import NodeExistsError

class ZkQueue:
    def __init__(self, hosts: str, consumer_id: str, root: str = "/demo-queue"):
        self.zk = KazooClient(hosts=hosts)
        self.zk.start()
        self.consumer_id = consumer_id.encode()
        self.items = f"{root}/items"
        self.claims = f"{root}/claims"
        self.zk.ensure_path(self.items)
        self.zk.ensure_path(self.claims)

    def put(self, payload: bytes) -> str:
        path = self.zk.create(f"{self.items}/item-", payload, sequence=True)
        return path.rsplit("/", 1)[-1]

    def take(self):
        # 顺序节点名称可直接按字典序排序,最小值就是最早入队的候选项。
        for name in sorted(self.zk.get_children(self.items)):
            claim_path = f"{self.claims}/{name}"
            try:
                self.zk.create(claim_path, self.consumer_id, ephemeral=True)
            except NodeExistsError:
                continue

            data, _ = self.zk.get(f"{self.items}/{name}")
            return name, data
        return None

    def ack(self, name: str) -> None:
        # 先删持久消息,再释放 claim;若会话中断,claim 也会自动清理。
        self.zk.delete(f"{self.items}/{name}")
        self.zk.delete(f"{self.claims}/{name}")

    def close(self) -> None:
        self.zk.stop()
        self.zk.close()

if __name__ == "__main__":
    queue = ZkQueue("127.0.0.1:2181", consumer_id="worker-a")
    try:
        print("enqueue:", queue.put(b"order-A"))
        print("enqueue:", queue.put(b"order-B"))

        for _ in range(2):
            item = queue.take()
            if item is None:
                break
            name, data = item
            print("consume:", name, "->", data.decode())
            queue.ack(name)
    finally:
        queue.close()
预期输出如下。顺序号属于动态值,实际环境中的数字可能不同。
enqueue: item-<ID1>
enqueue: item-<ID2>
consume: item-<ID1> -> order-A
consume: item-<ID2> -> order-B
并发与可靠性边界
临时领取节点解决的是“同一时刻只有一个存活会话持有处理权”,并不自动提供消息系统里的确认、重试、死信和消费位点。若消费者完成外部副作用后、删除持久消息前崩溃,领取节点会在会话过期后消失,其他消费者会再次处理该元素,因此业务处理必须具备幂等性。生产者在创建顺序节点时若遇到连接丢失,还可能无法立即判断“创建到底有没有成功”,盲目重试会造成重复入队。
如果多个消费者都只等待最小序号元素,能够保持严格的开始顺序,但并发度很低;若领取失败后继续尝试后续元素,可以并行处理,但完成顺序不再严格等于入队顺序。队列语义必须在“严格顺序”和“并行吞吐”之间明确取舍。
什么时候不该用 ZooKeeper 做队列
ZooKeeper 的写请求需要由集群形成一致顺序,吞吐能力不适合与专用消息系统按分区水平扩展;大量子节点还会放大 getChildren、Watch 通知和客户端排序成本。单个 znode 的数据也应保持很小,传统默认配置常见约 1 MiB 级别的请求/序列化上限,具体值取决于版本与 jute.maxbuffer 等配置,不适合承载大消息。
更关键的是,Watch 只是状态变化通知,不是可持久重放的消息日志;ZooKeeper 也不原生提供消费者组位点、延迟重试、死信队列、批量拉取或端到端恰好一次语义。因此它更适合低频任务分配、主从选举后的工作领取等协调场景。高吞吐消息、长期积压或复杂投递语义应交给 Kafka、RabbitMQ、Pulsar 等消息系统。