
服务注册与分布式协调 / 系统课时
节点数据设计
节点数据设计
本课解决 ZooKeeper 路径混乱、节点过大和子节点失控的问题。你将把业务数据拆成稳定层级,选择可演进的序列化格式,并建立数据大小与节点数量的设计边界。
学习目标
- 按业务域、资源类型和实例组织路径
- 设计小而可演进的节点数据
- 控制热点路径和子节点规模
坚持小数据原则
ZooKeeper 的优势是协调数据的低延迟读取、版本控制与监听,而不是保存大对象。配置、选主标记、服务地址和状态摘要适合放入节点;文件、日志、订单明细和大段文档应存入数据库或对象存储,只在节点中保存引用。
工程上应主动把单节点数据控制在较小范围,例如几 KB 到几十 KB,而不是逼近请求缓冲区上限。数据越大,网络传输、快照、事务日志和 Watch 后的重复读取成本越高。
设计稳定的路径层级
推荐先按应用或租户隔离,再按资源类型分层,最后使用稳定标识作为叶子节点。
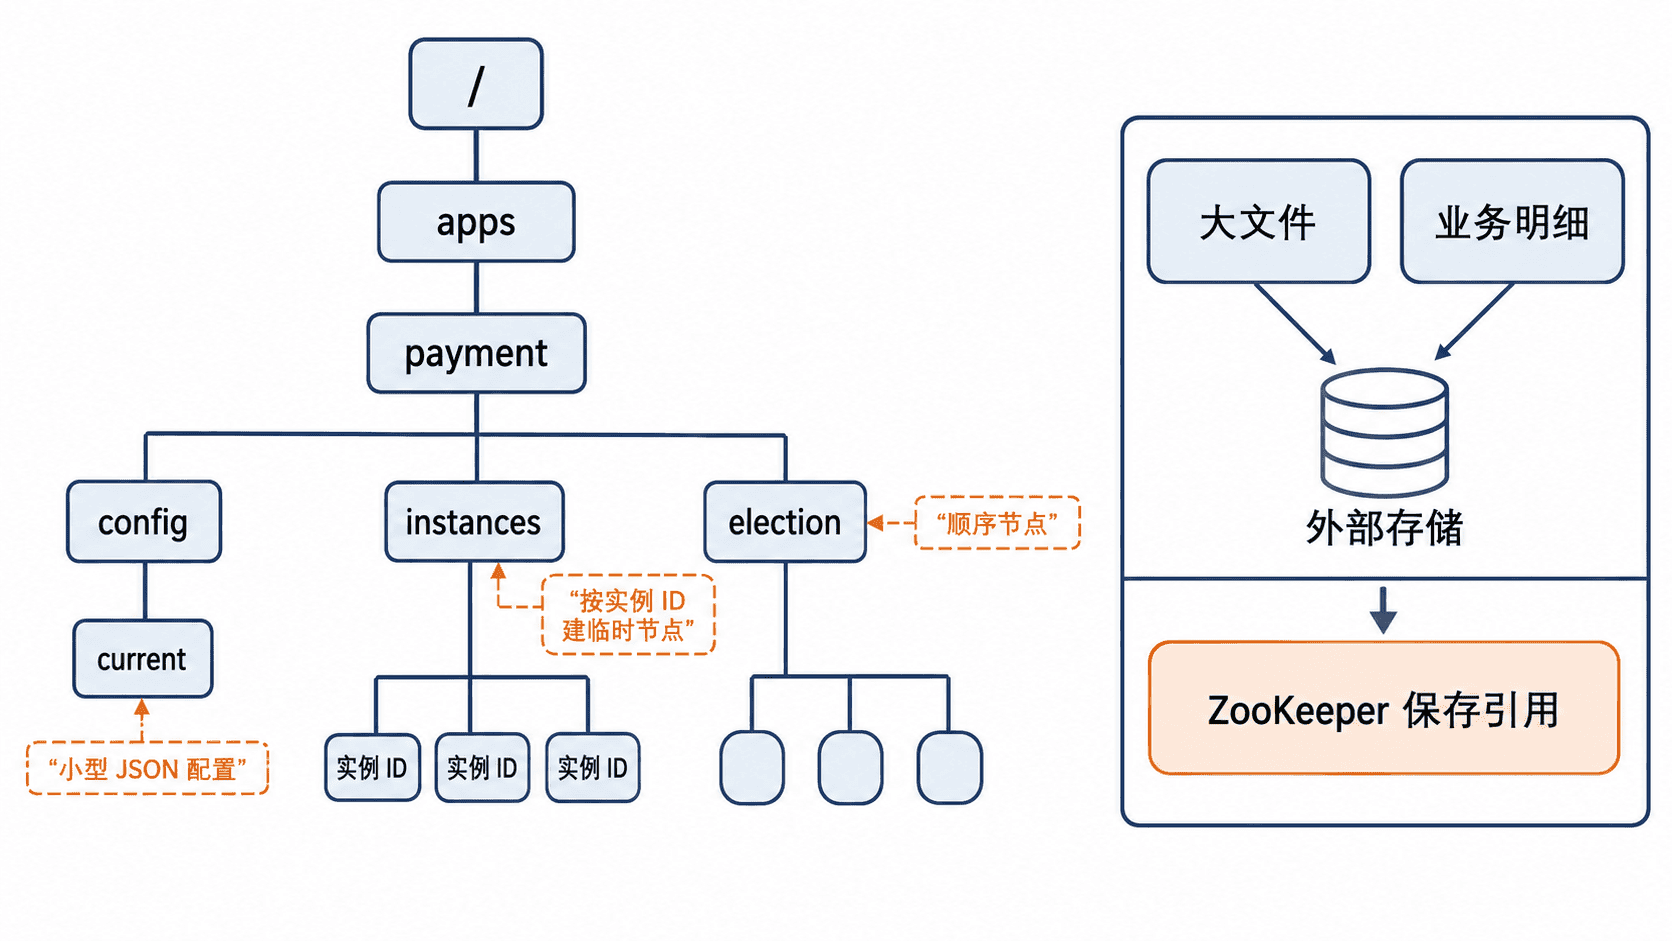
/apps/payment/config/current
/apps/payment/instances/<INSTANCE_ID>
/apps/payment/election/candidate-
/apps/payment/locks/order/<ORDER_ID>
路径名应表达资源含义,不要把频繁变化的数据编码进路径。环境隔离可使用 /dev、/test、/prod 顶层目录或 Chroot,但同一规则应在团队内保持一致。
选择可演进的数据格式
JSON 便于排查,适合小型配置;Protocol Buffers 等二进制格式更紧凑,适合字段较多且有明确协议的场景。无论选择哪种格式,都应包含模式版本,并为新增字段准备兼容默认值。
{
  "schemaVersion": 2,
  "endpoint": "https://api.example.internal",
  "timeoutMs": 5000,
  "enabled": true
}
该结构生效后,旧客户端应忽略未知字段,新客户端应能识别旧版本并补充默认值。不要依赖 JSON 字段顺序,也不要把密钥明文存入开放 ACL 节点。
控制节点数量与热点
一个父节点拥有大量直接子节点时,getChildren 返回列表会变大,子节点变化也会集中触发监听。可按哈希前缀、日期或业务分区拆分,但不要创建过深且难以运维的树。
高频计数器也不适合集中写入单个节点。ZooKeeper 写请求需要集群排序与复制,热点节点会放大冲突和延迟。可将统计写入专用存储,只把协调所需的最终状态放在 ZooKeeper。
可用管理客户端抽查节点数据与统计信息,确认数据长度和直接子节点数量没有越过团队设定的阈值。
zkCli.sh -server zk1.example.internal:2181 get -s /apps/payment/config/current预期结果:输出包含当前配置,并能看到节点统计信息;具体字节数和版本号取决于实际数据。
<CURRENT_JSON>
dataLength = <BYTES>
numChildren = <COUNT>
上线前还应检查更新频率、ACL 和清理策略。临时节点会随会话清理,持久节点与顺序节点则需要明确归档或删除机制。
本课总结
- ZooKeeper 节点应保存小型协调数据,而不是大对象和业务明细
- 路径要稳定分层,数据格式要带版本并兼容演进
- 大量子节点和高频写入应通过分区或外部存储消除热点
下一课预告
下一章进入会话机制,首先区分底层 TCP 连接与跨服务器保持的 ZooKeeper 会话。