
服务注册与分布式协调 / 系统课时
容量规划
容量规划
本课给出一套可落地的 ZooKeeper 容量估算方法。你将把 ZNode 数量、平均数据大小、Watch、连接数和写入速率换算为内存、磁盘与吞吐预算,并通过压测校准估算,避免只按服务器核数拍脑袋扩容。
学习目标
- 识别影响内存、磁盘和吞吐的主要变量
- 使用估算公式得到初始容量区间
- 通过基线压测和增长率修正规划结果
先明确 ZooKeeper 的容量特征
ZooKeeper 的数据树会复制到每个服务节点内存中,增加投票节点不会把 ZNode 数据分片。扩容节点主要提升容错能力和读连接承载,同时会增加写事务复制成本,因此不能把“节点越多”理解为“写吞吐越高”。
容量规划至少分为三部分:内存保存数据树、Watch、会话和连接;磁盘保存事务日志、快照与备份;CPU、网络和日志设备承担请求处理与多数派复制。
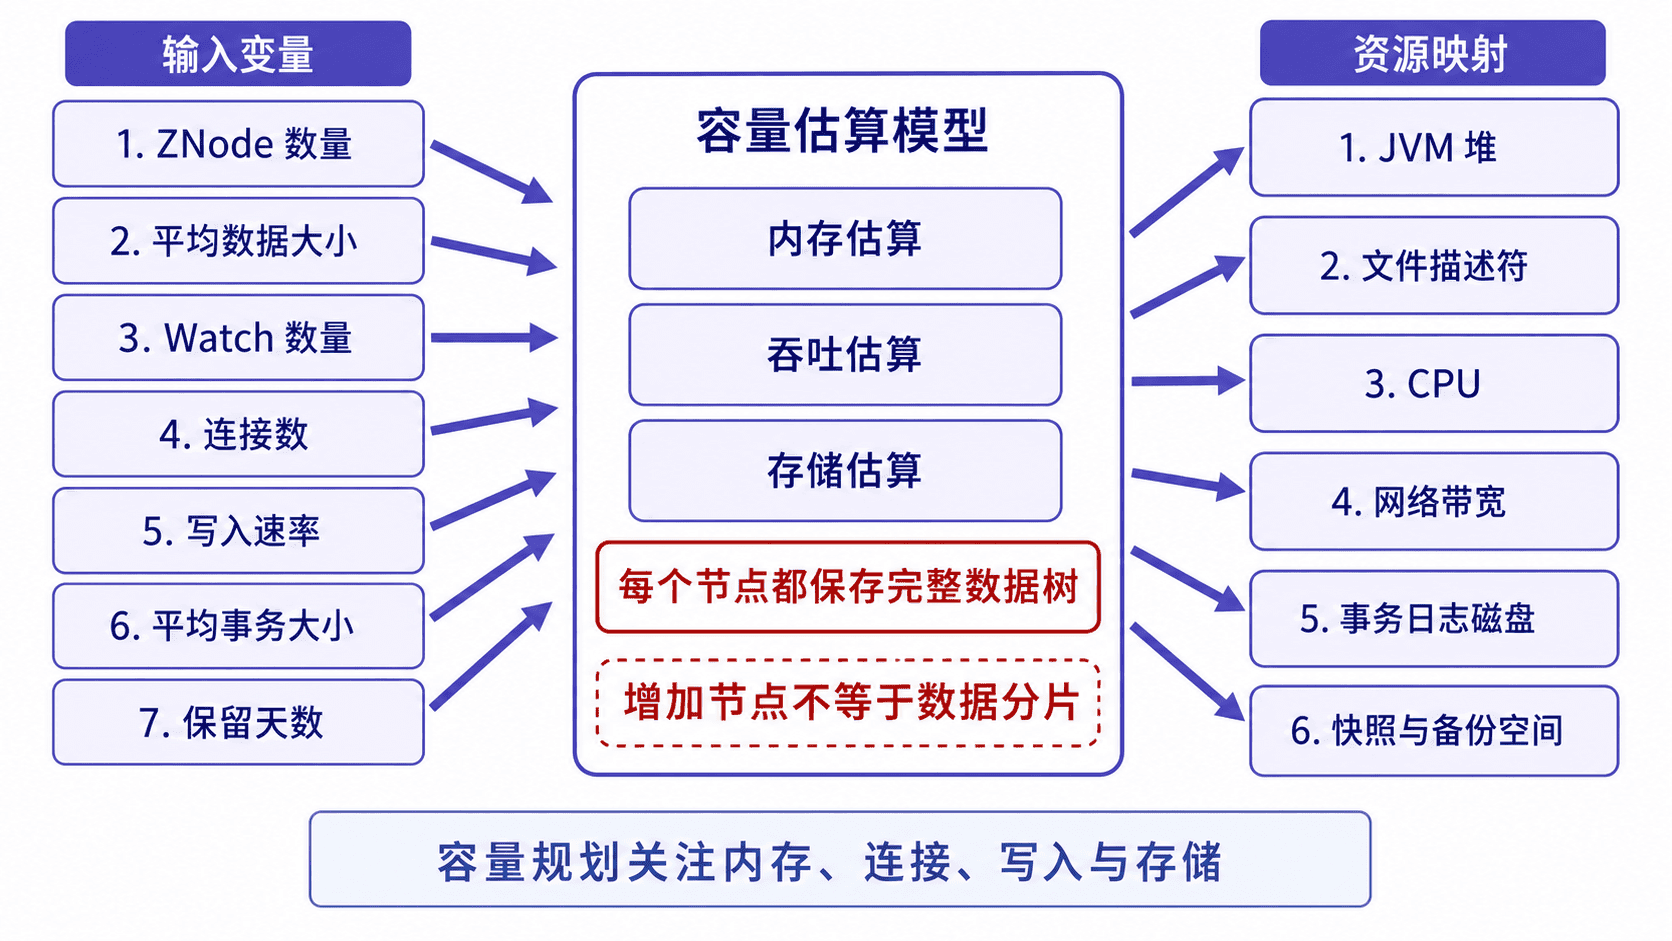
建立初始估算模型
可先用下面的经验模型得到数量级,再用真实数据修正。示例中的放大系数不是官方固定值,只是为对象、索引、序列化、会话结构和安全余量预留空间。
下面脚本按 200 万个节点、500 万个 Watch、5 万连接和每秒 2000 次写入计算初始预算。
nodes = 2_000_000
avg_node_bytes = 300
watches = 5_000_000
connections = 50_000
writes_per_sec = 2_000
avg_txn_bytes = 500
retention_days = 7

data_bytes = nodes * avg_node_bytes
heap_bytes = (
    data_bytes * 2.5
    + watches * 200
    + connections * 50 * 1024
) * 1.3
txn_disk_bytes = (
    writes_per_sec
    * avg_txn_bytes
    * 86400
    * retention_days
    * 1.5
)

gib = 1024 ** 3
print(f"原始数据约 {data_bytes / gib:.2f} GiB")
print(f"建议堆预算至少 {heap_bytes / gib:.2f} GiB")
print(f"7 天事务日志预算约 {txn_disk_bytes / gib:.2f} GiB")
预期输出如下。实际生产还要加上快照副本、文件预分配、日志滚动、操作系统和备份空间。
原始数据约 0.56 GiB
建议堆预算至少 6.13 GiB
7 天事务日志预算约 844.90 GiB
分别校准五个变量
节点数量和平均数据大小决定数据树主体。不要只统计业务值长度,还应采样路径长度、ACL、Stat 信息和子节点结构。大节点和超宽目录会放大序列化、网络与客户端处理成本。
Watch 数量通常比 ZNode 数量更容易被低估,因为同一路径可能被大量会话监听。连接数还会消耗线程、缓冲区、文件描述符和会话表空间,应按峰值而不是日均值规划。
写入速率决定 leader、事务日志设备和网络复制压力。容量测试必须同时观察 P95/P99 延迟、未完成请求、fsync 时间和 GC,而不能只看每秒成功请求数。
节点规模与余量
常见生产集群使用 3 或 5 个投票节点。3 节点可容忍 1 个故障,5 节点可容忍 2 个故障;偶数投票节点通常不会比相邻较小奇数集群提供更多故障容忍能力,却增加复制成本。
建议至少保留 30%~50% 的堆、连接、磁盘和写吞吐余量,并按未来增长率计算扩容提前量。若单集群数据树已接近堆上限,应优先减少不适合存入 ZooKeeper 的大数据或拆分业务命名空间,而不是只增加节点。
验收方式
在与生产相近的磁盘和网络上导入代表性数据,按峰值连接、Watch 和写入速率持续压测至少一个业务高峰周期。验收标准应同时包含延迟、GC、磁盘同步、节点重启恢复时间和 follower 追赶时间。
本课总结
- 每个 ZooKeeper 节点保存完整数据树,增加节点不会分摊数据内存
- 容量必须同时估算数据、Watch、连接、写入日志和备份空间
- 经验公式只能给出起点,最终结果必须通过真实负载压测校准
下一课预告
下一课将制定快照与事务日志备份方案,并在隔离环境中完成一次可验证的恢复演练。