
服务注册与分布式协调 / 系统课时
选主与任务互斥
选主与任务互斥
多个实例同时具备定时任务能力时,仅做选主或仅加锁都容易留下边界问题。本节把领导者选举、任务级互斥和完成标记组合起来,让正常情况下只有一个实例执行同一批次任务,并明确会话失效时的安全边界。
学习目标
- 理解领导者选举、分布式锁和完成标记分别解决什么问题。
- 使用 ZooKeeper 协调多个实例竞争同一个批次任务。
- 正确处理会话丢失、重复执行和非幂等副作用等生产边界。
把三层职责分开
领导者选举解决“当前由谁负责调度”;分布式锁解决“同一时刻谁能进入任务临界区”;完成标记解决“这个逻辑批次是否已经成功执行”。三者不是重复设计,而是在故障切换期间分别限制不同类型的重复。
| 机制 | 解决的问题 | 不负责解决 |
|---|---|---|
| 领导者选举 | 选出当前协调实例 | 某个具体任务是否已完成 |
| 分布式锁 | 同一时刻只允许一个持有者进入临界区 | 成功后再次触发 |
| 完成标记 | 记录某个 runKey 已成功 |
会话失效后的陈旧进程副作用 |
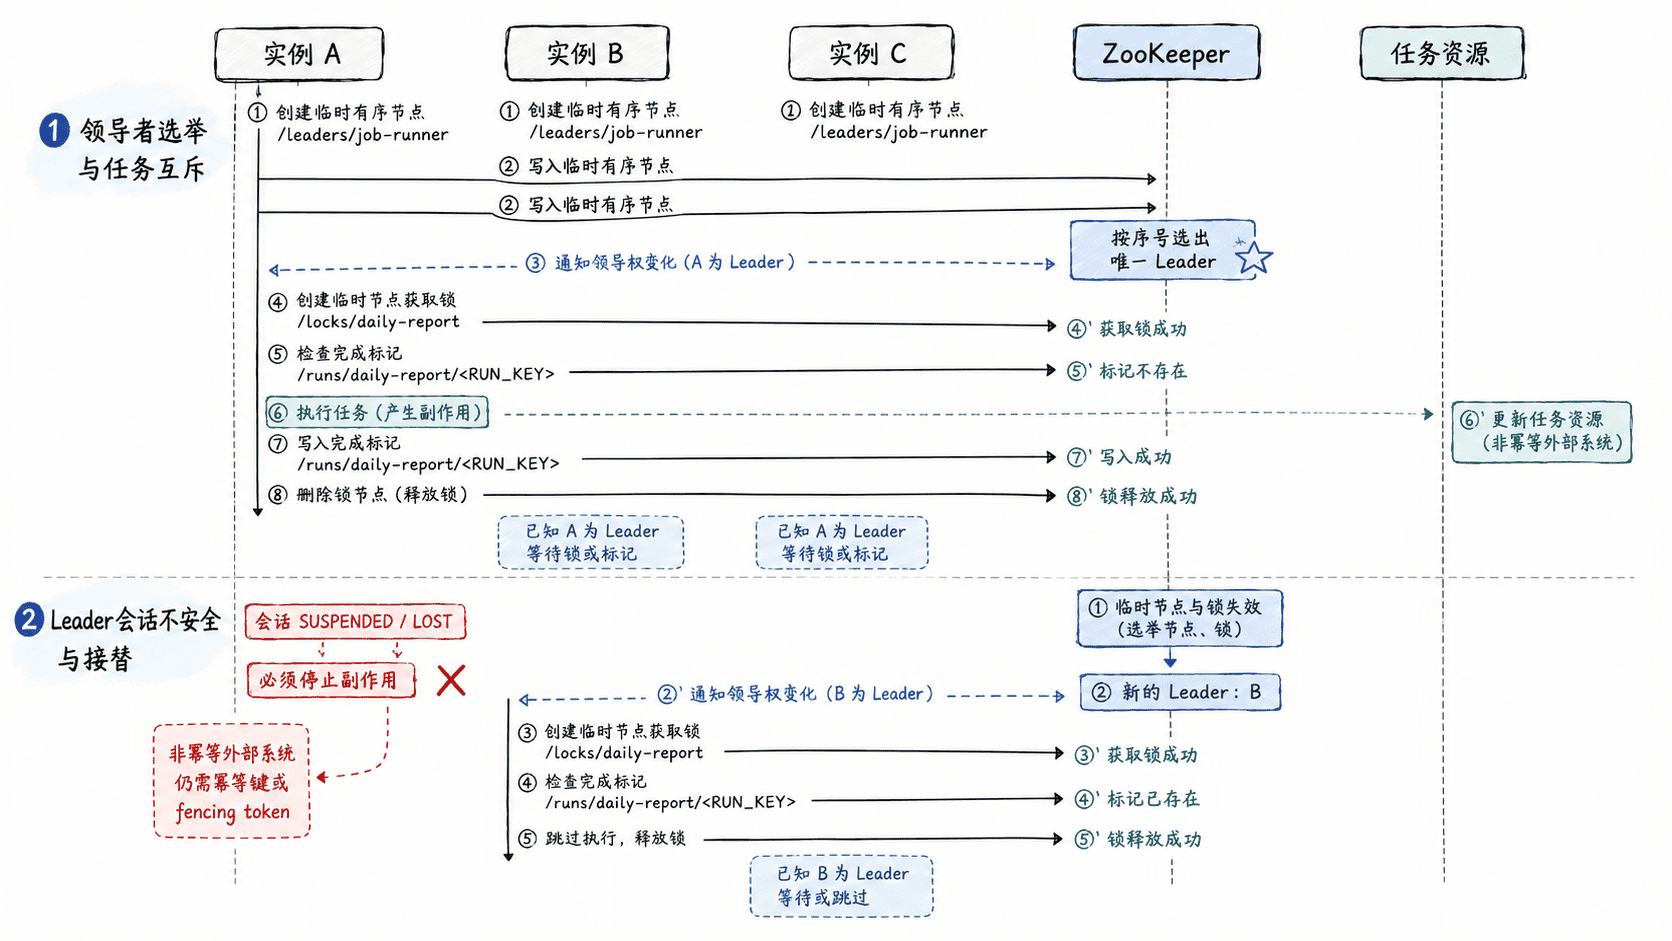
这种组合适合“每个实例都能接管调度,但同一日任务只能成功一次”的场景。选主减少无意义竞争,任务锁保护临界区,完成标记让后继 Leader 能判断是否需要补跑。
实现一个可复现的批次任务
下面使用 Python 的 Kazoo 客户端演示。前提是三个进程连接到同一 ZooKeeper 集群,并已安装 kazoo。程序把 runKey 当作逻辑批次号,例如业务日期;第一个获得领导权的实例进入任务锁并写完成标记,后续接任者看到标记后跳过。
import sys
import threading
import time

from kazoo.client import KazooClient
from kazoo.protocol.states import KazooState

if len(sys.argv) != 4:
    raise SystemExit("usage: python leader_job.py <zk_hosts> <instance_id> <run_key>")

zk_hosts, instance_id, run_key = sys.argv[1:4]
unsafe_session = threading.Event()

zk = KazooClient(hosts=zk_hosts)

def on_state_change(state):
    # 一旦会话进入不安全状态,本批任务不再继续产生副作用。
    if state in (KazooState.SUSPENDED, KazooState.LOST):
        unsafe_session.set()

zk.add_listener(on_state_change)
zk.start()

marker_path = f"/runs/daily-report/{run_key}"
task_lock = zk.Lock("/locks/daily-report", identifier=instance_id)
election = zk.Election("/leaders/job-runner", identifier=instance_id)

def run_as_leader():
    if unsafe_session.is_set():
        print(f"{instance_id}: abort, ZooKeeper session is unsafe")
        return

    with task_lock:
        # 锁内先查完成标记,避免故障切换后再次执行已成功的批次。
        if zk.exists(marker_path):
            print(f"{instance_id}: skip {run_key}, already completed")
            return

        print(f"{instance_id}: running {run_key}")
        time.sleep(2)

        if unsafe_session.is_set():
            print(f"{instance_id}: abort before completion marker")
            return

        zk.create(marker_path, instance_id.encode(), makepath=True)
        print(f"{instance_id}: completed {run_key}")

try:
    election.run(run_as_leader)
finally:
    zk.stop()
    zk.close()
预期结果:
保存为 leader_job.py 后不会自行产生输出;按下一节传入 ZooKeeper 地址、实例 ID 和 runKey 运行后,进程会参与选举并输出执行或跳过结果。这里的 Election 和 Lock 都依赖 ZooKeeper 会话。完成标记是持久节点,因此任务成功后,即使 Leader 退出并由其他实例接任,后继实例仍能识别该 runKey 已完成。
同时启动三个实例验证互斥
把脚本保存为 leader_job.py,然后同时启动三个实例。示例连接地址按实验环境填写。
python leader_job.py 127.0.0.1:2181 node-a 2026-09-02 &
python leader_job.py 127.0.0.1:2181 node-b 2026-09-02 &
python leader_job.py 127.0.0.1:2181 node-c 2026-09-02 &
wait
预期输出形态如下,实际首先当选的实例顺序可能不同:
<LEADER_ID>: running 2026-09-02
<LEADER_ID>: completed 2026-09-02
<FOLLOWER_ID_1>: skip 2026-09-02, already completed
<FOLLOWER_ID_2>: skip 2026-09-02, already completed
关键验收点不是哪一个节点获胜,而是同一个 runKey 只出现一次 running 和一次 completed。再次用相同 runKey 启动任意实例时,应直接命中完成标记并跳过;换成新的 runKey 才会形成新的批次。
故障切换时不要过度承诺
ZooKeeper 能协调“谁当前持有领导权和锁”,但不能单独保证任意外部系统上的严格 exactly-once。进程可能在完成外部写入后、写完成标记前崩溃,也可能因长时间停顿错过会话后短暂继续运行。
生产实现还应监听连接状态,在 SUSPENDED 或 LOST 后停止启动新工作,并让长任务在安全检查点主动退出。任务本身应以 runKey 作为幂等维度,这样 Leader 切换后可以安全重试,而不是依赖进程身份判断是否执行过。
用职责边界判断是否设计正确
一个可靠的执行链应满足:只有 Leader 负责触发任务;进入具体任务前还要获取该任务对应的互斥锁;锁内先检查持久完成标记;任务成功后再写标记;会话不安全时停止副作用。若业务无法容忍重复写,还必须把幂等或 fencing 能力下沉到真正承载副作用的系统中。
这样设计后,领导者选举负责“谁来组织”,分布式锁负责“此刻谁能执行”,完成标记负责“这一批是否已成功”,三层信号互不替代,故障切换时也能清楚判断下一实例应该继续、跳过还是终止。