
服务注册与分布式协调 / 系统课时
请求延迟升高
请求延迟升高
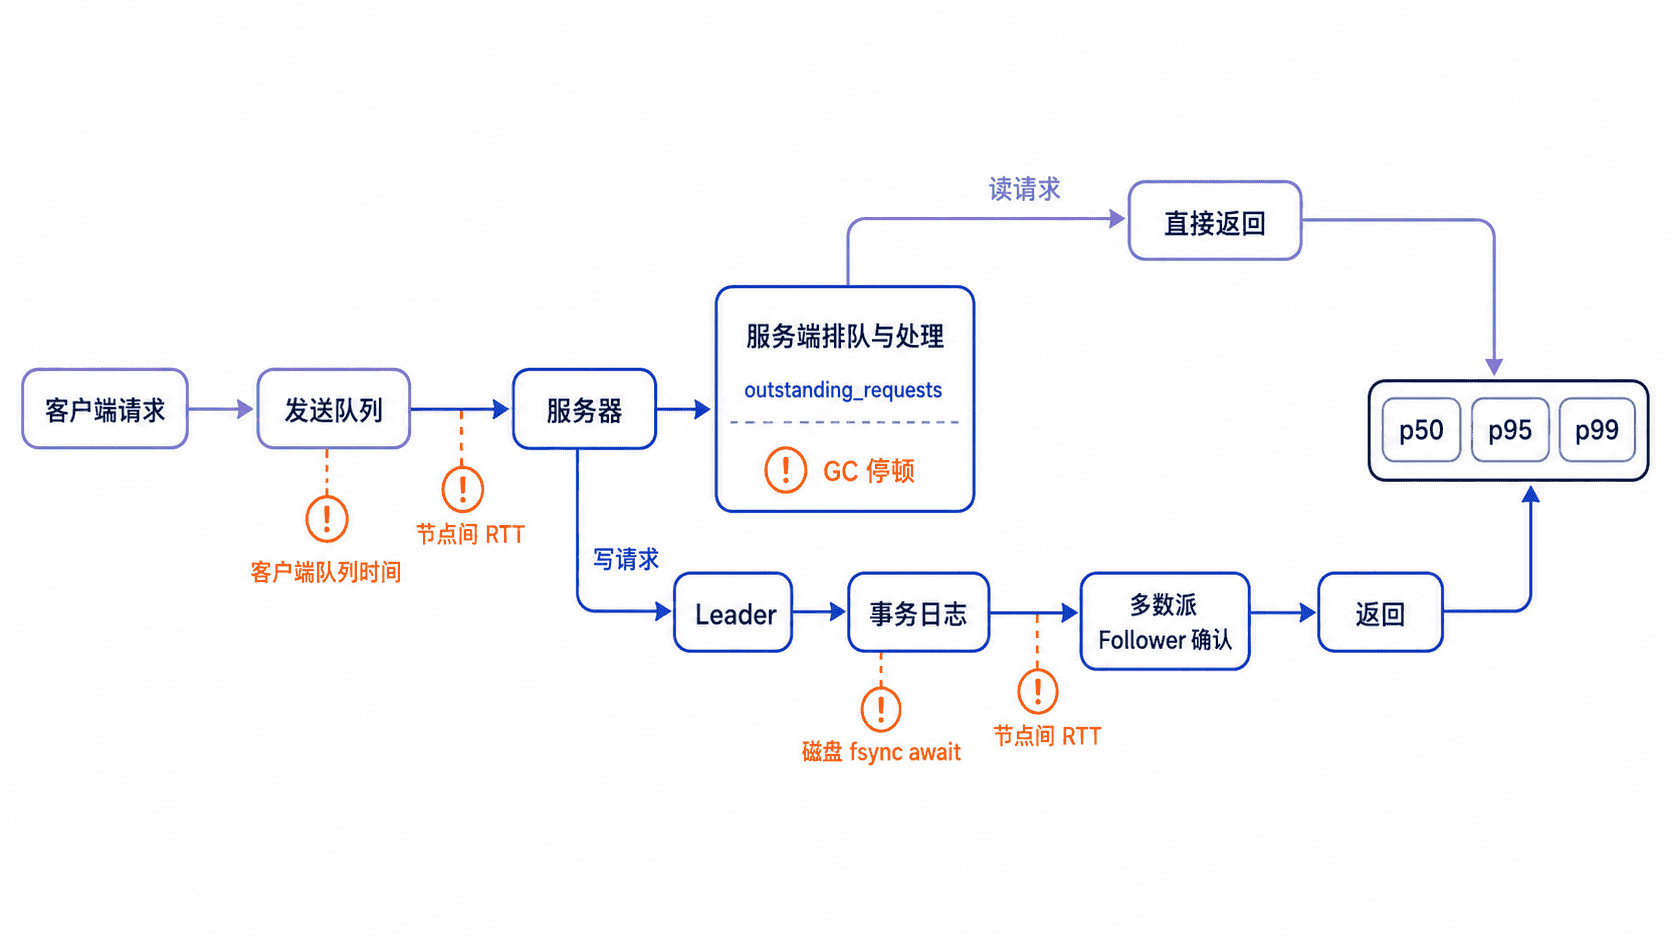
本课解决 ZooKeeper 请求平均延迟或长尾延迟突然升高的问题。你将把一次请求拆成客户端排队、服务端处理、磁盘同步和多数派通信四段,并用运行指标交叉验证瓶颈位置。
学习目标
- 识别读请求与写请求的不同延迟路径
- 使用服务端和系统指标定位排队、磁盘或通信瓶颈
- 建立修复前后可量化的延迟验证方法
先区分读慢还是写慢
本地读通常由所连接的服务器直接处理,而写请求需要转交 Leader、写事务日志并等待多数派确认。只有写慢时,应优先检查 Leader 磁盘和节点间通信;读写都慢时,还要检查客户端排队、服务端线程调度、GC 和热点访问。
应用侧应分别记录操作类型、路径、返回码和耗时分位数。只看全局平均值会掩盖少量极慢请求,也无法判断延迟集中在哪类操作。
读取服务端基线指标
mntr 四字命令可以快速查看延迟和积压。生产环境通常需要在 4lw.commands.whitelist 中显式允许 mntr,并通过网络策略限制访问来源。
ZK_HOST=127.0.0.1
ZK_PORT=2181

printf 'mntr\n' | nc "$ZK_HOST" "$ZK_PORT" | grep -E "zk_(avg_latency|max_latency|outstanding_requests|num_alive_connections|znode_count)"
预期输出
zk_avg_latency <MILLISECONDS>
zk_max_latency <MILLISECONDS>
zk_outstanding_requests <COUNT>
zk_num_alive_connections <COUNT>
zk_znode_count <COUNT>
若 outstanding_requests 持续增长,说明请求进入速度超过处理速度;若 max_latency 很高而平均值正常,说明存在长尾停顿。单次采样只能描述瞬时状态,应连续采集并与应用侧 p95、p99 对齐。
沿写请求链路继续下钻
当写请求明显变慢时,先在 Leader 上检查事务日志所在磁盘。磁盘吞吐未满不代表没有问题,fsync 更受 await、队列和偶发停顿影响。虚拟化存储、共享云盘、快照任务和同盘日志归档都可能制造长尾。
多数派通信也会放大延迟。三节点集群只要 Leader 加一个 Follower 较快即可提交,但若可及时确认的 Follower 网络抖动,写延迟就会同步升高。应比较节点间 RTT、重传和连接重建,并确认仲裁流量没有绕到不稳定链路。
iostat -x 1 5预期输出
Device  r/s  w/s  await  aqu-sz  %util
<DEVICE> <VALUES>
如果延迟尖峰与 await 或队列长度同步上升,应优先处理存储;若磁盘稳定但写延迟随节点间 RTT 上升,则转向网络和仲裁节点排查。
检查客户端与使用方式
客户端连接数过多、请求无界并发、在回调线程中执行慢逻辑,都会制造客户端侧等待。Watch 回调应只触发轻量刷新,不应直接执行远程调用或大规模反序列化。
还要排查热点路径,例如高频 getChildren 返回超大子节点列表,或反复读取大数据节点。ZooKeeper 适合保存小型协调数据,不适合承载业务明细、大文件或高频全量扫描。
修复与回归验证
修复动作应对应瓶颈:限制并发和队列、拆分热点路径、把事务日志迁移到低延迟磁盘、消除节点间抖动、为进程预留 CPU,并减少无意义的同步写入。
回归时保持相同请求模型,分别比较读写吞吐、p50、p95、p99、错误率和 outstanding_requests。只有长尾下降且积压不再持续增长,才能说明瓶颈真正解除。
本课总结
- 读请求与写请求路径不同,必须分开统计和定位
outstanding_requests、磁盘await与节点间 RTT 能帮助确定瓶颈层- 修复结果要用相同负载下的分位数和积压趋势验证
下一课预告
下一课将分析节点数量、子节点列表和 Watch 数量过大时的内存、网络与回调压力,并给出拆分和治理方法。