
服务注册与分布式协调 / 系统课时
集群规模与节点规划
集群规模与节点规划
ZooKeeper 集群规模不是“节点越多越可靠”。规划时要同时看可容忍故障数、写入确认成本和故障域分布。多数业务在 3 节点与 5 节点之间选择:前者成本低,后者可多容忍一次故障,但会增加资源、网络和运维开销。
学习目标
- 根据节点数计算 quorum 与可容忍故障数
- 在三节点和五节点方案之间做出有依据的选择
- 把 ZooKeeper 成员分散到合理的主机与故障域中
先用多数派公式确定容错上限
对奇数个投票成员 ,法定人数为 ,最多可同时容忍 个成员不可用。三节点可容忍 1 个故障,五节点可容忍 2 个故障。
for n in 3 5; do
  quorum=$((n / 2 + 1))
  tolerated=$((n - quorum))
  printf 'nodes=%d quorum=%d tolerated_failures=%d\n' "$n" "$quorum" "$tolerated"
done
预期输出:
nodes=3 quorum=2 tolerated_failures=1
nodes=5 quorum=3 tolerated_failures=2
偶数个投票成员通常不会带来同等级别的额外容错。例如 4 节点仍需要 3 票,只能容忍 1 个故障,却比 3 节点多承担一个成员的资源和通信成本,因此没有特殊原因时优先选奇数规模。
三节点和五节点怎么选
| 方案 | quorum | 可容忍故障数 | 典型取舍 |
|---|---|---|---|
| 3 节点 | 2 | 1 | 成本低、写确认链路较短,适合大多数中小规模生产环境 |
| 5 节点 | 3 | 2 | 能承受两台成员同时不可用,但网络、机器与运维成本更高 |
ZooKeeper 的写请求由 Leader 发起提议并等待 quorum 确认。增加投票成员不会让写吞吐线性增长:Leader 需要向更多 Follower 广播事务,通信与处理开销会上升;提交只要求多数派确认,并不等待所有 Follower。五节点的主要价值是更高故障容忍,而不是“提升性能”。
如果业务只能容忍一次成员故障,且单个故障域已经足够稳定,三节点通常更经济。如果维护窗口、机架故障或可用区故障可能与另一台机器故障重叠,五节点更有余量。
节点要跨故障域分布
成员数量正确但部署在同一台宿主机、同一机架或同一故障域,仍可能被一次基础设施故障整体带走。规划时应优先保证投票成员的故障独立性,再考虑单机规格。
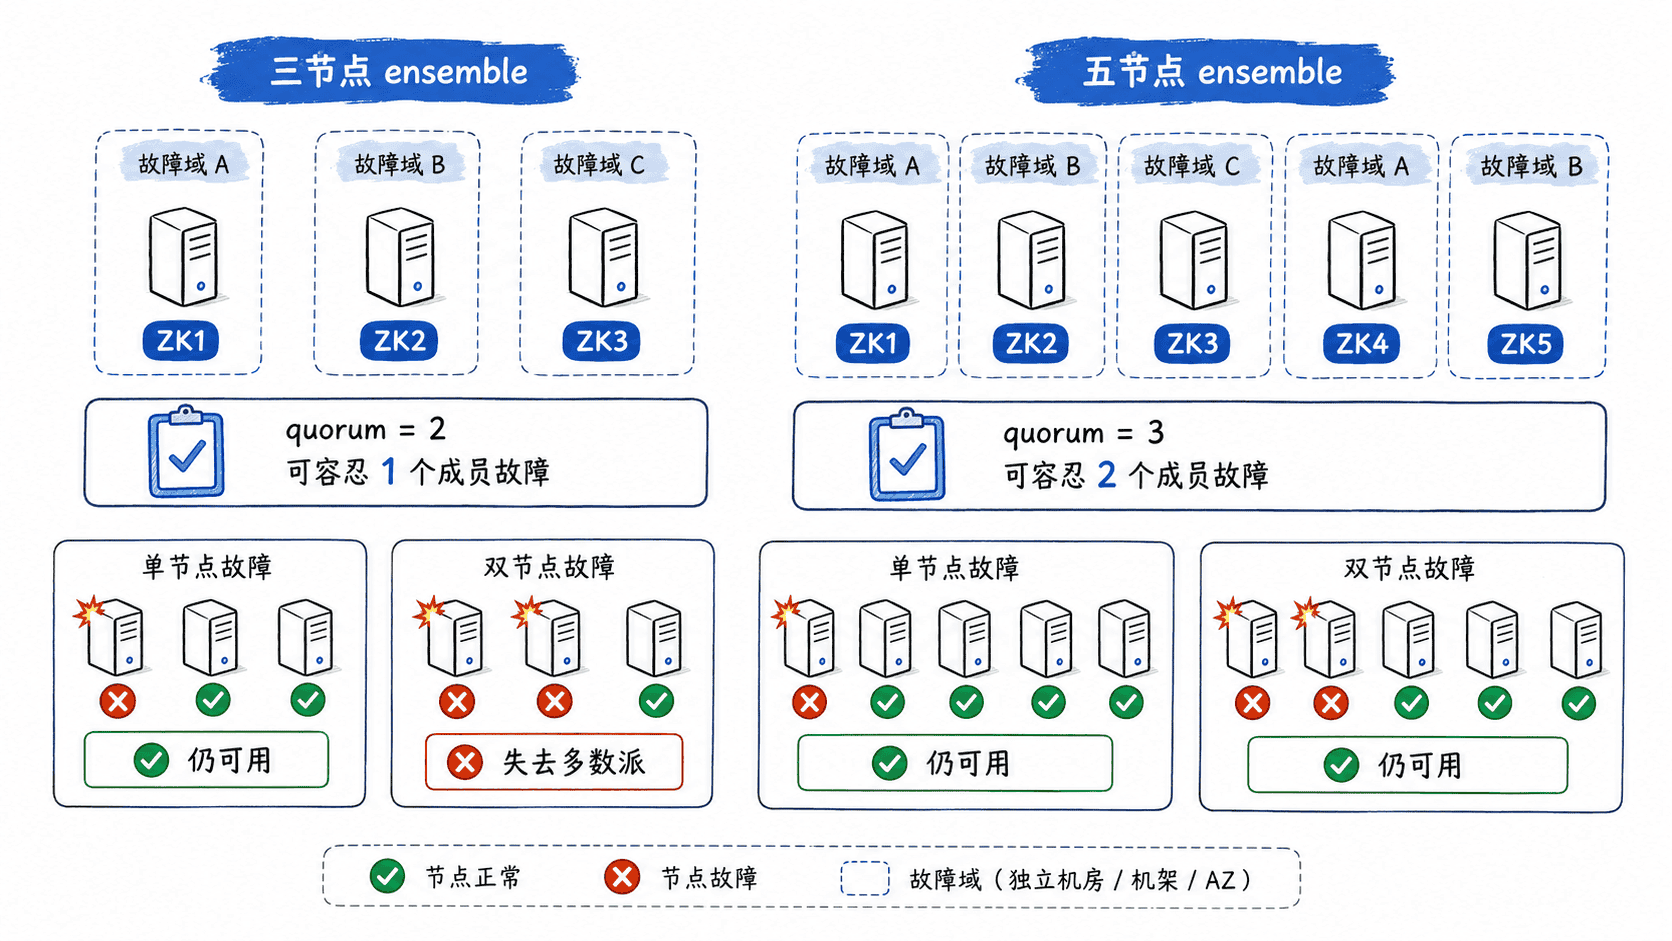
同一物理机上运行多个 ZooKeeper 进程不能等价替代独立成员,因为宿主机故障会同时失去多票。跨可用区部署时也要评估网络时延:成员间延迟过高会直接影响心跳、选举和写入确认。
单节点资源重点看磁盘与延迟
ZooKeeper 的数据集通常不大,但事务日志对稳定低延迟存储很敏感。生产节点应避免与高 I/O 抖动任务共用磁盘,并为事务日志、快照和操作系统留足空间。内存则要覆盖活跃数据与 JVM 开销,避免频繁 GC 影响心跳。
CPU 很少是最先出现的瓶颈,网络抖动和磁盘 fsync 延迟更常决定尾延迟。规划时不要只按“数据量”估算机器规格,还要结合峰值写入、Watcher 数量、连接数和可接受的 P99 延迟。
用故障场景验证方案
完成规划后,不要只看“共有几台机器”,而要逐个模拟可能的同时故障。三节点方案如果任何一台宕机后还要进行滚动维护,剩余两台再失去一台就会失去 quorum;五节点在同样场景下更有维护余量。
验证时至少覆盖单节点宕机、单故障域不可用和计划内滚动重启。只要某个合理场景会让存活投票数低于 quorum,就说明当前规模或故障域分布不足。最终目标不是堆节点,而是在可接受成本下,让多数派在预期故障范围内始终能够形成。