
Java 后端 / 系统课时
压测接口并分析瓶颈
压测接口并分析瓶颈
本课用一个可重复的 HTTP 基准场景压测 Spring Boot 接口,并把吞吐量、分位延迟、错误率与 CPU、内存、线程池、数据库连接池指标放在一起解读。完成后,你能区分“接口变慢”和“系统已饱和”,并给出有证据的优化方向。
学习目标
- 设计包含预热、稳定负载和验收阈值的压测场景
- 读取 P50、P95、P99 延迟、吞吐量与错误率
- 结合应用和数据库资源指标定位主要瓶颈
建立可比较的基准场景
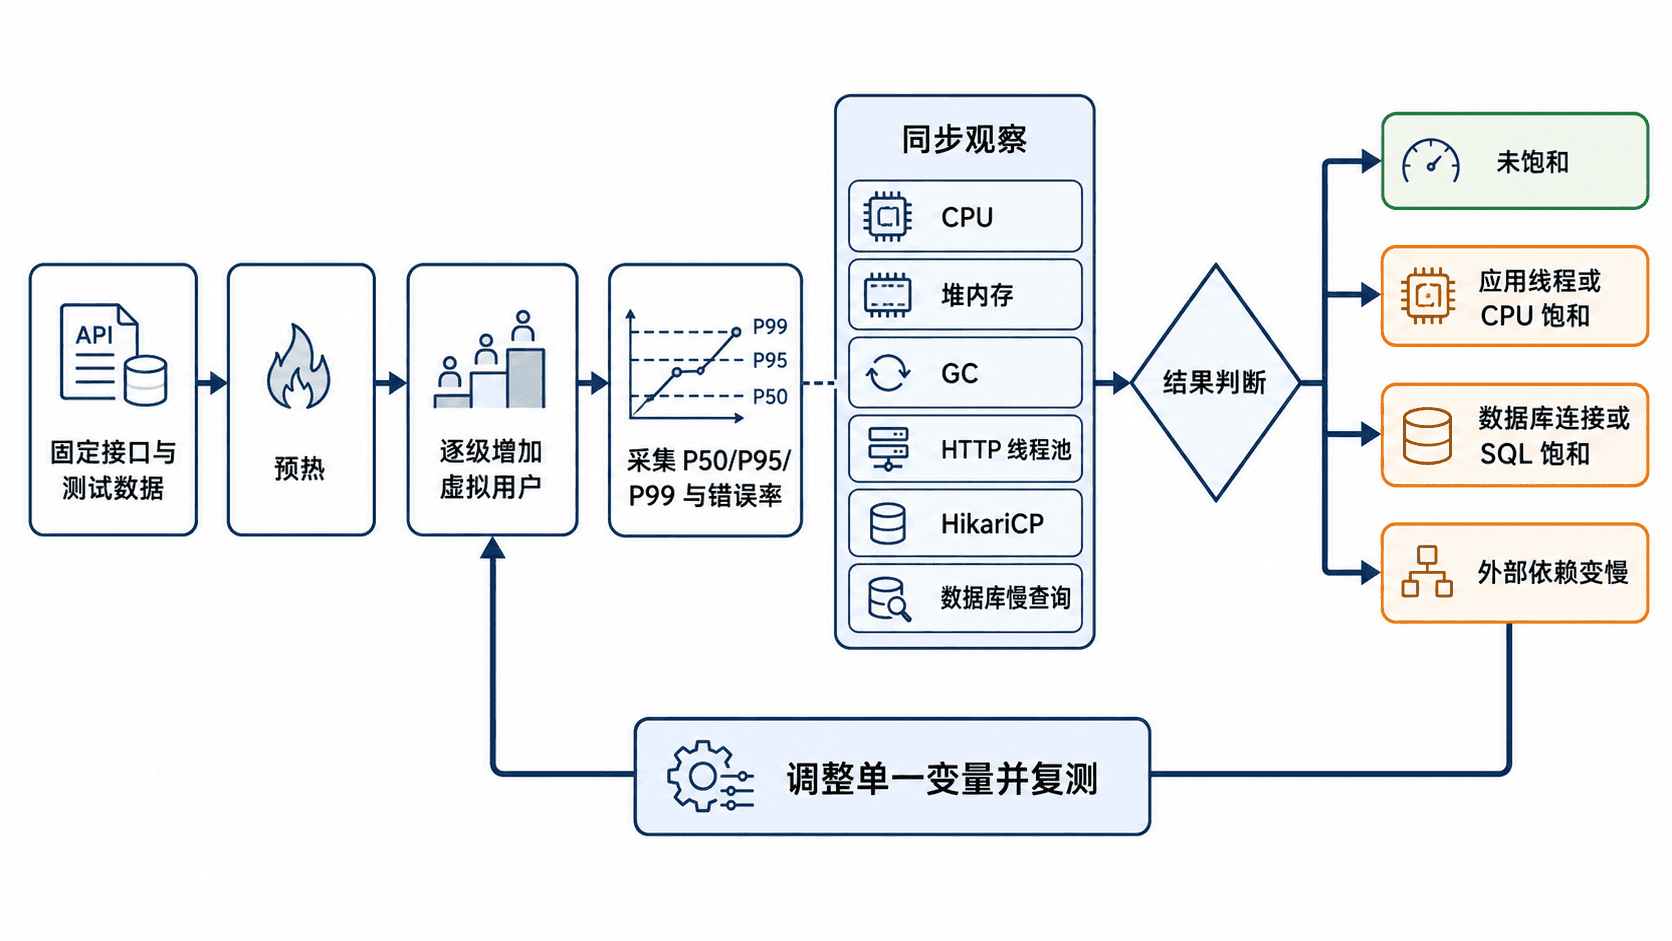
压测不是单纯把并发调高,而是固定请求、数据、环境和持续时间,再比较不同版本的结果。先选择一个代表真实业务的只读接口,例如 GET /api/products/{id},准备固定测试数据,并关闭会干扰结果的调试日志。
建议把一次基准测试分为三个阶段:短时间预热用于完成类加载和连接池初始化;稳定负载用于采样;结束后检查错误率与资源是否恢复。压测机应与服务端分离,否则客户端自身的 CPU 或网络可能先成为瓶颈。
使用 k6 执行分阶段压测
下面脚本先用 30 秒升到 20 个虚拟用户,再保持 1 分钟,最后降载。阈值要求 P95 小于 300 毫秒,失败请求比例低于 1%。请将 baseUrl 改为实际地址;端口可能不同。
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  stages: [
    { duration: '30s', target: 20 },
    { duration: '1m', target: 20 },
    { duration: '15s', target: 0 }
  ],
  thresholds: {
    http_req_duration: ['p(95)<300'],
    http_req_failed: ['rate<0.01']
  }
};

const baseUrl = __ENV.BASE_URL || 'http://localhost:<PORT>';

export default function () {
  const response = http.get(`${baseUrl}/api/products/1001`);

  check(response, {
    'status is 200': (res) => res.status === 200,
    'body is not empty': (res) => res.body.length > 0
  });

  sleep(1);
}
执行命令:
k6 run -e BASE_URL=http://localhost:<PORT> product-read.js预期输出:
checks.........................: 100.00%
http_req_failed................: 0.00%
http_req_duration..............: avg=<TIME> p(50)=<TIME> p(95)=<TIME> p(99)=<TIME>
http_reqs......................: <ID> requests
thresholds.....................: passed
实际延迟、请求数和端口会随机器与环境变化。若阈值失败,k6 会以非零状态退出,适合放入持续性能验证流水线。
读取关键指标
吞吐量说明单位时间内完成了多少请求,但它不能单独证明系统健康。并发继续增加而吞吐量不再上升,通常表示某个共享资源已经饱和。此时若延迟同时快速抬升,就进入了排队阶段。
P50 代表典型请求,P95 和 P99 更能暴露锁竞争、慢 SQL、GC 暂停或外部依赖抖动。错误率必须与延迟一起看:大量超时可能让“已完成请求”的平均延迟看似下降,却意味着服务质量已经恶化。
资源指标至少覆盖 CPU 使用率、堆内存与 GC、HTTP 工作线程、HikariCP 活跃连接、数据库执行时间。Spring Boot Actuator 与 Micrometer 可提供应用指标,数据库侧还应查看活动连接、锁等待和慢查询。
按证据判断瓶颈
当 CPU 长时间接近上限、吞吐量停止增长且运行队列增加时,优先检查计算热点、序列化和日志开销。若 CPU 不高但 HTTP 线程全部忙碌,常见原因是同步等待数据库或下游接口。
当 HikariCP 活跃连接接近最大值、等待连接时间升高,同时数据库慢查询增加时,先优化 SQL、索引和事务范围,不要直接扩大连接池。连接池过大可能把压力转移到数据库,反而放大锁竞争。
若堆内存呈锯齿上升并伴随频繁长时间 GC,应检查大对象、缓存上限和批量结果集。若应用资源正常而下游调用时间上升,则要把依赖超时、连接池和对方错误率纳入同一时间窗口。
形成可复现的结论
一次有效结论应写清版本、环境、数据规模、并发模型、持续时间、阈值和观测到的拐点。例如:“20 个虚拟用户时 P95 为 180 毫秒;提高到 80 个后吞吐量不再增长,HikariCP 等待连接显著增加,慢查询集中在商品明细 SQL。”这种表述才能指导下一步优化。
每次只调整一个主要变量,例如补充索引、缩短事务或减少返回字段,然后用同一脚本复测。若同时修改线程池、连接池和 SQL,就无法判断收益来自哪里。