
Java 后端 / 系统课时
定位 N+1 与慢查询
定位 N+1 与慢查询
本课建立一套从现象到根因的数据库性能排查路径。你将先用 SQL 日志确认查询次数,再通过抓取策略消除 N+1,最后结合执行计划和索引判断慢查询究竟卡在数据访问、排序还是回表。
学习目标
- 从 SQL 日志识别 N+1 查询和重复访问
- 使用
join fetch或@EntityGraph控制关联数据抓取 - 阅读执行计划,并用合适索引验证优化是否生效
先区分 N+1 与单条慢 SQL
N+1 通常表现为先查询一批主记录,再针对每条主记录各执行一次关联查询。若首页加载 20 个订单,日志中可能出现 1 条订单查询和 20 条明细查询;每条 SQL 都不慢,但累计往返和连接占用明显增加。
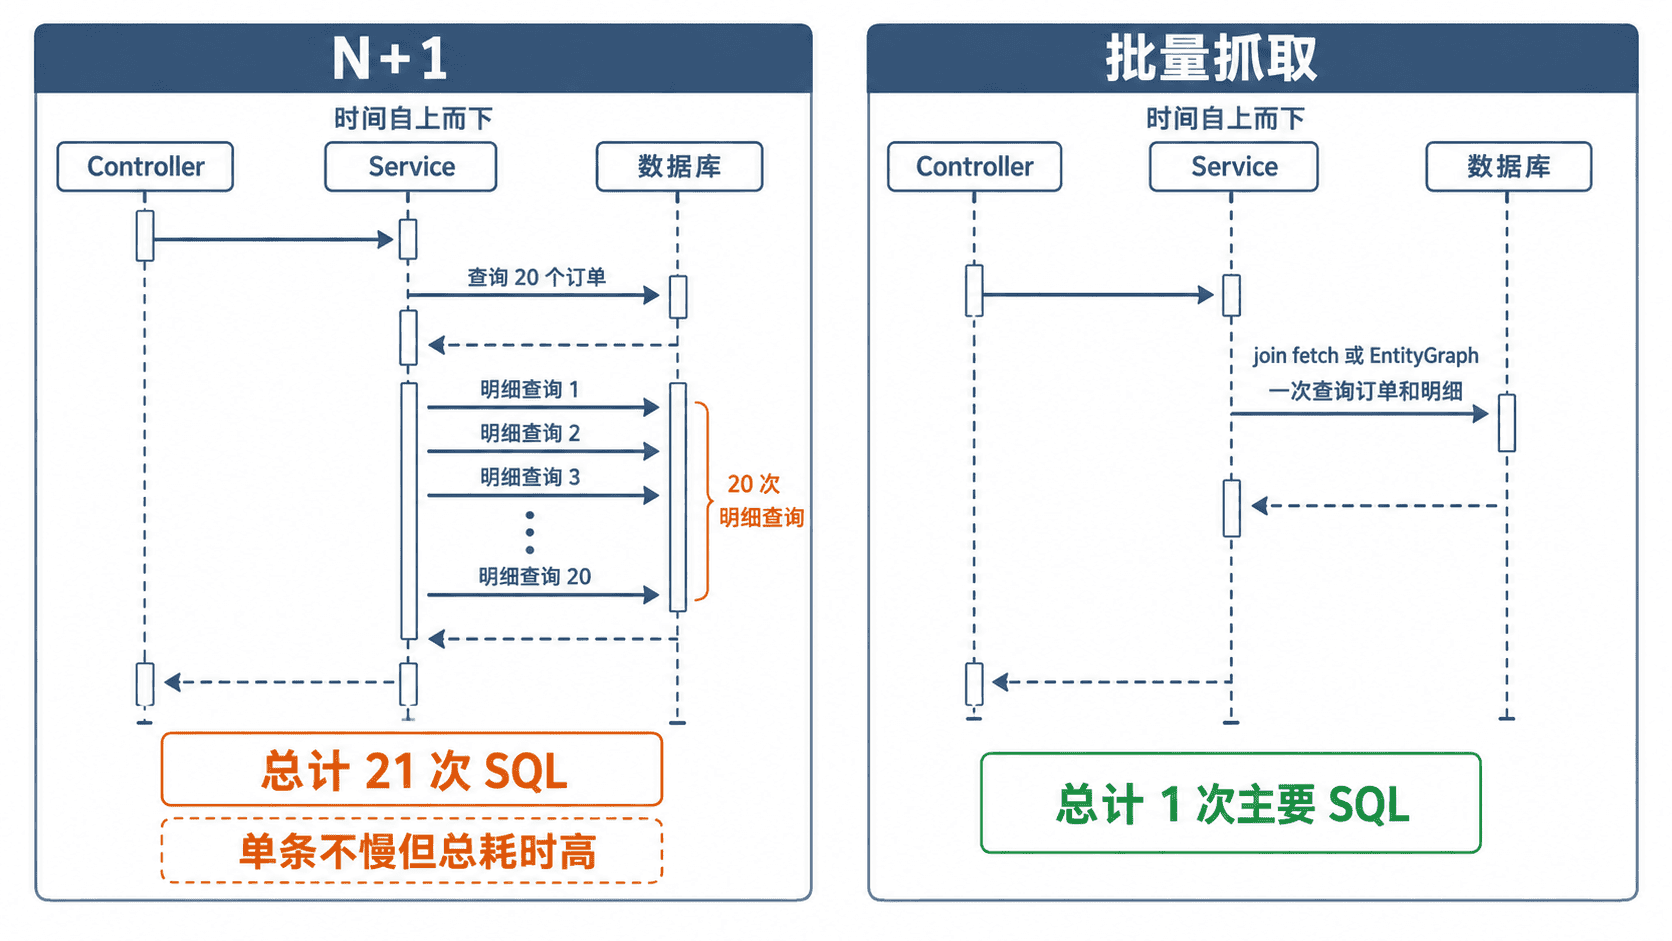
单条慢 SQL 则通常是查询次数不多,但某条语句扫描行数大、排序成本高、无法命中索引或锁等待时间长。两类问题的修复方式不同,因此第一步不是立即加索引,而是先确认“执行了多少次”和“哪一次最慢”。
打开必要的 SQL 观察信息
开发或测试环境可开启 SQL、绑定参数和 Hibernate 统计。以下配置会产生较多日志,不建议长期直接用于高流量生产环境。
spring:
  jpa:
    properties:
      hibernate:
        generate_statistics: true
logging:
  level:
    org.hibernate.SQL: debug
    org.hibernate.orm.jdbc.bind: trace
    org.hibernate.stat: debug
生效后,请对一个固定接口只发起一次请求,按请求追踪标识聚合日志,并统计同形 SQL 的出现次数。若同一关联查询仅参数不同却重复出现多次,优先怀疑懒加载触发的 N+1。预期结果
一次请求内可以看到 SQL 文本、绑定参数和 Hibernate 统计;同形关联查询的重复次数可被明确计数。生产环境更适合使用慢查询日志、APM 数据库追踪或采样日志,避免把所有 SQL 和敏感参数完整输出。
用抓取策略消除 N+1
假设 Order 与 items 是一对多关系,列表接口确实需要同时返回订单和明细,可以在仓库层明确声明抓取范围。下面是依赖现有实体和枚举的片段示例。
public interface OrderRepository extends JpaRepository<Order, Long> {

    @EntityGraph(attributePaths = "items")
    @Query("select distinct o from Order o where o.status = :status")
    List<Order> findWithItemsByStatus(@Param("status") OrderStatus status);
}
该片段依赖项目中已定义的 Order、OrderStatus 和 items 关联。调用该方法后,验证重点不是 SQL 文本必须完全一致,而是一次业务请求不再为每个订单单独查询明细。预期结果
查询次数从“1 条订单 SQL + N 条明细 SQL”下降为固定次数,常见情况为 1 条带关联抓取的 SQL。join fetch 和 @EntityGraph 都应按用例使用,不要把所有关联永久改成 EAGER。全局急切加载会让无关接口也读取大量数据,并可能造成笛卡尔积、重复行和分页失真。分页查询一对多集合时,通常先分页查询主键,再按主键批量抓取明细更稳妥。
用执行计划定位慢 SQL
以 PostgreSQL 为例,先为常见筛选和排序建立联合索引,再执行带实际运行信息的执行计划。索引列顺序要匹配主要过滤条件和排序方式。
CREATE INDEX idx_orders_status_created_at
ON orders (status, created_at DESC);

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, customer_id, status, created_at
FROM orders
WHERE status = 'PAID'
ORDER BY created_at DESC
LIMIT 50;
预期结果
执行计划应优先出现 Index Scan 或 Index Only Scan,并显示使用 idx_orders_status_created_at。
实际 Planning Time、Execution Time、扫描行数和缓冲区命中值会因数据量与环境不同而变化。
阅读计划时重点看四项:实际返回行数与估算行数是否差距过大、是否出现大范围 Seq Scan、排序是否落盘、循环节点是否被重复执行很多次。若过滤条件选择性很低,即使存在索引,优化器仍可能选择顺序扫描,这不一定是错误。
建立可验证的优化闭环
性能优化必须用同一组请求和近似数据量做前后对比。建议记录查询次数、接口总耗时、目标 SQL 耗时、扫描行数和返回行数,避免只凭“感觉更快”验收。排查顺序可以固定为:
- 复现单个请求并统计 SQL 次数,先判断是否为 N+1
- 找出耗时最高或重复最多的 SQL,保留绑定参数
- 对慢 SQL 执行实际执行计划,确认扫描、连接、排序和循环节点
- 根据用例调整抓取策略、查询条件或索引
- 使用相同数据和请求重新测量,并检查是否引入分页错误、重复数据或写入成本上升
索引不是免费优化。每增加一个索引,写入、更新、存储和维护成本都会增加;只为高频且稳定的查询模式建立索引,并定期清理长期未使用的重复索引。