
Java 后端 / 系统课时
接入 Prometheus 与 Grafana
接入 Prometheus 与 Grafana
本课完成一条可运行的指标监控链路:Spring Boot 3 暴露 Prometheus 格式指标,Prometheus 定时抓取,Grafana 查询并展示吞吐、延迟、错误率以及 JVM、进程资源使用情况。
学习目标
- 为 Spring Boot 3 应用启用 Actuator 与 Prometheus 指标端点
- 使用 Docker Compose 启动 Prometheus 和 Grafana,并验证抓取状态
- 编写核心 PromQL,建立接口与资源监控面板
监控链路与指标模型
应用只负责记录计数器、计时器和仪表值,并通过 /actuator/prometheus 暴露当前样本。Prometheus 按固定周期拉取并保存时间序列,Grafana 再通过 PromQL 查询这些数据。三者职责分离后,应用重启不会影响监控查询方式,面板也不需要直接访问业务接口。
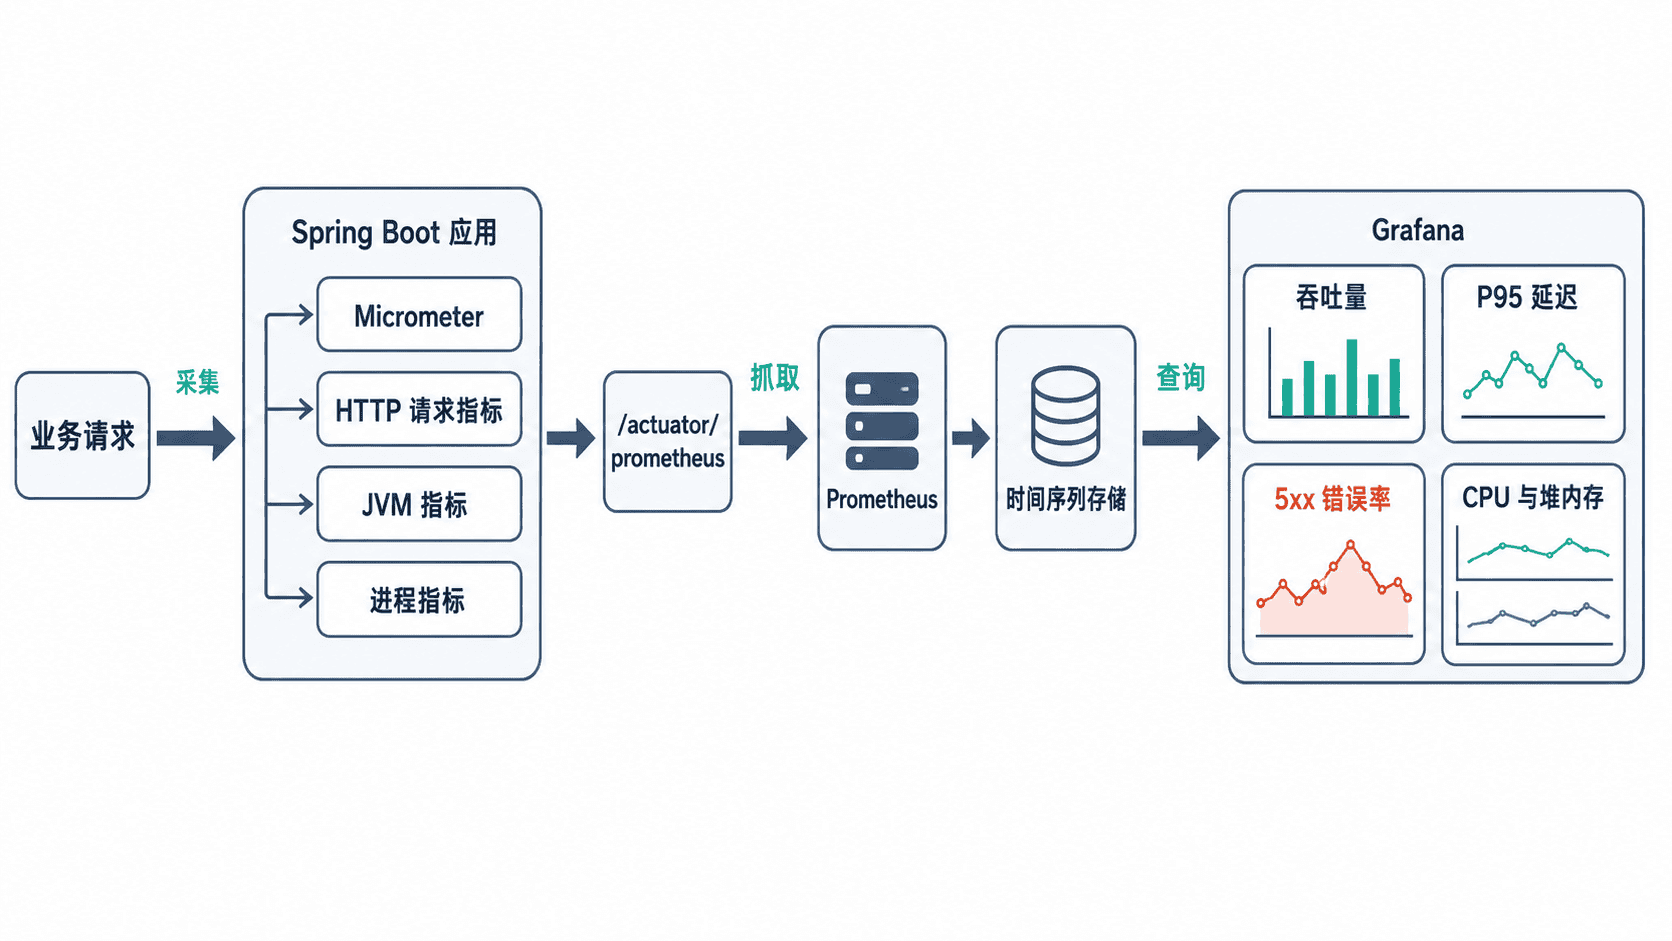
吞吐量通常由请求计数器的增长速率得到;平均延迟由累计耗时除以请求数得到;P95 延迟依赖直方图桶;错误率是 5xx 请求速率占总请求速率的比例。资源指标用于判断性能问题来自业务流量、垃圾回收、内存压力还是 CPU 饱和。
暴露 Prometheus 指标
以下为 Maven 依赖片段,应放入已有 Spring Boot 3 项目的 <dependencies>。版本由 Spring Boot 的依赖管理统一控制,不要单独为 Micrometer 指定不匹配的版本。
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
<dependency>
    <groupId>io.micrometer</groupId>
    <artifactId>micrometer-registry-prometheus</artifactId>
</dependency>
在 application.yml 中只暴露需要的端点,并为所有指标增加稳定的应用标签。启用 HTTP 请求直方图后,Prometheus 才能通过桶数据计算 P95、P99 等分位延迟。
spring:
  application:
    name: order-service

server:
  port: 8080

management:
  endpoints:
    web:
      exposure:
        include: health,info,prometheus
  metrics:
    tags:
      application: ${spring.application.name}
    distribution:
      percentiles-histogram:
        http.server.requests: true
启动应用并检查指标端点。
./mvnw spring-boot:run预期输出
<TIME>  INFO <ID> --- [order-service] ... Tomcat started on port 8080
<TIME>  INFO <ID> --- [order-service] ... Started <APPLICATION_CLASS>
时间、进程 ID 和启动类名会因环境而不同。另开终端请求指标端点:
curl -s http://localhost:8080/actuator/prometheus | grep -E '^# (HELP|TYPE) (http_server_requests_seconds|jvm_memory_used_bytes)' | head预期输出
# HELP http_server_requests_seconds ...
# TYPE http_server_requests_seconds histogram
# HELP jvm_memory_used_bytes ...
# TYPE jvm_memory_used_bytes gauge
若返回 404,先确认依赖已经重新加载、prometheus 已加入暴露列表,并检查管理端口或基础路径是否被修改。生产环境不要直接向公网开放全部 Actuator 端点,应通过独立管理网络、反向代理或 Spring Security 限制访问。
启动 Prometheus 与 Grafana
在项目旁创建 prometheus.yml。示例假设 Spring Boot 应用运行在宿主机的 8080 端口,而 Prometheus 运行在容器中。
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: spring-boot
    metrics_path: /actuator/prometheus
    static_configs:
      - targets:
          - host.docker.internal:8080
创建 grafana-datasource.yml,让 Grafana 启动时自动配置 Prometheus 数据源,避免依赖界面点击路径。
apiVersion: 1

datasources:
  - name: Prometheus
    type: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true
    editable: false
创建 compose.yml:
services:
  prometheus:
    image: prom/prometheus:v3.12.0
    container_name: prometheus
    ports:
      - "9090:9090"
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
    extra_hosts:
      - "host.docker.internal:host-gateway"

  grafana:
    image: grafana/grafana:13.1.2
    container_name: grafana
    ports:
      - "3000:3000"
    volumes:
      - ./grafana-datasource.yml:/etc/grafana/provisioning/datasources/prometheus.yml:ro
    depends_on:
      - prometheus
启动并查看容器状态:
docker compose up -d
docker compose ps
预期输出
NAME         IMAGE                          STATUS
grafana      grafana/grafana:13.1.2         Up <TIME>
prometheus   prom/prometheus:v3.12.0         Up <TIME>
访问 Prometheus 的 Targets 页面应看到 spring-boot 为 UP。若为 DOWN,优先检查目标地址、应用端口、容器到宿主机的网络以及指标端点是否需要认证。
创建核心 Grafana 面板
进入 Grafana 后选择已经预配置的 Prometheus 数据源,为同一个仪表盘添加以下查询。变量 $application 可绑定到标签值 order-service。
| 监控目标 | PromQL |
|---|---|
| 每秒请求数 | sum(rate(http_server_requests_seconds_count{application="$application"}[5m])) |
| P95 延迟 | histogram_quantile(0.95, sum by (le) (rate(http_server_requests_seconds_bucket{application="$application"}[5m]))) |
| 5xx 错误率 | 100 * sum(rate(http_server_requests_seconds_count{application="$application",status=~"5.."}[5m])) / clamp_min(sum(rate(http_server_requests_seconds_count{application="$application"}[5m])), 1) |
| 进程 CPU 使用率 | avg(process_cpu_usage{application="$application"}) * 100 |
| JVM 堆内存 | sum(jvm_memory_used_bytes{application="$application",area="heap"}) |
吞吐和错误率适合折线图,P95 延迟可使用毫秒单位,CPU 使用率使用百分比,堆内存使用字节自动换算。面板没有数据时,不要先怀疑 Grafana;应按“应用端点有数据 → Prometheus Target 为 UP → PromQL 可查询 → Grafana 数据源可用”的顺序定位。
验收与常见边界
持续请求一个业务接口后,吞吐曲线应上升;制造一次 5xx 响应后,错误率应短暂变化;增加堆内存占用时,JVM 面板应出现对应趋势。没有业务流量时,rate() 返回空值或接近零属于正常现象。
高基数标签会迅速增加时间序列数量。不要把用户 ID、订单 ID、完整 URL、异常消息等无限取值内容放入指标标签;应使用固定路由、状态码、方法和应用名等低基数维度。