
Java 后端 / 系统课时
划分接口、应用与基础设施层
划分接口、应用与基础设施层
本课把一个用户创建用例拆成接口层、应用层、领域层和基础设施层,明确每层能做什么、不能做什么,并通过可运行示例验证依赖方向,避免 Controller、Service 与 Repository 相互渗透。
学习目标
- 说清接口层、应用层、领域层和基础设施层的职责边界
- 按“外层依赖内层”的方向组织代码与接口
- 用一个完整用例检查跨层调用是否合理
先确定四层职责
分层不是把类放进不同目录,而是限制变化传播。HTTP 协议变化不应迫使领域对象重写,数据库从 MySQL 切换到其他实现时,也不应修改核心业务规则。
| 层次 | 主要职责 | 不应承担 |
|---|---|---|
| 接口层 | 接收请求、完成参数转换、调用用例、组装响应 | 编写业务规则、直接操作数据库 |
| 应用层 | 编排用例、控制事务边界、协调领域对象与外部端口 | 保存复杂业务判断、依赖具体中间件 |
| 领域层 | 表达实体、值对象、不变量、领域服务和仓储抽象 | 处理 HTTP、JSON、SQL 等技术细节 |
| 基础设施层 | 实现持久化、消息、缓存、第三方调用等适配器 | 决定业务流程和业务状态转换 |
推荐按业务模块组织,再在模块内部划层。例如用户模块可使用 user/api、user/application、user/domain 和 user/infrastructure,这样既保留业务聚合度,也能看清依赖边界。
固定依赖方向
接口层可以调用应用层,应用层可以调用领域层;基础设施层通过实现领域层或应用层定义的端口接入系统。领域层不反向依赖 Controller、JPA Repository 或消息客户端。
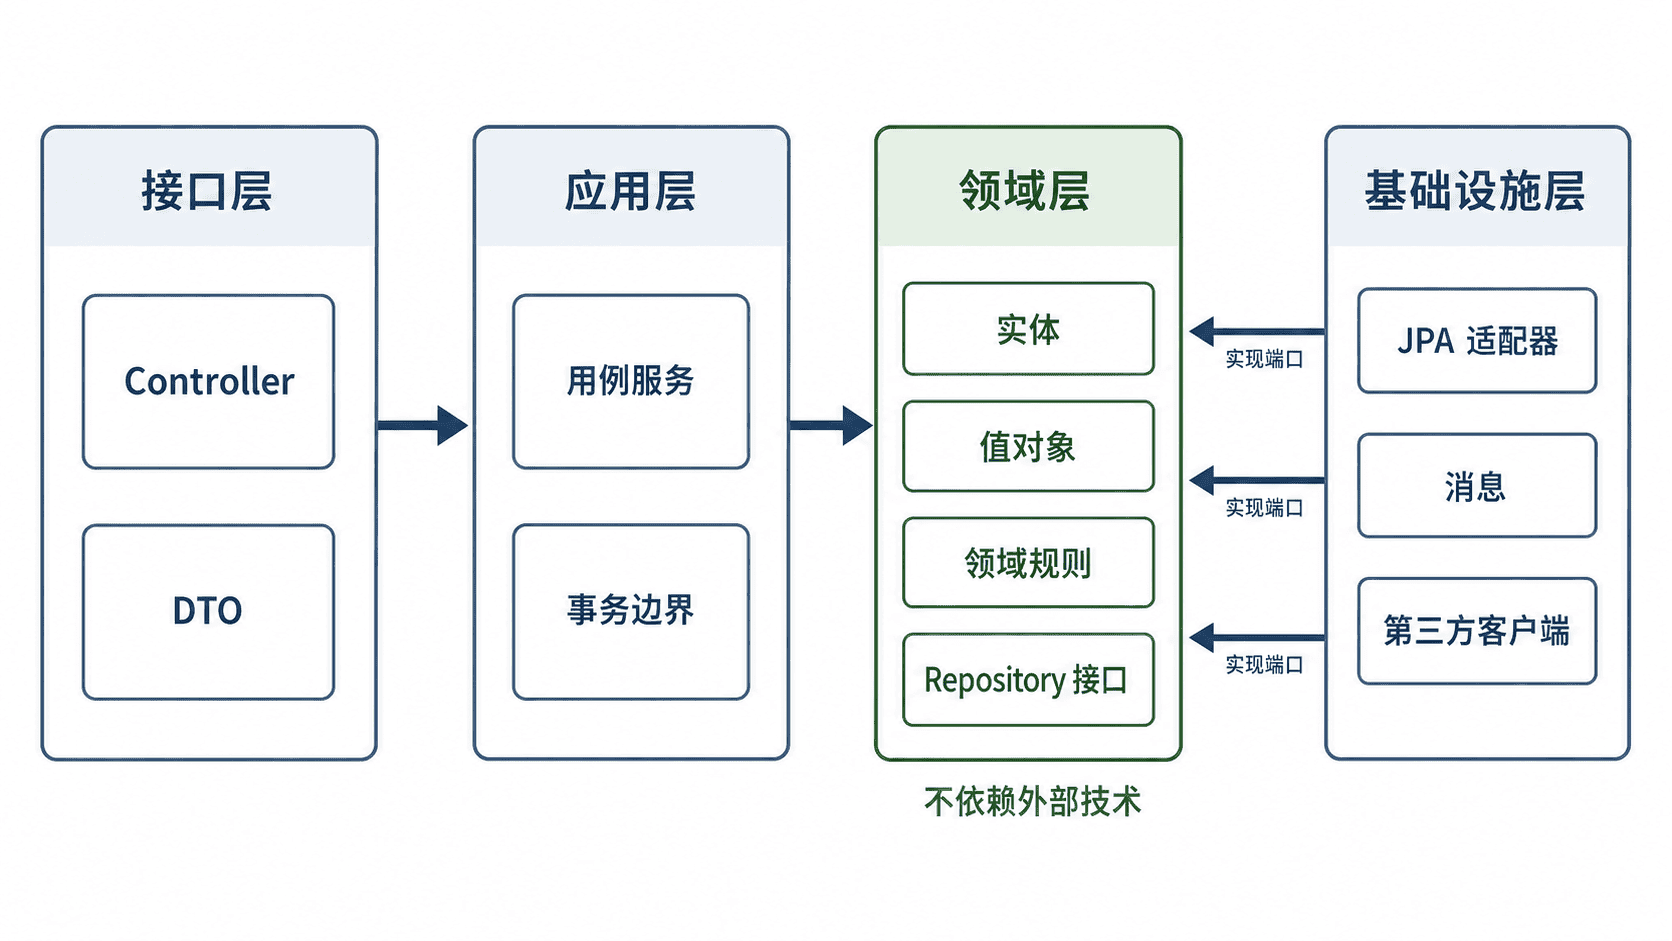
判断依赖是否正确,可以问一个简单问题:如果把数据库实现删除,领域模型和应用用例能否继续编译。若答案是否定,通常说明具体技术类型已经越过边界。
用一个创建用户用例验证
下面的单文件示例用普通 Java 模拟四层协作。真实 Spring Boot 项目可把 UserController 替换为 @RestController,把内存仓储替换为 JPA 适配器,但调用方向保持不变。
java
import java.util.LinkedHashMap;
import java.util.Map;

public class LayeredArchitectureDemo {
    public static void main(String[] args) {
        UserRepository repository = new InMemoryUserRepository();
        CreateUserService service = new CreateUserService(repository);
        UserController controller = new UserController(service);

        System.out.println(controller.create("U-001", "Alice"));
    }

    record CreateUserCommand(String id, String name) {
    }

    static final class UserController {
        private final CreateUserService service;

        UserController(CreateUserService service) {
            this.service = service;
        }

        String create(String id, String name) {
            // 接口层只负责把输入转换为应用层命令
            User user = service.handle(new CreateUserCommand(id, name));
            return "201 CREATED userId=" + user.id() + " name=" + user.name();
        }
    }

    static final class CreateUserService {
        private final UserRepository repository;

        CreateUserService(UserRepository repository) {
            this.repository = repository;
        }

        User handle(CreateUserCommand command) {
            // 应用层编排用例,不关心数据保存到哪里
            User user = User.create(command.id(), command.name());
            repository.save(user);
            return user;
        }
    }

    record User(String id, String name) {
        static User create(String id, String name) {
            if (id == null || id.isBlank()) {
                throw new IllegalArgumentException("id must not be blank");
            }
            if (name == null || name.isBlank()) {
                throw new IllegalArgumentException("name must not be blank");
            }
            return new User(id, name);
        }
    }

    interface UserRepository {
        void save(User user);
    }

    static final class InMemoryUserRepository implements UserRepository {
        private final Map<String, User> storage = new LinkedHashMap<>();

        @Override
        public void save(User user) {
            // 基础设施层实现仓储端口,可独立替换为数据库适配器
            storage.put(user.id(), user);
        }
    }
}
预期输出
text
201 CREATED userId=U-001 name=Alice示例中,创建规则位于 User,用例顺序位于 CreateUserService,存储方式位于 InMemoryUserRepository。任何一层都没有越权读取另一层的内部细节。
落地时检查越界
出现以下情况时,应优先调整边界,而不是继续增加工具类:
- Controller 直接注入 JPA Repository,并在接口方法里判断业务状态
- Application Service 到处拼装 SQL、HTTP 请求或消息体
- Domain 对象只有 getter/setter,所有规则都堆在 Service
- Infrastructure 通过回调决定订单、用户等核心对象的状态
- 两层互相注入,形成循环依赖
重构时先把业务规则移入领域对象,再为外部能力定义端口,最后由基础设施层实现端口。这样改动范围最小,也更容易进行单元测试。
按自己的节奏,确认真正理解。