
PostgreSQL / 系统课时
执行隔离场景性能压测
执行隔离场景性能压测
RLS 上线前不能只验证“看不到别人的数据”,还要确认在真实租户分布和并发下,隔离策略不会把延迟、吞吐或数据库资源推过可接受边界。本课用可重复的 A/B 压测比较无 RLS 基线与 RLS 方案,并把结果整理成可回归的上线门槛。
学习目标
- 设计只改变 RLS 开关、其余条件尽量一致的基线与实验组
- 用
pgbench构造多租户并发负载并执行阶梯加压 - 根据吞吐、延迟和资源增量制定上线阈值与回归标准
固定可比较的测试模型
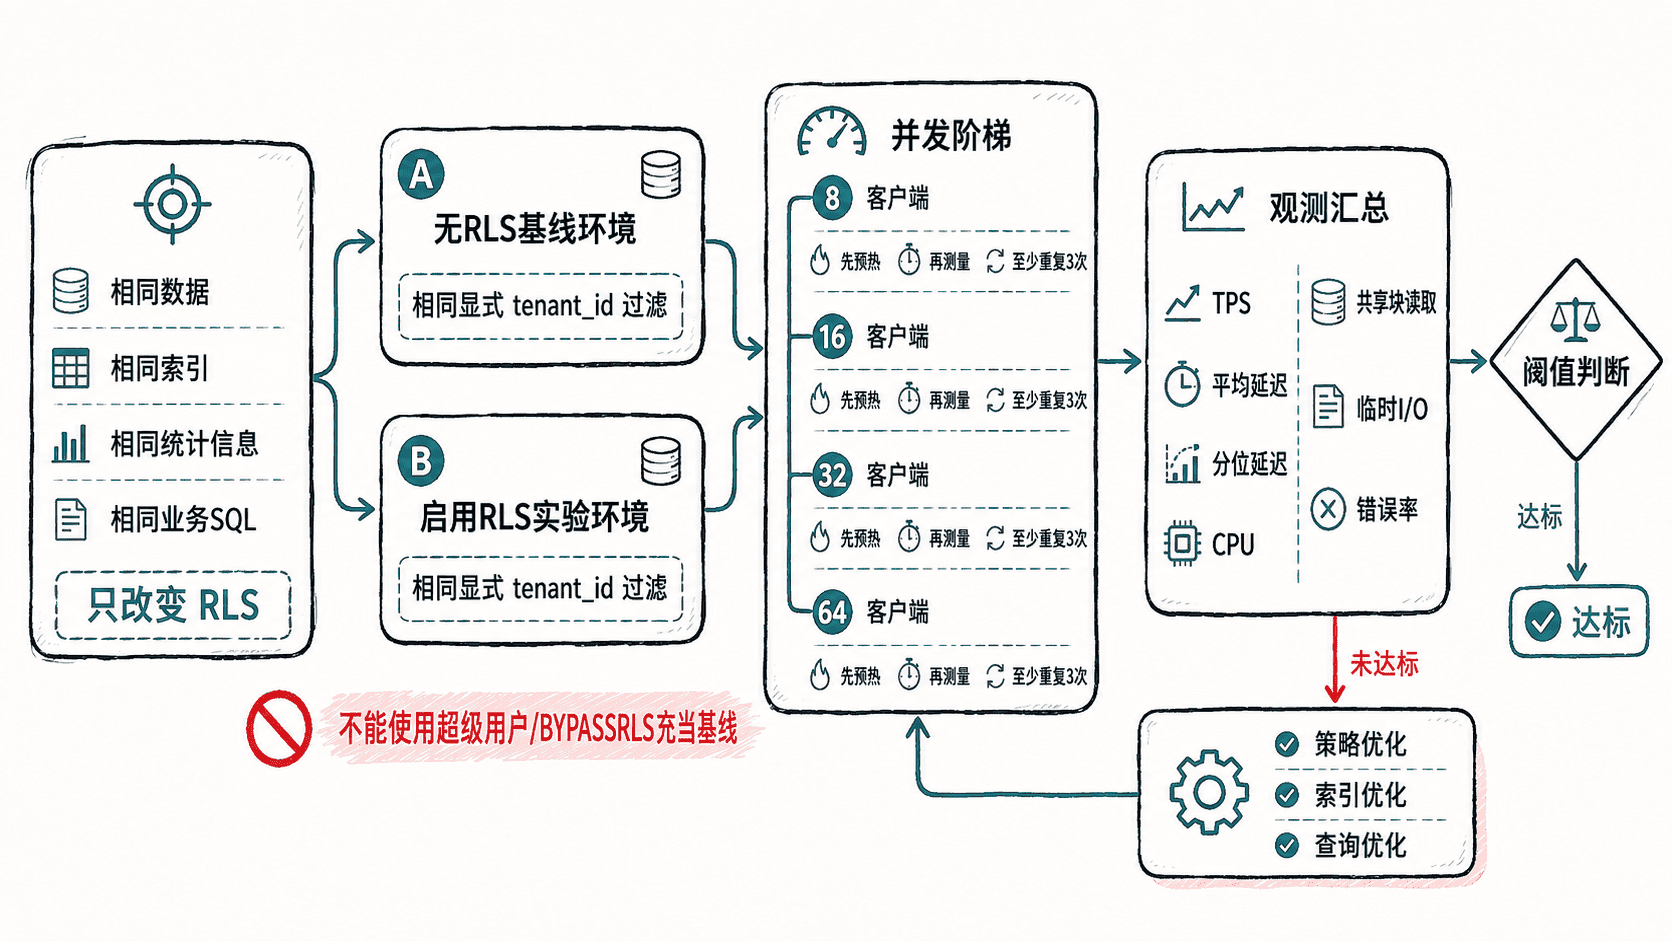
基线环境与 RLS 环境应使用相同 PostgreSQL 版本、数据量、租户分布、索引、统计信息、连接参数和机器规格。唯一核心差异是:基线表不启用 RLS,实验表启用目标策略。两边的业务 SQL 都显式带 tenant_id 条件,保证读取集合相同;RLS 环境再由策略做强制隔离。
不要用超级用户或 BYPASSRLS 角色作为“关闭 RLS”的基线,因为角色权限、会话参数和实际访问路径也随之变化,比较会混入额外变量。更稳妥的做法是在隔离压测环境准备两套等价数据库或 schema。
准备多租户负载脚本
下面的 pgbench 自定义脚本每笔事务随机选择一个租户,把租户上下文限制在当前事务,再执行同一条业务查询。示例依赖 orders(id, tenant_id, status, created_at);真实压测应替换为线上占比最高的核心读写路径,并保持基线和 RLS 两边完全一致。示例中的 random(1, 100) 是均匀分布,正式测试应按生产租户权重或回放数据改造租户输入。
\set tenant_id random(1, 100)
BEGIN;
SELECT set_config('app.tenant_id', :'tenant_id', true);

SELECT id, status, created_at
FROM orders
WHERE tenant_id = :'tenant_id'::bigint
  AND status = 'OPEN'
ORDER BY created_at DESC
LIMIT 20;

COMMIT;
预期结果
每个事务只使用一个 tenant_id;
租户上下文在 COMMIT 后失效;
基线环境与 RLS 环境执行相同业务 SQL,RLS 环境额外承担策略检查。
这里故意保留显式 tenant_id 条件:它代表正常的查询设计,而 RLS 是最后一道强制安全边界。这样测出的差值更接近“为隔离额外支付了多少成本”。
运行阶梯并发
把上面的内容保存为 tenant-read.sql,并准备 BASELINE_DATABASE_URL 与 RLS_DATABASE_URL 两个连接串。下面脚本对 8、16、32、64 个客户端逐级加压,每次先预热 30 秒,再测量 120 秒;同一并发级别重复三次,并交替 A/B 顺序以减小缓存和环境漂移造成的偏差。
set -euo pipefail

: "${BASELINE_DATABASE_URL:?missing BASELINE_DATABASE_URL}"
: "${RLS_DATABASE_URL:?missing RLS_DATABASE_URL}"

run_case() {
  local label="$1"
  local url="$2"
  local clients="$3"
  local repeat="$4"

  pgbench -n -f ./tenant-read.sql -c "$clients" -j 4 -T 30 "$url" >/dev/null

  pgbench -n -r -f ./tenant-read.sql \
    -c "$clients" -j 4 -T 120 "$url" \
    | tee "${label}-c${clients}-r${repeat}.log"
}

for clients in 8 16 32 64; do
  for repeat in 1 2 3; do
    if (( repeat % 2 == 1 )); then
      run_case baseline "$BASELINE_DATABASE_URL" "$clients" "$repeat"
      run_case rls "$RLS_DATABASE_URL" "$clients" "$repeat"
    else
      run_case rls "$RLS_DATABASE_URL" "$clients" "$repeat"
      run_case baseline "$BASELINE_DATABASE_URL" "$clients" "$repeat"
    fi
  done
done
预期输出
number of clients: <VALUE>
number of threads: 4
duration: 120 s
number of transactions actually processed: <VALUE>
latency average = <TIME> ms
tps = <VALUE> (without initial connection time)
<VALUE> 与 <TIME> 会随机器、数据量和并发级别变化。命令同时生成每轮日志文件,便于之后把相同并发级别的三次结果取中位数或稳定区间,而不是只看一次偶然值。
同步记录数据库资源
每一轮都要用同一个时间窗口记录数据库 CPU、连接数、共享块命中与读取、临时文件或临时块、锁等待和错误率;若压测包含写入,还应同时观察 WAL 量与事务冲突。延迟最好补充 p95、p99,不能只用平均值判断尾部抖动。
对每个并发级别,至少形成“基线值、RLS 值、相对变化”三列。RLS 增量可以用 (RLS - baseline) / baseline 计算;吞吐量则反向关注下降比例。不要把 5% 或 10% 当通用标准,最终阈值应来自系统已有 SLO、容量余量和峰值模型。
| 指标 | 重点观察 | 典型解释 |
|---|---|---|
| TPS | RLS 相对基线是否持续下降 | 可能存在策略计算或额外扫描 |
| 延迟 | 平均值与 p95/p99 是否同时恶化 | 尾延迟放大通常比平均值更早暴露问题 |
| CPU | 是否只在 RLS 组显著升高 | 关注复杂函数、子查询或重复策略判断 |
| 块读取/临时 I/O | 是否随并发加速增长 | 常指向索引、排序或扫描范围问题 |
| 错误率 | 超时、连接错误、事务失败 | 先区分容量瓶颈与策略本身 |
用压测结果决定是否上线
如果基线与 RLS 在所有并发级别都以相近斜率退化,优先检查普通查询、连接池和机器容量;如果差距只在启用 RLS 后出现,并随并发放大,应回到策略表达式和执行计划。如果仅大租户恶化,则要针对数据倾斜重新验证索引选择性和统计信息。
上线门槛应同时满足两类条件:隔离正确性必须零越权,性能指标必须在项目定义的延迟、吞吐、资源和错误率阈值内。把固定数据集、压测脚本、并发阶梯、观察窗口和阈值一并纳入回归测试,后续每次修改策略、索引或 PostgreSQL 版本时才能得到可比较的证据。