
自动化测试 / 系统课时
建立失败分类标准
建立失败分类标准
同一个“测试失败”可能来自产品代码、自动化脚本、运行环境或测试数据。没有统一分类时,缺陷会被来回转派,统计也失真。本节建立一套以证据和根因为核心的分类标准,并把分类所需证据固化到 Playwright 产物中。
学习目标
- 准确区分产品缺陷、测试缺陷、环境故障和数据问题
- 按固定证据顺序完成归类,避免只看报错文本下结论
- 用 Playwright 的 trace、截图和附件保留可复核证据
先定义四类根因边界
分类对象应是导致失败的第一根因,而不是最后看到的异常文字。比如页面定位器超时,既可能是产品没有渲染按钮,也可能是测试定位器过期,还可能是后端环境不可用;仅凭 TimeoutError 不能直接归类。
| 分类 | 判定标准 | 典型证据 |
|---|---|---|
| 产品缺陷 | 脱离自动化脚本后仍可复现,产品行为违反需求或契约 | 手工复现、接口返回错误、页面状态与需求不符 |
| 测试缺陷 | 产品行为正确,但测试实现、定位器、等待方式或断言假设错误 | 修改测试代码后恢复,产品无对应异常 |
| 环境故障 | 测试代码与数据正常,但运行基础设施或依赖不可用 | 浏览器启动失败、网络中断、依赖服务不可达、磁盘不足 |
| 数据问题 | 环境和产品正常,但前置数据缺失、污染、过期或互相冲突 | 夹具缺失、账号状态错误、并行用例使用同一数据 |
最终统计应只选一个主分类。多个因素同时存在时,把直接根因作为主分类,其余因素写入备注;证据不足时先保持“待分类”,不要为了报表完整而强行塞进四类之一。
按固定顺序做判断
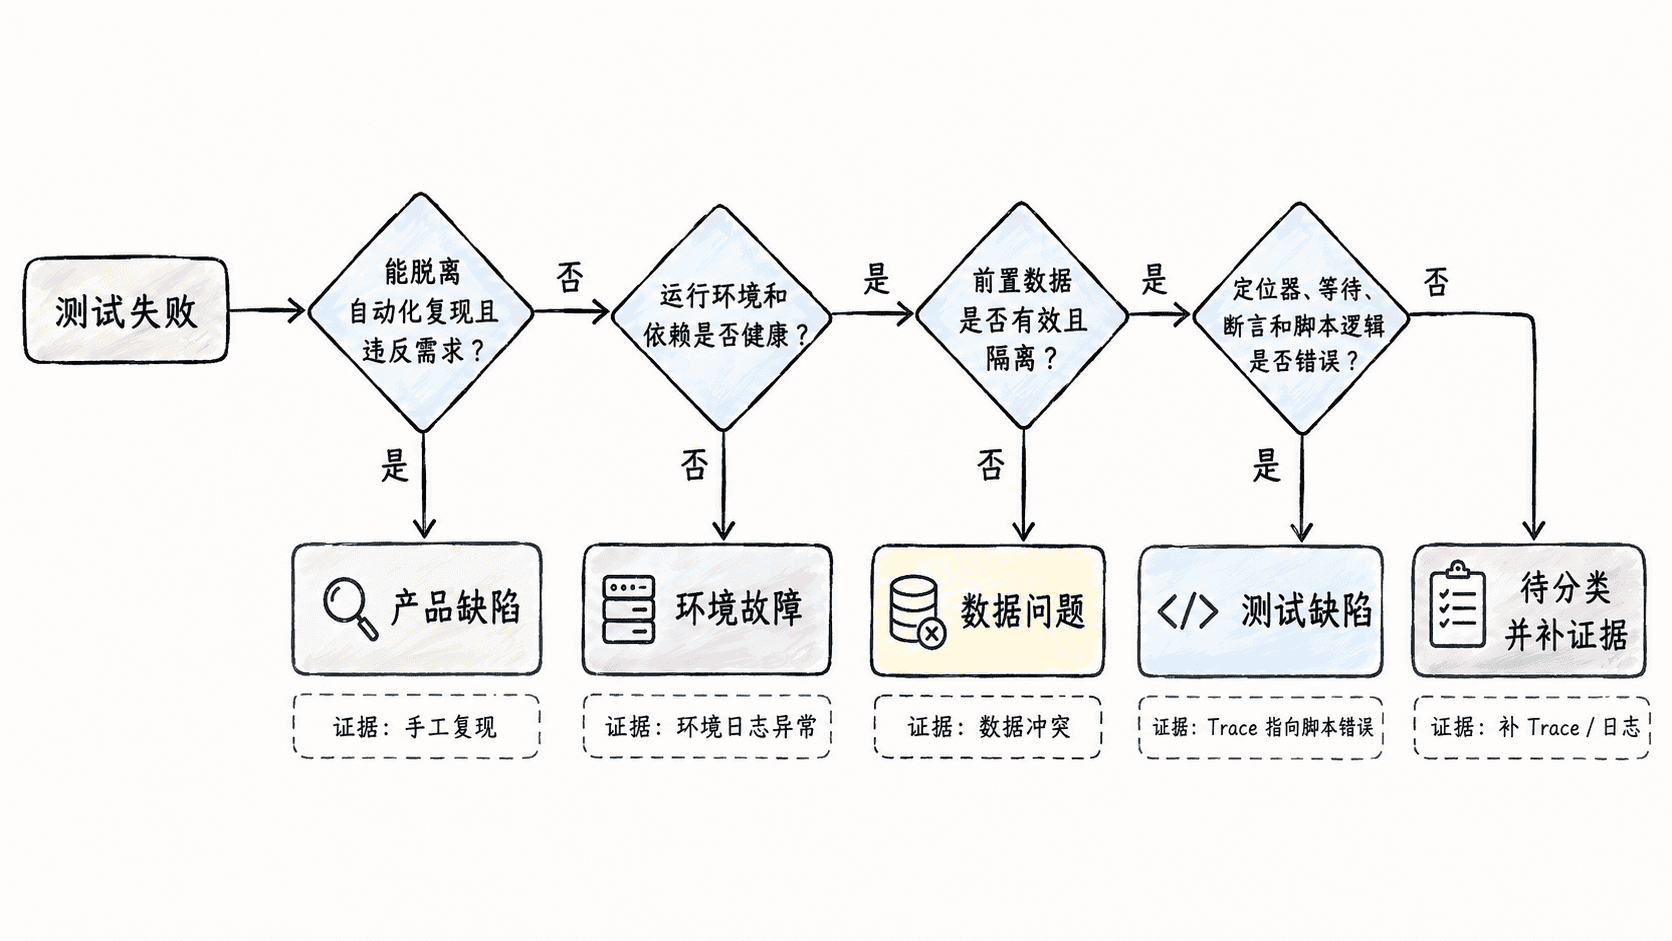
建议按下面的证据顺序处理一次失败:
- 先确认业务事实:页面或接口是否真的违反预期,并尝试脱离测试脚本复现。
- 再确认环境健康度:浏览器、Runner、网络、依赖服务和存储是否可用。
- 检查前置数据:账号、订单、权限、时间窗和唯一键是否满足用例前提。
- 最后检查自动化实现:定位器是否仍匹配、等待条件是否合理、断言是否写错、并发是否共享了可变状态。
这个顺序的价值在于先确认“产品究竟有没有错”,再排除外部条件,最后才修改测试。反过来先改脚本,容易把真实产品缺陷修成“测试通过”。
在 Playwright 中固化失败证据
分类必须能被复核,因此至少保留失败时的 trace、截图和必要附件。下面的 playwright.config.ts 会在失败时保留 trace、截图和视频,成功用例不会持续占用大量存储。
import { defineConfig } from '@playwright/test';

export default defineConfig({
  use: {
    trace: 'retain-on-failure',
    screenshot: 'only-on-failure',
    video: 'retain-on-failure',
  },
});
这属于配置示例,不直接产生固定控制台输出。验证方法是故意让一条测试失败后打开 HTML 报告:失败用例应能看到对应的 trace、截图和视频入口;如果 CI 对视频成本敏感,可以只保留 trace 与截图。
还可以把分类结果写成统一的数据记录,便于后续统计。下面是推荐的最小字段示例:
{
  "testId": "checkout-total",
  "failureClass": "TEST_DEFECT",
  "evidence": "定位器仍使用已删除的 data-testid=total-price",
  "owner": "qa-automation",
  "artifact": "trace.zip"
}这不是自动判定规则,而是归类后的记录格式。failureClass 只能使用团队约定的四个值之一;evidence 必须写可验证事实,不能写“看起来像环境问题”这类猜测。
处理最容易混淆的边界
产品缺陷和测试缺陷的分界,以产品行为是否违反要求为准。页面按钮改名但功能和需求同步更新,旧定位器失败属于测试缺陷;按钮按需求应该存在却没有渲染,则属于产品缺陷。
环境故障和数据问题的分界,以基础设施是否健康为准。数据库服务不可达导致取不到用户,是环境故障;数据库可用,但测试账号被别的用例删除,是数据问题。若数据初始化服务本身宕机,主分类仍应回到环境故障。
用复现结果关闭分类
归类之后必须用针对性的复验关闭问题:产品缺陷修复后重跑原测试并做业务复现;测试缺陷修复后验证产品未发生对应变化;环境故障恢复后在同一版本和同一数据下重跑;数据问题则重建独立数据并确认不会再次冲突。
当团队长期坚持“根因唯一、证据可复核、分类后有验证”,失败统计才会真正有用。此时你看到的产品缺陷比例、测试缺陷比例和环境故障趋势,才足以指导版本质量、脚本维护和基础设施治理。